
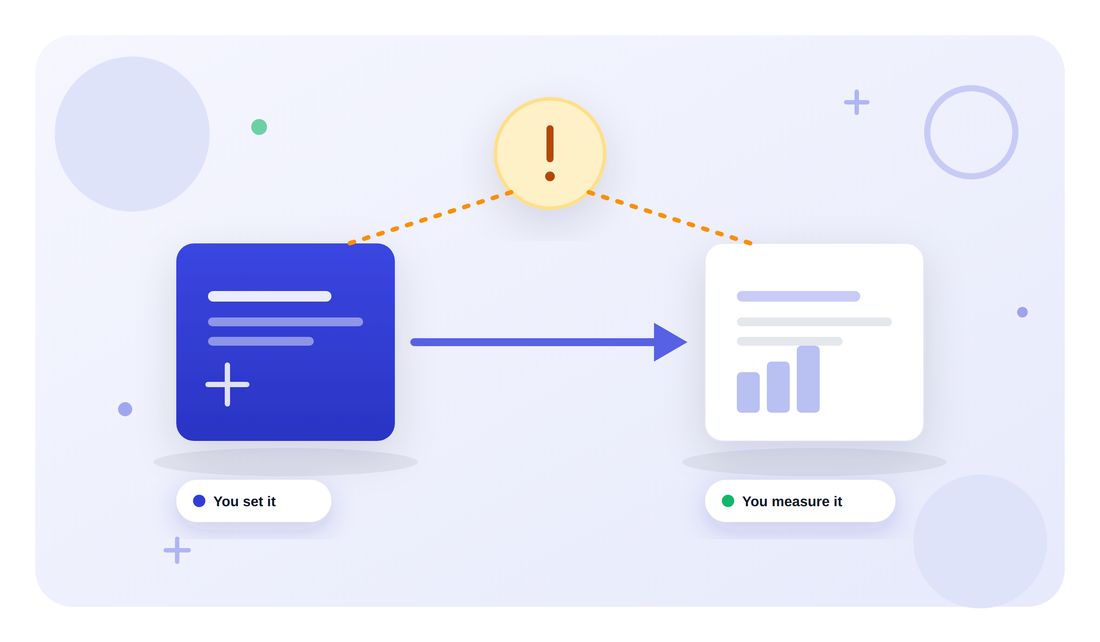
网络上几乎所有关于自变量和因变量的解释都是写给中小学生的。在这些搜索结果中名列前茅的,是一个针对儿童的政府网站、一个六年级数学复习大纲,以及一个百科全书条目。它们说的都是一回事:自变量是你改变的量,因变量是你测量的量。这固然没错,但当你坐下来撰写方法学章节(methods chapter)时,这套说辞就远远不够了。
接下来的内容是写给那些需要为自己的学术选择进行辩护的研究者的:如何可靠地识别这两类变量、同属于该章节的另外四种变量类型、为什么混杂因素会让你痛失分数,以及如何将这一切写成一段能够获得评审专家认可的学术文本。
<CTA title="撰写无懈可击的方法学部分" description="Jenni 帮助您从一开始就构建和起草每个章节,并附带相关的文献来源" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
什么是自变量与因变量?
自变量(independent variable)是指你操纵、分配或进行筛选的变量。它是假定的原因、输入项、首发因素。因变量(dependent variable)是你在之后进行测量的变量,用以观察它是否做出了反应。它是假定的结果,其数值被认为依赖于自变量,这也是其名称的由来。
国立大学(National University)的统计学资源对此给出了清晰的界定:自变量是由研究者操纵的,以确定它是否会导致因变量的变化,而因变量则是通过测量来观察其数值是否依赖于这一变化。
由此引申出两个值得熟记的常规惯例。在图表中,自变量位于横轴,因变量位于纵轴。在回归方程中,因变量是左侧的 y,而自变量是右侧的 x 项,这也是统计学家有时将其称为左侧变量(left-hand side variables)和右侧变量(right-hand side variables)的原因。
如何区分二者
面对不熟悉的研究课题时,请通过以下步骤进行推导,而不是凭空猜测。这大概需要一分钟时间,但却能纠正直觉失效的情况。
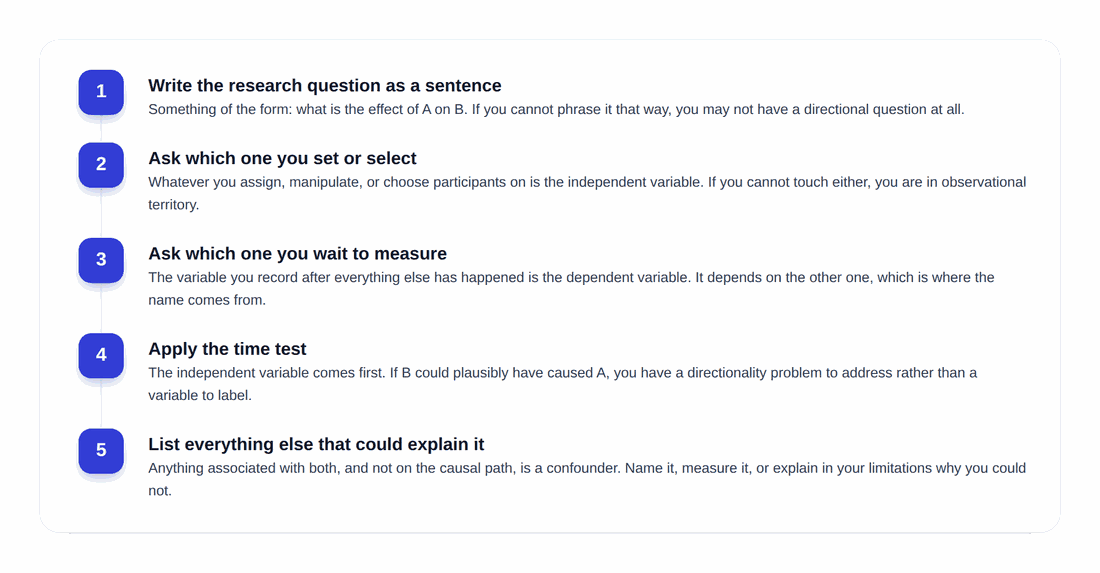
将研究问题写成一个句子。 尽量采用“A 对 B 的影响是什么”的形式。如果你无法用这种方式来表述,说明你可能没有一个方向性的问题,这本身也是需要注意的重要一点。
问问自己哪个是设定或筛选的。 凡是根据其来分配、操控或筛选参与者的,都是自变量。在实验中,由你来设定它;在观察性研究中,你筛选它,或者仅仅是记录它的自然发生。
问问自己哪个是留待最后测量的。 在其他所有事情发生之后你才记录的变量就是因变量。
应用时间检验法。 自变量在先。如果 B 极有可能引起 A,那么你面临的不是变量命名问题,而是方向性问题,这应该写入你的局限性(limitations)中。
列出可能解释结果的其他所有因素。 任何与这两个变量都相关、但又不在它们之间因果路径上的变量,都是混杂因素(confounder)。命名它,测量它,或者解释你为什么无法测量它。
应用于具体的研究问题,其示例如下:
研究问题 | 自变量 | 因变量 |
睡眠时间是否会影响考试成绩? | 前一晚的睡眠小时数 | 考试成绩 |
新的教学方法是否能提高记忆保持力? | 教学方法(新方法或标准方法) | 六周后的记忆力测试得分 |
咖啡因剂量是否会改变反应时间? | 以毫克为单位的咖啡因剂量 | 以毫秒为单位的反应时间 |
家庭收入能否预测预期寿命? | 家庭收入(系观察所得,而非人为设定) | 死亡年龄 |
反馈频率是否会影响工作满意度? | 每月主管反馈会议的次数 | 工作满意度量表得分 |
注意第四行。没有人可以分配某个人的收入。在这种情况下,标准的术语开始显得有些牵强,我们将在下文中对此做进一步讨论。
<ProTip title="🎚️ 设定还是测量:" description="如果你能设想将一个参与者分配到该变量的某一水平,它就是你的自变量。如果你唯一能做的是记录发生了什么,它就是你的因变量" />
方法学章节中的另外四种变量
在方法学章节中仅命名两个变量几乎总是显得不够完整。学术报告标准对此有着更高的期望,而评审专家也会特别寻找这些变量。

控制变量(Control variables)
控制变量是指你刻意保持恒定、使其无法变化从而不干扰对比的变量。在同一天的同一时间对同一房间内的所有人进行测试,可以控制环境和昼夜节律的影响。控制变量在分析中不作为效应进行研究,它们被排除在干扰因素之外。
混杂变量(Confounding variables)
混杂因素与你的自变量和因变量都相关,且不处于二者之间的因果路径上。这是颠覆结论的关键因素,在下文中有专门的章节对其进行论述。
调节变量(Moderating variables)
调节变量会改变关系的强度或方向。在 Baron 和 Kenny 的经典定义中,调节变量是影响自变量(或预测变量)与因变量(或效标变量)之间关系方向和/或强度的变量。如果你的干预措施对资深员工有效,而对新员工无效,那么经验就是调节变量。调节变量回答了“对谁有效”和“何时有效”的问题。
中介变量(Mediating variables)
中介变量处于因果路径之上,用以解释其发生机制。同样根据 Baron 和 Kenny 的定义,当一个变量在一定程度上解释了预测变量与效标变量之间的关系时,它就起到了中介变量的作用。如果睡眠通过影响注意力来影响考试成绩,那么注意力就是中介变量。中介变量回答了“如何起作用”的问题。
最容易让人混淆的是调节变量与中介变量的区别。调节变量是效应发生改变的条件,而中介变量是效应发生过程中链条上的一个环节。将二者混淆会改变你的整个分析逻辑和学术主张。
为什么混杂因素至关重要
混杂是导致相关性研究结果被推翻的根源,它有着精确而非含糊的定义。哥伦比亚大学的流行病学教学资源引用了 Last 的《流行病学词典》:混杂是指由于一个外部因素与暴露和结局均相关、但不属于暴露与结局之间因果路径的中间步骤,从而导致估算出的暴露对结局的效应发生扭曲。
根据俄勒冈州立大学的开放流行病学教科书,该定义产生了三个检验标准。要成为混杂因素,变量必须与暴露在统计学上相关、必须引起结局,且绝不能处于两者的因果路径之上。第三个条件是人们经常忽略的,该教科书对此给出了坦率的结论:处于因果路径上的变量是中介变量,而非混杂变量。对中介变量进行调整并不能净化你的估算值,反而会破坏你试图测量的效应。
实际案例:喝咖啡较多的人肺癌发病率较高。咖啡并不会导致肺癌。吸烟与喝咖啡相关,且会导致肺癌,但吸烟并不是从喝咖啡到癌症的任何因果路径上的一步。因此,吸烟是一个混杂因素,任何忽略该因素的分析都会产生一个看似真实、具有统计学显著性但完全虚假的结果。
<ProTip title="🕵️ 寻找混杂因素:" description="在收集任何数据之前,列出五个可能导致你的研究结局并且也与你的预测变量相关的变量。测量那些你可以测量的变量。对于无法测量的变量,将其写入你提前准备好的研究局限性部分" />
同一个变量可以担当不同的角色
变量本身并没有什么内在属性决定它是自变量还是因变量。它的角色取决于研究问题,而非变量本身。
当你询问睡眠是否会影响考试成绩时,睡眠时间是自变量。而当你询问焦虑是否会影响睡眠时,它就变成了因变量。在管理实践的研究中,工作满意度是因变量;而在员工流失的研究中,它则是自变量。这些标签仅仅描述了变量在论证逻辑中所处的位置。
这也是为什么方向性问题是一个真正的威胁,而非技术性琐碎问题。正如 BCcampus 研究方法教科书所阐明的那样,压力和规划不周是相关的,而处于压力之下可能和相反的情况一样,容易损害预先规划的能力,同时第三个变量(如尽责性)可能同时驱动这两个变量。在缺乏实验设计或强大的时间序列设计的情况下,你无法仅凭数据来解决这个问题,在讨论部分假装可以解决是失去读者信任最快的方式。
<ProTip title="🔀 方向检查:" description="反向书写你的因果主张,看看它是否依然听起来合理。如果是,你的设计必须证明该方向的合理性,而不是直接假定它成立" />
何时不宜使用“自变量”这一术语
在真正的实验中,使用这些术语是非常契合的,因为你确实可以独立于其他一切来设定自变量。但在观察性研究中,你无法做到这一点,一些方法学家甚至认为在这些场景下使用该词具有误导性。
BCcampus 的教科书直接针对相关性设计指出:在两个变量都不被认为引起另一个变量、且没有进行任何操纵的情况下,自变量和因变量这些术语不适用于此类研究。国立大学也提出了同样的观点。维基百科指出,一些学者更倾向于使用解释变量(explanatory variable),这恰恰是因为被视为自变量的量既不具有统计学独立性,也无法独立操纵。
请注意,这在目前是一个仍在讨论中的惯例,而非已确立的死板规则,许多出色的分析人员在处理观察数据时也会自然地使用“自变量”一词。实际的建议是遵循你所在的领域:流行病学称之为暴露(exposure)和结局(outcome),临床试验称之为终点(endpoint),回归分析文献称之为预测变量(predictor)和响应变量(response),而在相关性研究的心理学文献中则称之为预测变量和效标变量(criterion)。契合学术惯例表明你清楚自己是在哪种学术传统中进行写作。
如何在方法学章节中描述变量
这是每一个热门搜索引擎页面都会跳过的步骤,但它却是真正需要呈现在你的论文中的唯一步骤。
目前最好的规范来自 STROBE(观察性研究报告标准)。其第 7 条要求研究者明确定义所有的结局、暴露、预测变量、潜在混杂因素和效应修饰因子,并在适用时给出诊断标准。其细则补充了另外三个期望:每个变量的数据来源和评估方法、评估方法在不同组别和不同时间是否具有可比性,以及测量每个变量的组织层级(level of organization)。
将这些作为清单,这一段的撰写就会顺理成章。对于每个变量:它是什么、如何测量的、使用了什么工具、在什么层级测量,以及为什么将它包含在模型中。以下是实际操作中的具体呈现形式:
自变量为睡眠时间,以小时为单位进行测量,并在测试当天早晨使用单项问题进行自我报告。因变量为考试成绩,具体界定为标准化期末评估的百分制得分。先前的绩点(GPA)数据提取自学校官方记录,并作为协变量纳入,因为它既与睡眠习惯相关,又与学术表现相关,且不处于二者之间的因果路径上。
仅仅三句话,每一句都解答了评审专家本需要追问的问题。请注意,第三句话论证了纳入协变量的合理性,而不仅仅是罗列它,这就是汇报选择与论证选择合理性之间的区别——也是高质量方法学章节的关键所在。
<ProTip title="📋 保持汇报一致:" description="在整篇论文中使用完全相同的词汇来命名你的变量。在方法学中被称为“睡眠时间”的变量如果在结果部分被称为“睡眠质量”,就会被解读为两个不同的概念,严谨的评审专家会追问你测量的究竟是哪一个" />
如何使用 Jenni 起草你的变量部分
一旦你明确了变量,起草工作就变成了结构化的任务。
第一步:准确描述你的需求。 在提示词中指明研究名称、研究人群和变量。模糊的提示词只会产生通用的段落,无法通过导师的审查。
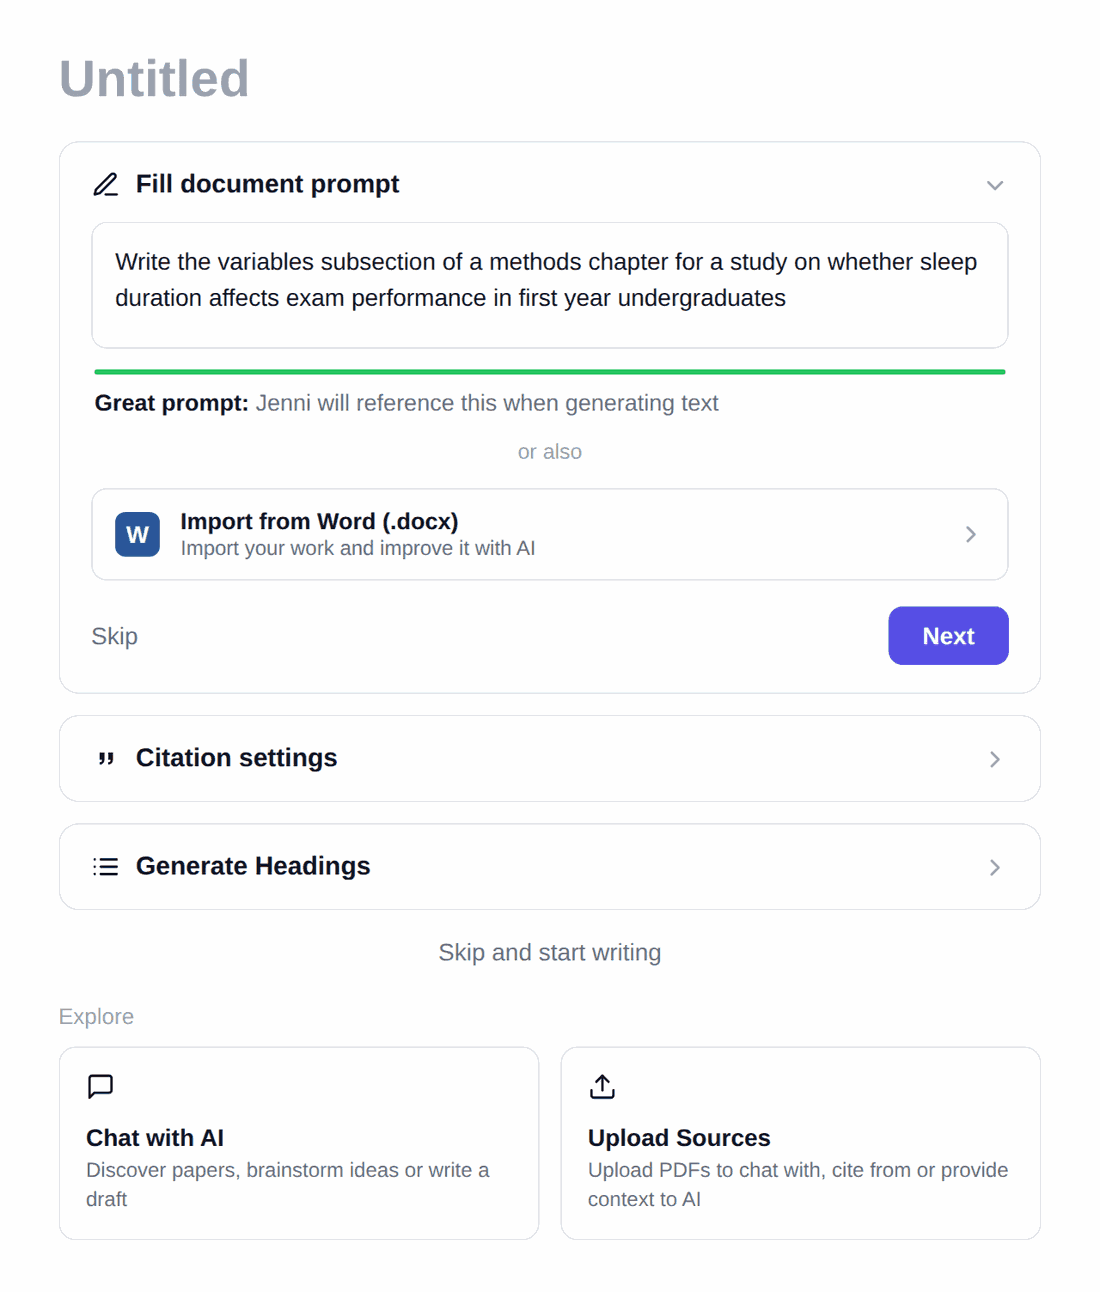
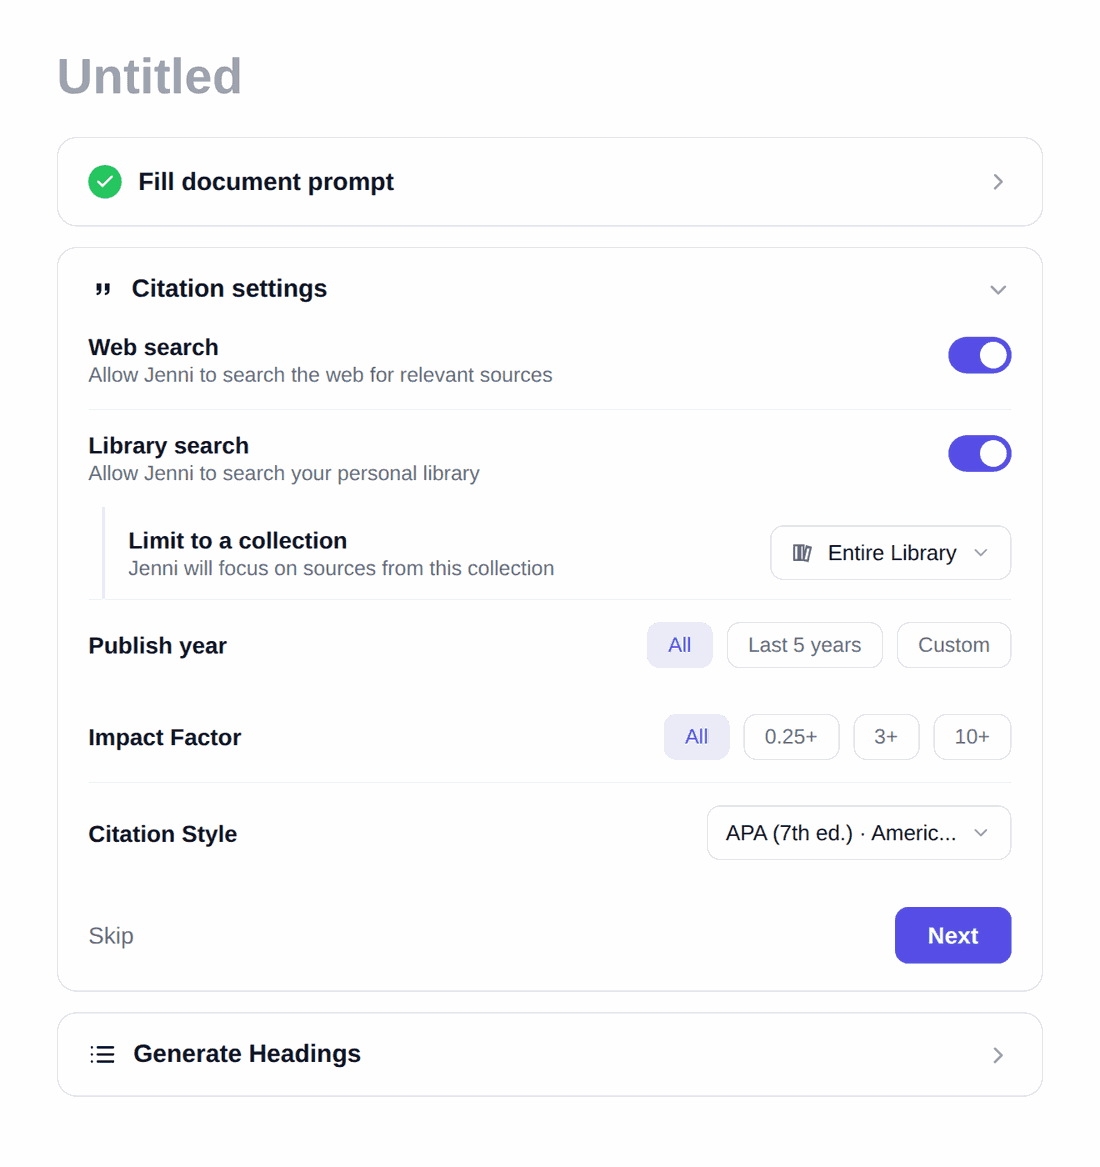
第二步:设定你的引文偏好。 选择你所在院系要求的引用格式。方法学章节通常含有大量的引用,因为每一个测量工具和成熟的量度都需要提供文献支撑。
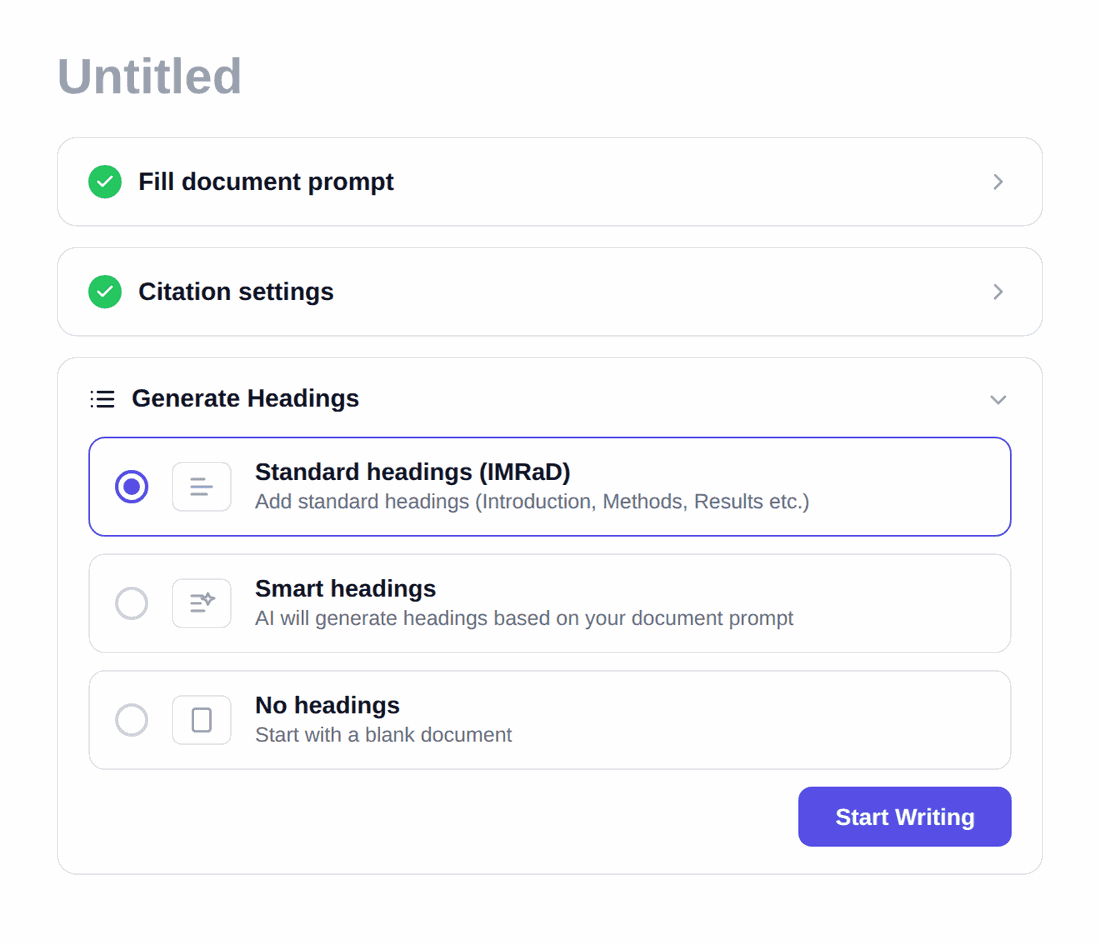
第三步:生成大纲标题。 在撰写正文之前,先构建方法学章节的框架,使变量子章节在设计、参与者和分析等部分的上下文中处于正确的位置。
第四步:逐个变量起草。 针对每个变量逐一对照 STROBE 清单:定义、测量、工具、层级和合理性论证。通过 DOI 将任何已发表工具的文献导入到你的文献库中,确保参考文献从一开始就是准确的。
第五步:在提交给导师之前进行检查。 对该章节运行 Claim Confidence(学术主张置信度检查),以捕获任何可能暗示了你的研究设计无法支持的因果关系的地方。在变量章节中,这通常表现为在应该使用“与……相关”的地方误用了“影响”。
界定好标签,论证水到渠成
正确命名自变量和因变量只是这其中最基础的部分。它的真正价值在于这个过程迫使你去直面核心问题:你的问题是否真的具有方向性、你是否能够为这个方向辩护、还有什么其他因素可以解释这个结果,以及你所使用的词汇是否契合你开展的研究设计。
<CTA title="自信地起草你的方法学章节" description="规划每个章节的结构,引用每个使用的工具,并检查你的学术主张是否契合你的研究设计" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
本周,针对你自己的研究问题进行这一五步检查,然后写出上文所示的三句话版本的段落。如果你无法写出任何一个变量的测量方式或工具,那么这就是你需要解决的下一个首要问题,然后再动笔撰写方法学章节的其他内容。同样的严谨态度贯穿于学术论文的每个部分,而它正是从这里开始的。