
在大多数情况下,因变量(dependent variable)和因变量/结果变量(outcome variable)是同一个事物的不同名称。两者都指代你所测量的对象,即你预期其数值会发生变化的对象,也就是等式左边的对象。如果你一直担心自己用错了词,那么你大概率并没有用错。
真正关键的地方在于它所传递的信号。你选择的词汇会告诉读者你是在哪种学术传统下进行写作的,并且在一种特定情况下,它还会向读者透露有关你研究设计的信息。这种情况非常值得理解,因为在这上面犯错是极少数能让评审专家真正叫停的术语错误之一。
<CTA title="使用你所在领域的专业词汇进行写作" description="Jenni 帮助您在长篇文档中保持术语的一致性" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
简而言之
因变量(Dependent variable)源自实验研究传统。它之所以被称为“因”(dependent),是因为它的值预期取决于你所操纵的自变量(independent variable)。
结果变量(Outcome variable)是一个更广泛、与研究设计无关的术语。它在分析中指代相同的位置,但并不暗示有任何因素被操纵来产生它。
因此,每一个因变量都是一个结果变量。但并非每一个结果变量都可以很自然地被称为因变量,原因将在下一节中进行阐述。
为什么“自变量”才是问题所在,而不是“因变量”
尴尬之处在于这一对词汇的另一侧。在真正的实验中,你设置的自变量是独立于其他所有事物的,这正是该名称所描述的特征。但在观察性研究中,你并没有这样做:你记录的收入、暴露程度或先前的成绩,都是它们原本就存在的状态。
一些方法论学者认为,在这些情况下,使用实验学派的词汇是极其不恰当的。BCcampus 的研究方法教科书在谈到相关性设计时指出,在既不认为任何一个变量导致了另一个变量,也没有操纵任何因素的情况下,自变量和因变量这两个术语并不适用于此类研究。美国国家大学(National University)的统计学资源也提出了同样的观点,指出相关性研究并不区分自变量和因变量,因为分析并不依赖于关系的方向。
因为这两个词通常成对出现,所以丢弃“自变量”往往也会顺带把“因变量”一起丢弃。这就是为什么在观察性工作中,“结果变量”会成为更自然的术语,而不是因为被测量变量本身具有什么特殊属性。
请注意,这是一种现行的惯例,而非一成不变的铁律。许多优秀的分析人员在处理观察数据时也会大方地使用“自变量”,没有人会因此判定你不及格。实际的指导原则是与你所在的学术领域保持一致。
<ProTip title="🧭 根据设计进行选择:" description="如果你分配或操纵了某些因素,因变量是准确的表述。如果你只是观察已经存在的事物,结果变量则更安全,并且不会带来你无法辩护的假设。" />
<ProTip title="🔤 明确定义它:" description="如果你使用协变量(covariate)这个词,请用一句话说明你的意思。有些读者会将其视为感兴趣的预测变量,而另一些读者则会将其视为被调整的干扰变量。" />
六种学术语言中的同一种事物
这一部分非常值得收藏,因为这些同义词集是特定于学术领域的,而且没有人会专门教你这些。
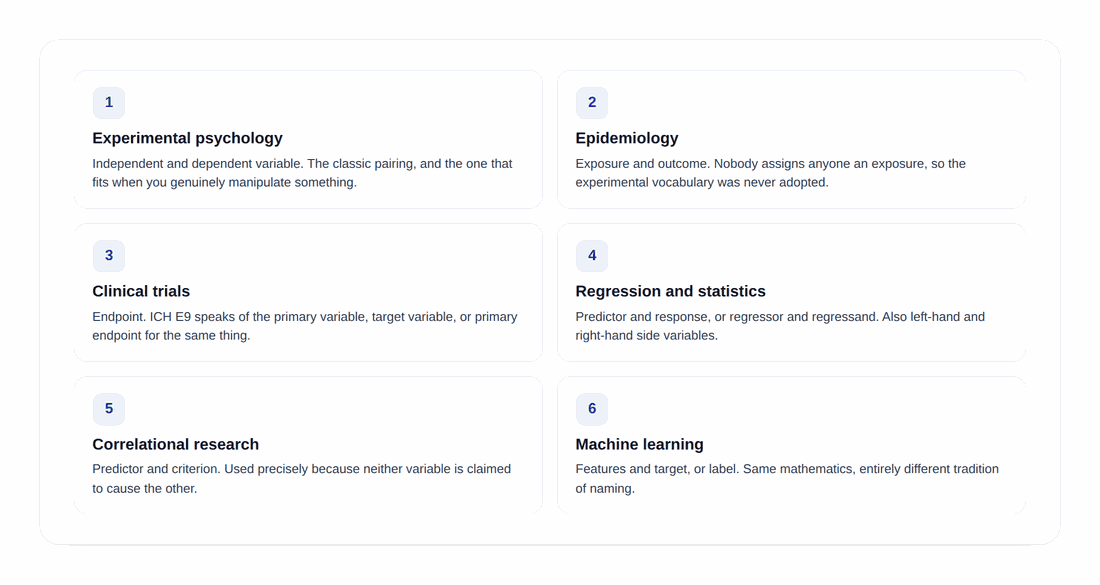
实验心理学使用自变量(independent variable)和因变量(dependent variable),这是经典的配对,适用于你真正操纵了某些因素的情况。流行病学使用暴露(exposure)和结果(outcome),因为没有人会给任何人分配某种暴露,而且实验词汇也从未被采用。临床试验习惯称之为终点(endpoints);ICH E9 在指代同一事物时使用了主要变量、目标变量或主要终点。回归与统计学使用预测变量(predictor)和响应变量(response),或自变量/回归量(regressor)和因变量/被回归量(regressand),通俗地称之为等式左边和右边的变量。相关性研究使用预测变量(predictor)和效标变量(criterion),选择这两个词正是为了表明不主张任何一个变量导致了另一个变量。机器学习使用特征(features)和目标(target)或标签(label),这在完全不同的命名传统下使用的是相同的数学原理。
你所测量的对象 | 预测它的对象 | 你会在哪里看到它 |
因变量(Dependent variable) | 自变量(Independent variable) | 实验心理学、教育学、大多数教科书 |
结果(Outcome) | 暴露(Exposure) | 流行病学、公共卫生、STROBE 报告规范 |
终点(Endpoint) | 治疗或干预(Treatment or intervention) | 临床试验、ICH 指导原则、CONSORT 报告规范 |
响应变量(Response variable) | 解释或预测变量(Explanatory or predictor variable) | 统计学与回归分析教材 |
效标变量(Criterion variable) | 预测变量(Predictor variable) | 心理测量学与相关性研究 |
目标或标签(Target or label) | 特征(Features) | 机器学习与数据科学 |
有一个词具有真正的歧义,在需要精确表达时应当避免使用:协变量(covariate)。一些文献将其视为自变量的同义词。而在协方差分析中,它通常指代被调整的连续型干扰变量,而不是研究中感兴趣的主变量。如果你使用它,请给它下一个定义。
<ProTip title="🏷️ 统一命名:" description="在文档开头选择一种词汇体系,此后绝不要混用。如果在方法论部分,上一段写着因变量,下一段写着结果变量,读起来就像是两个人写的一样。" />
你到底应该怎么写?
三个问题可以帮你决定。
你是否操纵或分配了任何因素? 如果是,那么“因变量”是精确且符合预期的。如果否,那么“结果变量”更安全。
你所在的学术领域怎么说? 这比个人喜好更重要。在流行病学论文中写“因变量”,比任何语法错误都更容易暴露你是一个“门外汉”。
你的报告规范怎么说? STROBE(观察性研究的报告规范)要求你定义结果、暴露、预测因子、潜在混杂因素和效应修饰因子。它从未提到因变量。如果你是按照某种规范进行写作,请使用该规范中的词汇。
<ProTip title="🧾 与标准匹配:" description="在选择术语之前,先检查你目标期刊所使用的报告标准。STROBE、CONSORT 和 PRISMA 各自都有自己的词汇表,与它们保持一致可以避免审稿人提出这方面的修改意见。" />
用同样的方式表达同样的事物
区别虽小,但它所要求的学术严谨性却不小。选择你所在领域使用的词汇,从摘要到讨论部分始终如一地应用它,并让你所选择的术语真实地反映你是否操纵了任何因素。
<CTA title="在整篇学位论文中保持词汇一致" description="在起草每个章节时使用一致的术语,使每个论点都与证据紧密相连" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
如果你仍在努力理清哪个变量是哪个,那么关于如何区分自变量和因变量的配套文章,涵盖了识别测试以及属于方法部分的其他四种变量类型。