AIのハルシネーション(幻覚)を減らす執筆方法:実証済みの実践的テクニック
成長の責任者
17分で読めます
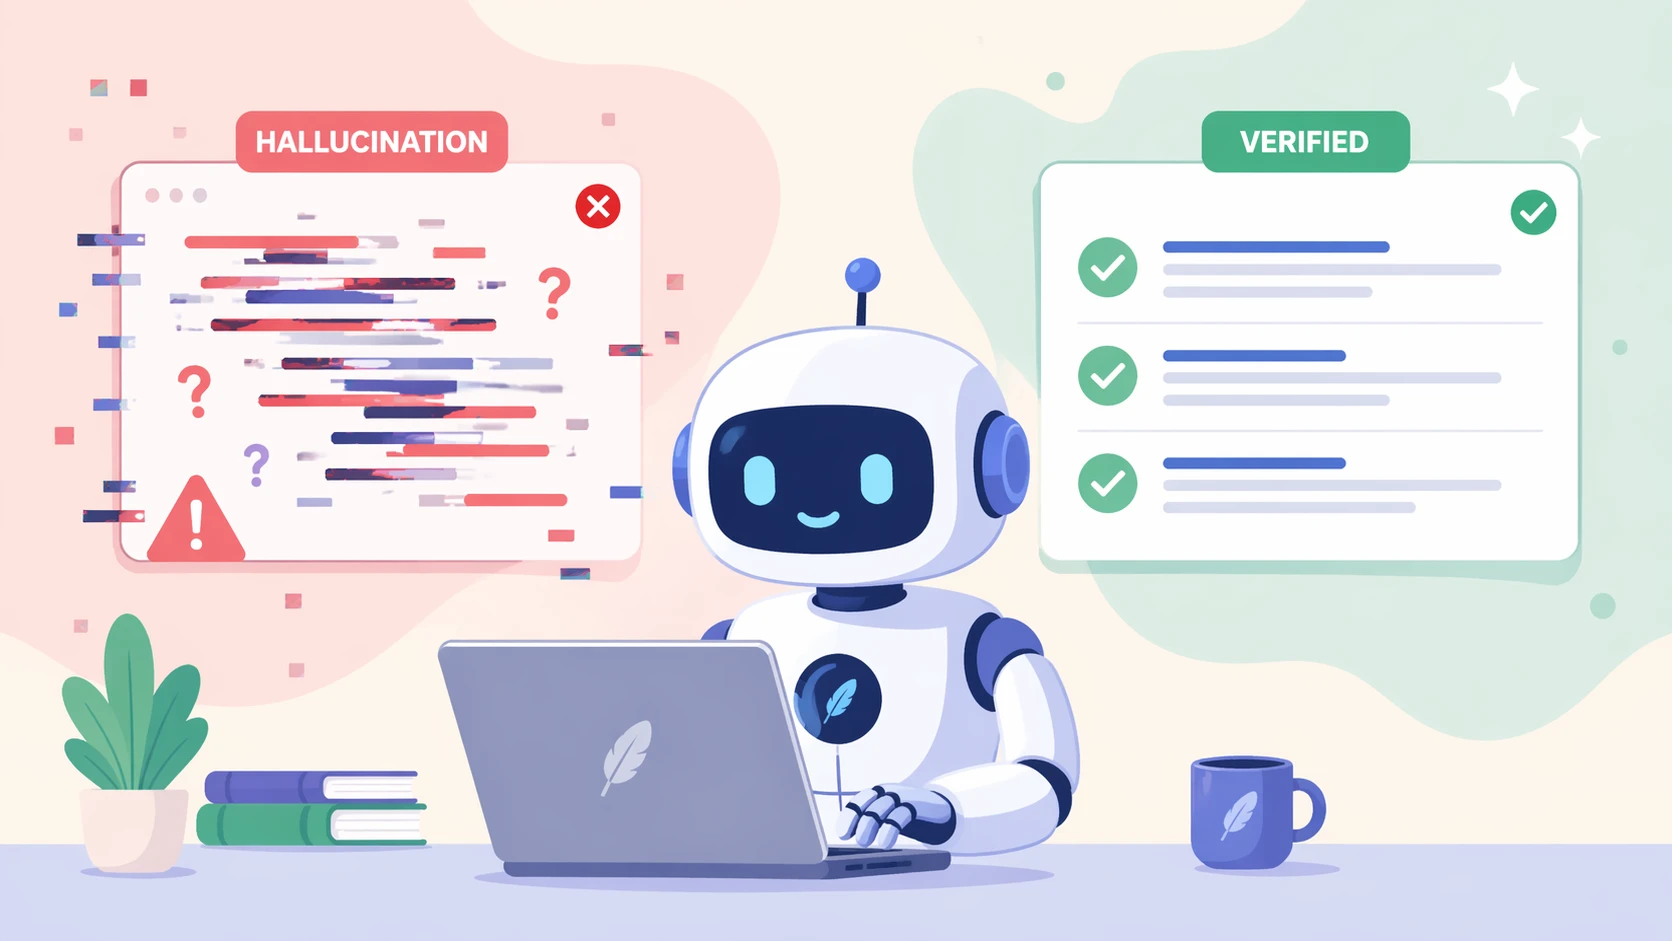
AIモデルは時として、事実ではないことをでっち上げることがあります。これは「ハルシネーション(幻覚)」と呼ばれます。これを防ぐには、明確な指示、照合するための事実、そして回答をダブルチェックするシステムの3つが必要です。
これらのツールが普及するにつれ、誤った回答はより大きな問題となっています。このガイドでは、今すぐそれらのエラーを減らすための具体的な手順を紹介します。より信頼性の高いワークフローを構築する準備はできましたか?それでは始めましょう。
Write With Fewer AI Errors
Generate accurate structured outputs with guided prompts and built in verification steps
Try Jenni Free執筆においてAIのハルシネーションが起こる理由
本質的に、AI執筆ツールは高度なパターンマッチングエンジンです。膨大なテキストデータでトレーニングされ、シーケンス内の次の単語を予測します。その仕組み(および失敗する要因)について詳しく知りたい場合は、当社の学術執筆におけるAI執筆アシスタントの仕組みの解説をご覧ください。
このプロセスにより非常に流暢な文章が生成されますが、それが真実であることを保証するものではありません。これらのツールを効果的に活用するためには、AIのハルシネーションと誤情報(misinformation)の違いを理解することが極めて重要です。
AIに質問をしても、データベースから検証済みの事実を検索してくるわけではありません。代わりに、統計的な確率に基づいて回答を生成します。
問題が発生するのは、プロンプトが曖昧であるか、モデルが単に持っていない最新の特定の知識をトピックが要求している場合です。
ハルシネーションの多くは、相互に関連する3つの問題によって引き起こされます。
曖昧さの問題: 大雑把で定義が不十分なプロンプトは、AIに不正確な内容をでっち上げる隙を大きく与えてしまいます。明確な境界線がないと、AIは最も一貫しているように見える単語のパターンで隙間を埋めようとするため、自信に満ちているものの誤った記述につながります。
知識のギャップ: AIモデルの知識は、最後のトレーニングアップデートの時点で凍結されています。時事問題、最近のデータ、プライベートな情報を知る生来の能力はありません。クエリがこれらの領域に触れると、モデルは既知の古いパターンに適合する回答を捏造することがよくあります。
過剰な自信のエラー: これらのモデルは、役に立ち、確実であるように聞こえるように設計されています。法律、医療、技術仕様などの専門的な分野では、学習した一般的なパターンを過剰に適用してしまい、詳細でありながら根本的に欠陥のある説明を作成することがあります。
これを理解することが、コントロールへの第一歩です。AIは自力で事実とフィクションを区別できないため、精度高くAIを導き、その出力を検証する責任はユーザーにあります。
正確性とコントロールのためのプロンプトエンジニアリング
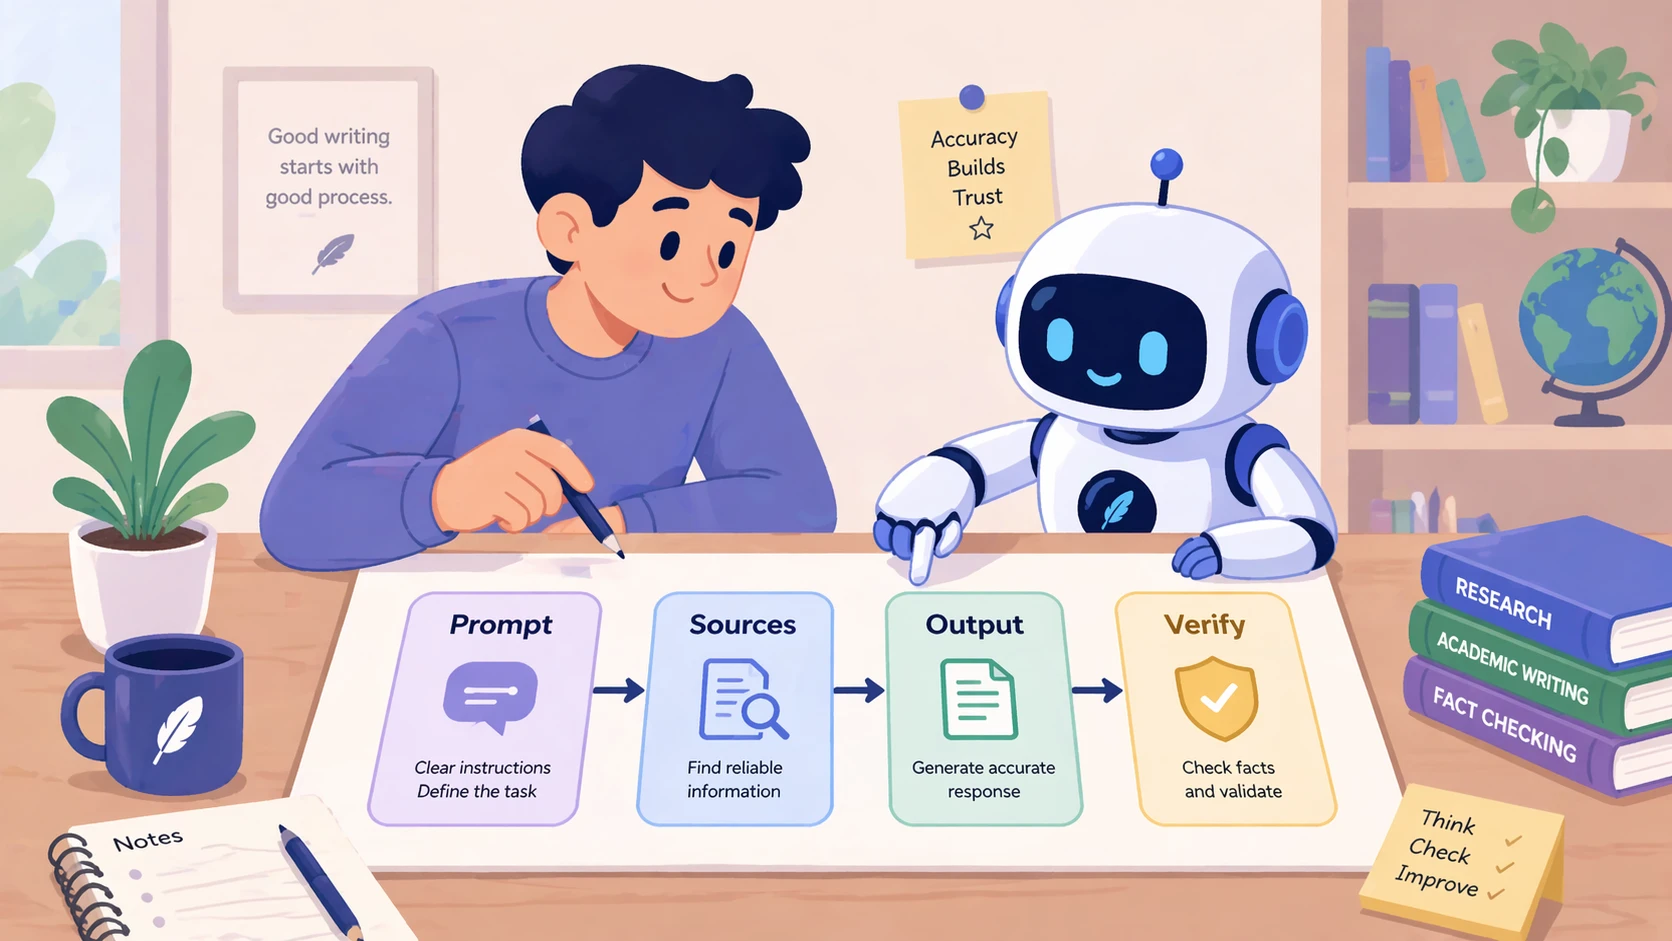
正確なプロンプトは、でっち上げの情報に対する最初で最も強力な防御策です。曖昧さを排除し、厳しいルールを設定することで、ユーザーが定義した枠組みの中でAIを強制的に動作させることができ、詳細を捏造する能力を劇的に減少させます。より構造化されたフレームワークや例が必要な場合は、当社の学術的なAI執筆向けプロンプトエンジニアリングガイドでこれらのテクニックを詳しく解説しています。
このように考えてみてください。「量子コンピューティングについて説明して」という曖昧なプロンプトは、モデルが良いように聞こえる内容で隙間を埋めるためのオープンな招待状です。強力なプロンプトは、役割の説明、締め切り、従うべき特定の形式を与えます。
例えば、以下の2つのアプローチを比較してみましょう。
弱いプロンプト: 気候変動について説明してください。
強いプロンプト: IPCC第6次評価報告書のデータのみを使用し、人間活動に起因する気候変動の主な原因を3つ挙げてください。回答は箇条書きとし、それぞれ1文で説明してください。推測は行わないでください。
2つ目のバージョンが機能するのは、「情報源の指定(IPCC報告書)」、「出力方法の定義(箇条書き)」、そして「明確な境界線の設定(推測はしない)」という3つの要素を満たしているためです。
信頼できるプロンプト作成の重要テクニック:
役割(ロール)を与える: 「財務監査人として振る舞ってください」や「あなたは出来事を要約する歴史家です」のように始めます。
情報源(ソース)を制約する: 使用すべきデータベース、時期、または出版物を指定します。
フォーマットを指定する: 表、引用付きのリスト、またはステップバイステップの説明を求めます。
明示的な制限を述べる: 「意見を含めないでください」や「上記のコンテキストで提供された情報のみを使用してください」といった直接的なコマンドを使用します。
信頼できるプロンプトを作成するための重要なテクニックには、特定の役割を割り当てることや、出力形式を指示することが含まれます。もう1つの便利な方法は、モデルに推論を段階的に分解するように促す思考の連鎖(Chain of Thought)プロンプトを活用することです。
これによりプロセスは遅くなりますが、論理が明確になり、誤った結論へ飛躍するのを防ぐことができます。また、事実に基づくタスクでは、温度(temperature)設定を調整する(通常は0.2のような低い値にする)ことも役立ちます。
これにより、AIの単語選択のランダム性が抑えられ、回答の整合性と予測可能性が高くなります。ただし、完璧なプロンプトは最初のフィルターに過ぎません。お膳立てにはなりますが、それでも結果を検証する必要があります。
RAG(検索拡張生成):データをベースにAIの事実安定性を高める
検索拡張生成(RAG)は、AIの内部知識に限りがあり、古くなっている可能性があるという核心部分の問題に対処します。
解決策はいたってシンプルで、モデルに推測させないことです。代わりに、文章を書き始める前に、参照元として検証済みのドキュメントを提供します。
RAGは、AIに宿題をさせるようなものだと考えてください。質問を投げかけると、システムはまず、社内レポートや法的データベース、最近の学術論文など、接続されたデータベースを検索します。
これらの実在するソースから関連する一節を抽出し、「この情報のみを使用して質問に答えてください」という指示とともにAIに提供します。
これにより、プロセスは自由な創作から、制約のある要約・報告へと変化します。モデルの役割は「可能性の高い回答を生成する」ことから「提供された事実から回答を統合する」ことへとシフトします。
基本的な比較により、アプローチと結果の違いが明らかになります。
手法 | 情報源 | 事実としての正確性 | ハルシネーションのリスク |
標準的なAI | 静的なトレーニングデータ | 中程度 | 高い |
RAGシステム | 提供された外部ソース | 高い | 従来より低い |
Graph-RAG | 関連する事実がマップされたネットワーク | 非常に高い | 極めて低い |
Graph-RAGのような高度な実装では、ナレッジグラフを使用してエンティティ間の関係をマッピングします。研究によると、これは論理的一貫性を維持する上で標準的なRAGを上回る成果を上げることが示されています。
実用にあたって、最初から複雑なシステムは必要ありません。最も単純なRAGの形態は、ソースドキュメントのテキストをコピーしてプロンプトに直接貼り付け、そのテキストのみに基づいて要約や質問への回答をAIに求めることです。
より高度なツールを使用すれば、AIをライブデータベースや独自のドキュメントライブラリに自動的に接続できます。この手法は、AIが正しいことを期待する状態から、情報がどこから来たのかを把握している状態へと目的を移行させ、検証を可能にします。
AIの安全性において、人間の検証が重要である理由
AIシステムは情報をでっち上げることがあります。人間による検証とは、誰の目にも触れる前に、AIが生成した内容を信頼できる実世界のソースと照らし合わせてチェックするプロセスのことです。最も優れたAIであっても間違いを犯す可能性があるため、このステップは極めて重要です。
『Nature Machine Intelligence』に掲載された研究では、人間が介入する(Human-in-the-loop)検証が最も効果的なセーフガードであり、AIが生成するエラーの拡散を大幅に抑制できると強調されています。ファクトチェックは選択肢ではなく、必須要件です。
この段階で見つけた正当な情報源を整理し追跡するために、文献管理ツールの重要性を理解し、ツールを活用することを強くお勧めします。これにより、すべての主張が「幻覚」による参考文献ではなく、追跡可能な実在する文書に裏付けられている状態を保証できます。
これは記事をざっと読むこととは異なります。構造化され、体系化されたプロセスを指します。
検証ワークフローの仕組み
強固な検証プロセスは、以下の特定の手順に従います。
主張をクロスリファレンスする: 重要な主張はすべて、少なくとも2つの信頼できるソースと照合する必要があります。
データの一次情報源を確認する: AIによる統計データの要約を鵜呑みにしてはいけません。オリジナルのレポートや出版物を探して読みましょう。
引用をチェックする: 引用されているソースが実際に存在するか、AIがそれを正確に引用しているかを確認します。
確認できないものにフラグを立てる: 不確かに思われる主張や、すぐに検証できない主張は、手動でのより詳細な調査のために取り除いておきます。
このアプローチは、正確性を確保するために学術界やジャーナリズムで使用される研究ワークフローを反映しています。
実用的な方法:確信度(信頼度)のタグ付け
効果的なテクニックの1つは、情報を検証する際に、それぞれの情報に対して確信度(信頼度)のタグを付けることです。たとえば、次のように分類します。
確信度:高 複数の権威ある情報源によって検証されているもの。
確信度:中 1つの優れた情報源に基づけば正確に見えるが、ダブルチェックを行う余地があるもの。
確信度:低 未検証、疑問がある、または信頼性に欠ける情報源からのもの。手動での完全な検証が必要。
このタグ付けシステムにより、透明性が高まります。文書のどの部分が極めて強固で、どの部分に再考が必要かが明確に示されるため、最終成果物に対する信頼が築かれます。
結論は至ってシンプルです。人間の監視こそが真のセーフネットであるということです。それなしでは、AIシステムがいかに優れて設計されていようとも、複雑な、あるいは稀な状況において、やがて重大なエラーを引き起こすことになります。
リアリティフィルターと制約条件システム
AIは、不要であるにもかかわらず、隙間を埋めようとすることがよくあります。リアリティフィルターは、これを止めるための技術的アプローチです。これはAIに対して、不確実性を認めさせ、裏付けのない主張をしないように強制します。
重大な影響を伴う環境において、これらのフィルターはフェイクニュースや誤情報の拡散を防ぎ、データ主導のコンテンツの客観性を維持します。
情報を検証できない場合、推測させるのではなく、「データが不足しています」と回答するようにシステムに指示する必要があります。
このアイデアは、デベロッパーのフォーラムやX(旧Twitter)などのプラットフォームで広まり始めました。その中核となる原則は非常にシンプルで、AIが情報を持っていない場合には、推測するのではなく、明確に情報が欠落している旨を述べるようにプログラムすることです。
象徴的な例:制約プロンプト
AIには以下のようなシンプルなルールを指示できます。
情報を検証できない場合は、推測するのではなく「情報不足」と回答してください。
この1つの指示を一貫して適用するだけで、捏造されたコンテンツは減少します。AIは回答をでっち上げることができなくなります。
ハードな制約事項の適用
より洗練されたシステムでは、以下のような特定のハードコーディングされたルールを使用します。
引用元(ソース)が示されない統計データは提示してはならない。
固有名詞(人名、会社名、地名)は、検証なしに言及してはならない。
推測に基づく論理展開は認められない。
これらのルールは「ガードレール」としての役割を果たします。それらにより、尤もらしく聞こえるものの誤っている、あるいは紛らわしい出力を生成するモデルの能力が物理的に制限されます。
実質的に、この方法は技術分野や研究におけるAI生成コンテンツの信頼性をはるかに高めます。完全であるという「錯覚」を、検証可能な「正確性」へと引き換えることができます。
メモリシステム対表面的なアプローチ
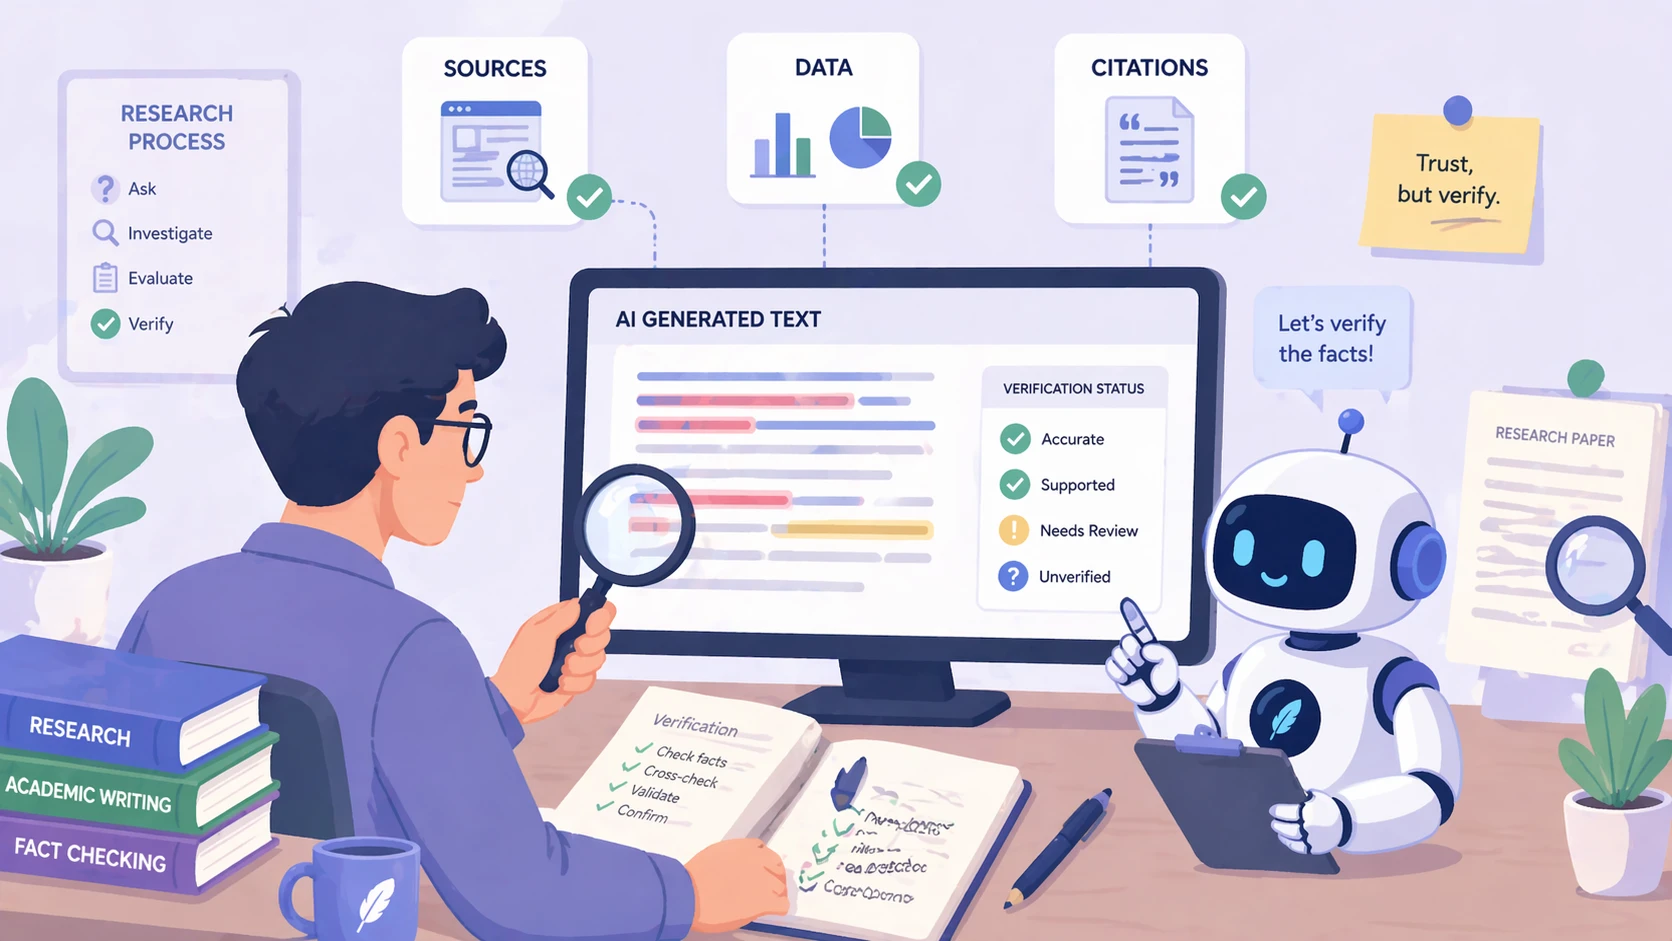
AIによるでっち上げを防ぐことは、単に賢いプロンプトを作成することだけではありません。長期的に問題を本当に解決するには、システムの「メモリ(記憶)」に目を向ける必要があります。
AI執筆ツールの選び方を評価する際は、長い文書をまたいでコンテキスト(文脈)を維持できるプラットフォームを探してください。
表面的なレベルのプロンプトエンジニアリングは、推論の複数のステップにわたって積み重なるエラーなど、より深い構造的失敗を捉えることができません。
研究者らは、複雑なタスクにおけるハルシネーションの重大な部分が、モデルが以前の推理ステップを見失うことに起因する「カスケード(連鎖)効果」を特定しました。
これは理論上の欠陥ではなく、人々が複雑な業務にAIを使用する際に直面する現実の問題です。
このように考えてみてください。優れたプロンプト作成が傷口に絆創膏を貼るようなものであるとすれば、メモリシステムは出血の根本原因を治療するようなものです。
優れたメモリシステムが実際に果たす役割
AIが記憶力を維持できる場合、核心的な問題が解決されます。
会話やタスクを最初から最後までしっかりと追跡し続けます。
同じことの自己反復や、5分前に述べたこととの矛盾を防ぎます。
生成済みの内容と一貫性のある回答を維持します。
表面的な対症療法では解決できないこと
表面的なレベルのプロンプトエンジニアリングでは、以下のような深い構造的な失敗は解決できません。
推論の複数のステップにわたって累積されるエラー。
長大で詳細なワークフローにおける、完全なコンテキストの喪失。
新しいセッションで同じ質問をした際に、異なり矛盾した回答が返ってくる現象。
執筆、特に研究やレポート、あらゆる長編コンテンツにとって、これは致命的です。AIの信頼性を高めるためには、時間を超えてコンテキストを記憶・追跡できるようにシステムが設計されていなければなりません。その強固な基礎がなければ、ただ絆創膏を貼り続けているだけに過ぎません。
AIコンテンツの監査とエラー検出
体系的な監査は、出力を分析して不整合がないかを検証することによってハルシネーションを特定します。AIのミスを捉えるにはシステムが必要です。監査(オーディット)とは、AI生成文をスキャンして不整合、論理の飛躍、裏付けのない主張を見つけるためのシステム体系的な方法です。
これにより、AIでの執筆作業が「賭け」から、管理され、再現可能なプロセスへと変化します。
監査において確認すべきポイント
適切な監査では、いくつかの重要な点を確認します。
すべての数字や統計を検証する: 正しいと証明されるまでは間違っていると仮定します。
内部の矛盾を検出する: テキストの中で自家撞着に陥っていないか確認します。
曖昧または裏付けのない主張にフラグを立てる: 自信ありげに聞こえるものの、内容は空っぽの文章をあぶり出します。
引用の正確性を確認する: ソースが存在するか、テキストが主張している内容が本当にそこに記載されているか確認します。
実用的な検証チェックリスト
シンプルな表をガイドとして使用することで、これを体系的に行うことができます。
チェックの種類 | 着目すべきポイント | 実行すべきタスク |
事実関係 | 不正確または古い情報 | 一次情報源とクロスチェックを行う |
引用 | 不足、リンク切れ、あるいは誤って提示された参考文献 | 実際のソースに差し替えるか、当該主張を削除する |
論理 | 一貫のない推論、または裏付けのない結論 | 明確にするために該当セクションを全面的にリライトする |
明瞭性 | 曖昧または過度に広範な主張 | 具体的な詳細や条件付きのコンテキストを追加する |
この構造化されたアプローチこそが、アマチュアの利用と、プロフェッショナルで低リスクなAIコンテンツ生成の境界線です。これは、問題が発生する前にエラーを見つけ出す品質管理ステップです。
信頼性の高いAI執筆ワークフローの構築
AIから信頼できる結果を得るには、プロセスが必要です。優れたワークフローは、生成、確認、編集を一風の反復的なシステムに統合します。それは単発のコマンドではなく、パイプラインです。
中核となる3つのステップのサイクル
生成する: AIに何をしてはいけないかを指示する、構造化され制約のあるプロンプトから開始します。
監査する: 出力を検証チェックにかけます。不整合や裏付けのない主張を徹底的に探します。
リファインする(洗練させる): 不明瞭、不安定、または何かしっくりこないセクションを書き直します。
この「生成-確認-修正」というループは、プロフェッショナルなAIのエラー防止対策の基礎です。チームがミスを導入することなく、これらのツールを使用する方法です。
実際の現場における運用イメージ
実際には、1つのコンテンツが以下のような段階を経て進められます。
境界線を設定するための巧妙に作られたプロンプトを使った下書き(ドラフト)。
すべての重要な主張を、外部の信頼できるソースに照らして検証する(バリデーション)。
事実が完全に確認された後にのみ、トーンと明瞭性を最終決定する(最終化)。
この方法は、単に捏造をキャッチするだけに留まりません。AIを活用した執筆の表現力と正確性を着実に向上させ、初期段階から誤った表現を削減します。
執筆物に表れる前に、推測を排除する
おそらくそのような事態を目にしたことがあるでしょう。出力の内容は自信に満ちているように聞こえるものの、どこか不自然に感じ、完全には信用できない。そうした不信感はあなたの作業を停滞させます。これは実際、深刻な問題です。
Write Accurate AI Content Faster
Use structured prompts verification and guided workflows to reduce hallucinations in your writing
Try Jenni Free進むべき道は、プロンプトを明確にし、すべての主張を検証するシンプルなシステムを構築することです。Jenniのようなツールを利用すれば、コントロールを失うことなく一貫性を維持するのに役立ちます。これはあなたの判断に取って代わるものではありませんが、初期段階で過ちを発見し、執筆物の正確性を保ちやすくしてくれます。