Di
Justin Wong
—
Il Campionamento Casuale Spiegato: Metodi, Passaggi e Applicazioni Reali

Justin Wong
Capo della Crescita
Laureato con una Laurea in Business Globale e Arti Digitali, Minore in Imprenditorialità
Per studiare una vasta popolazione, si seleziona casualmente una piccola porzione di essa. Questo metodo, noto come campionamento casuale, offre a ciascun individuo la medesima probabilità di essere selezionato. Rappresenta la pietra angolare per una ricerca scientifica rigorosa e affidabile in discipline quali la medicina e la demoscopia.
Questa guida illustrerà il funzionamento di tale metodologia, le diverse tecniche disponibili e come applicarle concretamente in un progetto di ricerca. Siete pronti a scoprirne i dettagli?
<CTA title="Costruisci Campioni di Ricerca Migliori" description="Progetta piani di campionamento strutturati più rapidamente e riduci i bias nel tuo processo di ricerca" buttonLabel="Prova Jenni Gratuitamente" link="https://app.jenni.ai/register" />
Cosa Significa Concretamente il Campionamento Casuale
Nella pratica scientifica, il campionamento casuale implica la selezione dei soggetti basata puramente sul caso, un obiettivo che si rivela più complesso di quanto possa sembrare.
L'Organizzazione Mondiale della Sanità sottolinea come questo approccio imparziale sia fondamentale per ottenere stime della popolazione estremamente accurate.
Un campione ottimale riflette fedelmente la composizione complessiva del gruppo in termini di età, reddito e altre variabili, risultando cruciale per analisi statistiche avanzate come la regressione lineare. Sebbene la teoria sia lineare, l'applicazione pratica presenta spesso notevoli sfide.
I ricercatori si scontrano frequentemente con problematiche quali elenchi di partecipanti incompleti, trovandosi costretti a optare per metodi "quasi-casuali" che non possiedono una reale natura probabilistica. Questa distinzione metodologica segna spesso il confine tra i diversi paradigmi di ricerca in ambito accademico.
Per ottenere un autentico campione casuale, sono necessari tre requisiti fondamentali:
Un elenco completo di tutti i membri della popolazione di riferimento.
Una probabilità nota e non nulla per ciascun individuo di essere selezionato.
Un processo di selezione basato esclusivamente sulla casualità, e non sulla convenienza.
Divergere da questi rigorosi principi, anche in minima parte, introduce bias sistematici e compromette la validità dei risultati scientifici.
<ProTip title="💡 Suggerimento Professionale:" description="Verifica sempre la tua lista di campionamento prima di selezionare i partecipanti per evitare bias nascosti" />
I Principali Metodi di Campionamento Casuale Spiegati
Le diverse tecniche applicano la casualità in modo rigoroso e strutturato. La scelta ottimale dipende dal disegno dello studio — in particolare se si stia conducendo una ricerca qualitativa o quantitativa — e dalle dimensioni della popolazione target.
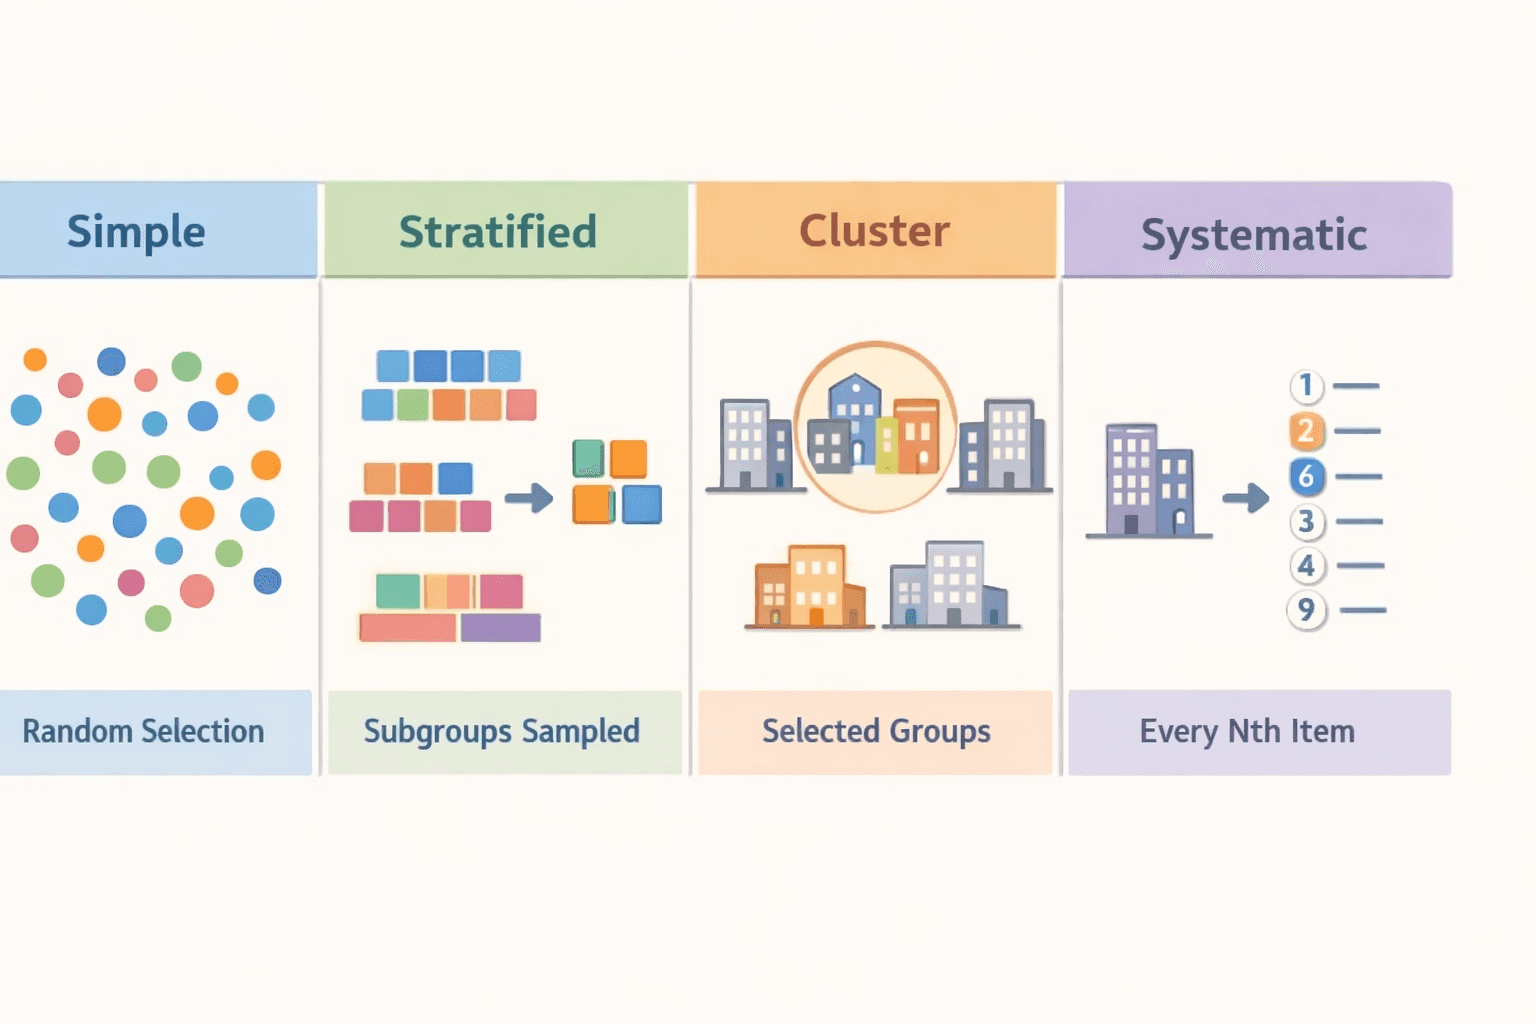
Campionamento casuale semplice (la forma pura)
In questa configurazione, ogni singolo individuo ha la medesima probabilità di essere estratto. I ricercatori utilizzano tipicamente generatori di numeri casuali o sistemi di estrazione di tipo statistico.
Si immagini una classe composta da 500 studenti. Assegnando a ciascuno un codice identificativo e utilizzando un generatore per selezionarne 50, si ottiene un classico esempio da manuale scientifico.
La potenza statistica derivante è elevata, ma dipende strettamente dalla disponibilità di un elenco completo e privo di errori della popolazione d'interesse. Qualsiasi difetto nella lista si rifletterà inevitabilmente sulla validità dei risultati.
Campionamento casuale stratificato (per una rappresentazione bilanciata)
Questo metodo suddivide la popolazione in sottogruppi omogenei e mutuamente esclusivi (strati), come fasce d'età o livelli di reddito, prima di procedere all'estrazione casuale da ciascuno di essi. Ciò garantisce una rappresentazione proporzionale e accurata di queste categorie chiave.
Un'indagine sanitaria, ad esempio, potrebbe stratificare la popolazione per decenni d'età (20-29, 30-39, ecc.) per assicurare che ciascun gruppo sia rappresentato in base alla sua reale quota demografica.
I vantaggi principali consistono nella riduzione della variabilità campionaria e nell'ottenimento di stime estremamente precise per ogni sottogruppo. Si tratta di una tecnica ampiamente valorizzata nella ricerca sociale e di mercato.
Campionamento a grappolo (efficiente per grandi popolazioni)
Invece di selezionare i singoli individui, si estraggono casualmente interi gruppi preesistenti, denominati "grappoli" o "cluster" (ad esempio, selezionando cinque scuole e intervistando tutti gli studenti al loro interno).
Questo rappresenta uno dei metodi di campionamento probabilistico più diffusi per lo studio di popolazioni geograficamente disperse.
Tale approccio riduce drasticamente i tempi, i costi e la complessità logistica del progetto di ricerca. Il compromesso metodologico risiede in un errore di campionamento generalmente superiore rispetto a tecniche come la stratificazione.
Campionamento sistematico (casualità strutturata)
Dopo aver stabilito un punto di partenza casuale, si seleziona un individuo ogni n posizioni all'interno della lista (ad esempio, ogni decimo utente registrato in un database).
Pur essendo estremamente lineare nell'applicazione, presenta un rischio intrinseco: se l'elenco di partenza possiede una struttura ciclica nascosta (ad esempio, se ogni decima posizione corrisponde sistematicamente a un profilo con caratteristiche specifiche), il campione risulterà inevitabilmente distorto.
Confronto Sinottico dei Metodi
Metodo | Caso d'uso ideale | Punto di forza principale | Limite chiave |
Casuale Semplice | Popolazioni contenute con elenchi completi | Elevata accuratezza statistica | Richiede un elenco esaustivo e aggiornato |
Stratificato | Popolazioni con sottogruppi eterogenei rilevanti | Garantisce la rappresentazione di tratti chiave | Maggiore complessità di pianificazione |
A Grappolo | Popolazioni vaste e geograficamente disperse | Estremamente pratico ed economicamente efficiente | In genere presenta un errore campionario maggiore |
Sistematico | Dataset ordinati privi di pattern ciclici | Semplice e rapido da implementare | Vulnerabile a bias legati alla periodicità della lista |
Tutti questi approcci condividono il rigore teorico del campionamento probabilistico, ma ognuno presenta specifici compromessi pratici che influenzano la qualità finale dei dati.
<ProTip title="📊 Suggerimento Professionale:" description="Utilizza il campionamento stratificato quando i sottogruppi della popolazione differiscono significativamente per dimensione o comportamento" />
Il Processo di Campionamento Casuale Passo dopo Passo
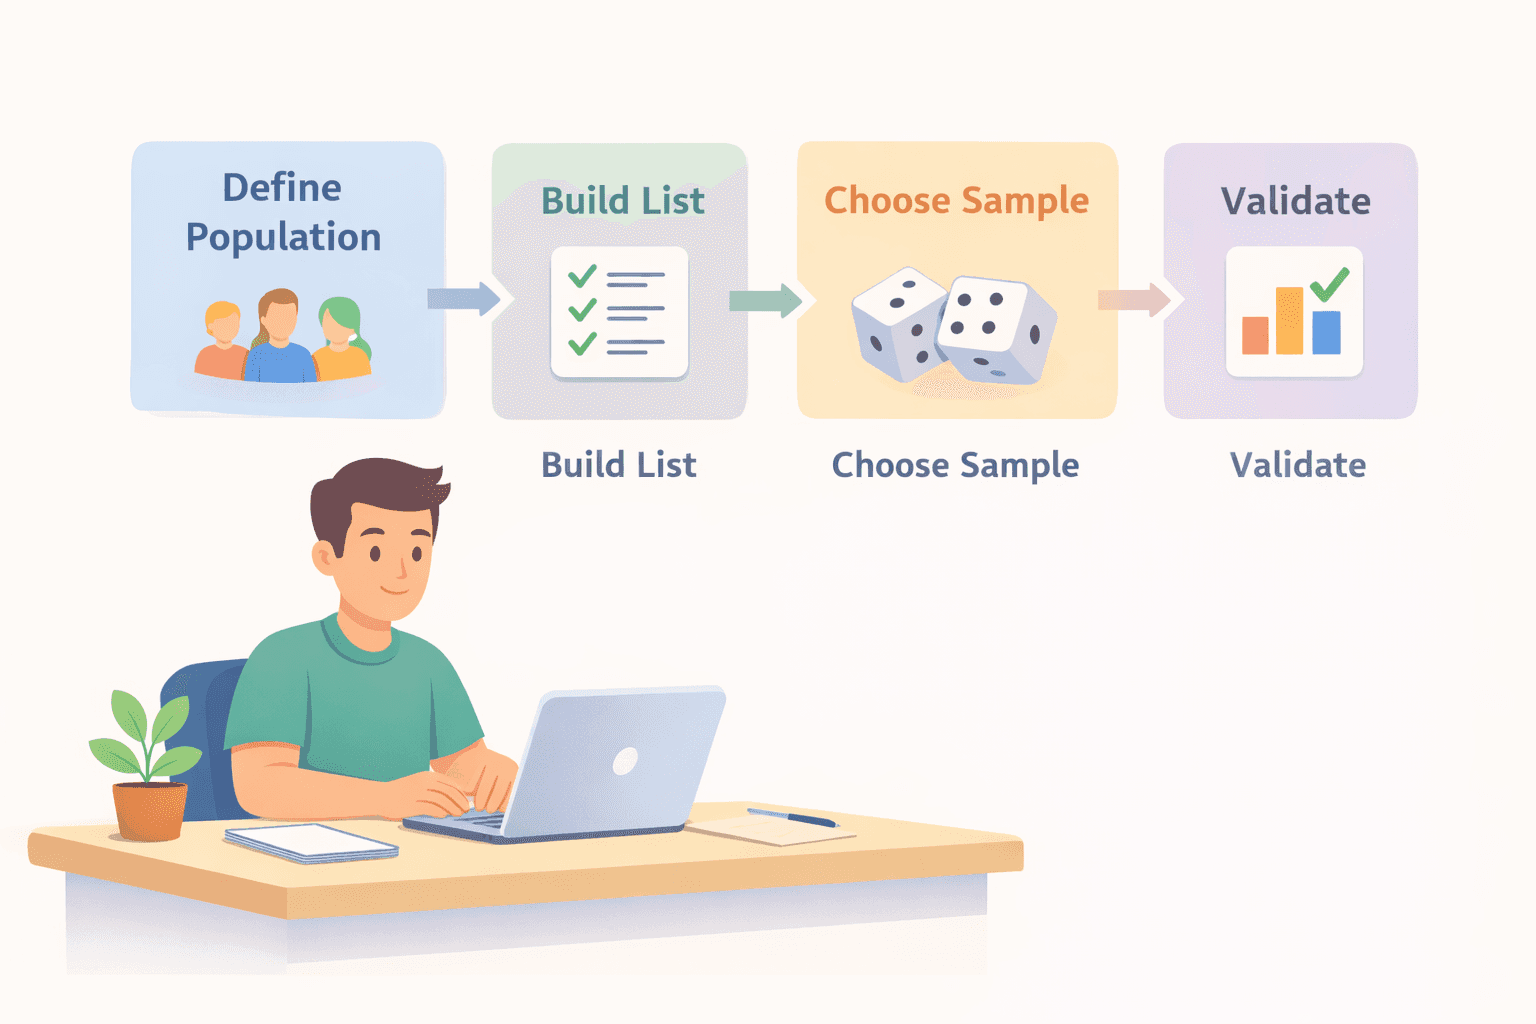
Condurre un campionamento casuale scientificamente valido richiede il rispetto rigoroso di una sequenza metodologica. L'omissione di una singola fase rischia di compromettere l'intero set di dati.
Fase 1: Definizione della popolazione e dell'ambito di ricerca
Il primo passo consiste nell'individuare con assoluta precisione l'oggetto dello studio. Evitando definizioni generiche come "i giovani", è preferibile specificare, ad esempio, "tutti gli studenti universitari iscritti a Surabaya nel corso dell'anno accademico 2024". Questa delimitazione iniziale definisce l'intero impianto metodologico e la fattibilità stessa della ricerca.
Fase 2: Costruzione del frame di campionamento
Si tratta della lista di riferimento che deve includere, idealmente, ogni singolo membro della popolazione definita. Se alcuni soggetti vengono esclusi a priori da questo elenco, la loro probabilità di selezione scende a zero, annullando di fatto il principio di casualità.
Il Pew Research Center ha ampiamente documentato come la presenza di liste di campionamento lacunose o errate rappresenti una delle fonti primarie di bias nelle grandi indagini statistiche.
Fase 3: Determinazione della numerosità campionaria
La definizione del numero ottimale di soggetti da includere è il risultato di un bilanciamento tra livello di confidenza e precisione desiderata. Un'analisi della Harvard T.H. Chan School of Public Health evidenzia che l'aumento delle dimensioni del campione incrementa la robustezza statistica solo se il processo di selezione originario è autenticamente casuale.
L'utilizzo di uno specifico calcolatore della dimensione del campione permette di ottimizzare il rapporto tra livello di significatività e margine d'errore. Per procedere al calcolo, è necessario definire tre parametri:
Il livello di confidenza desiderato (tipicamente fissato al 95%)
Il margine di errore tollerabile
La variabilità stimata della caratteristica di interesse all'interno della popolazione
Fase 4: Esecuzione della selezione casuale
In questa fase si applicano algoritmi probabilistici per estrarre il campione dalla lista di riferimento. Tra gli strumenti metodologici più accreditati si annoverano:
Generatori digitali di numeri casuali basati su algoritmi validati
Tavole di numeri casuali (per approcci tradizionali)
Software statistici specializzati per la selezione automatizzata. L'obiettivo cardine è l'eliminazione di qualsiasi arbitrio o intervento umano nel processo selettivo.
Fase 5: Validazione della rappresentatività
Una volta estratto il campione, è doveroso verificarne scientificamente la bontà. Occorre confrontare le caratteristiche demografiche e descrittive fondamentali (es. età media, distribuzione di genere) con i parametri noti della popolazione complessiva.
Qualora emergessero differenze statisticamente significative, sarà necessario analizzare criticamente le fasi precedenti, al fine di correggere eventuali anomalie nella lista di partenza o nella procedura di selezione.
<ProTip title="🧪 Suggerimento Professionale:" description="Effettua un test pilota della tua procedura di campionamento attraverso simulazioni su scala ridotta prima di avviare la raccolta dati definitiva" />
Perché la Comunità Scientifica Diffida dei Campioni "Quasi-Casuali"
Tale scetticismo è pienamente giustificato dal punto di vista metodologico. Nella pratica della ricerca, si ricorre talvolta a soluzioni di ripiego non rigorose, e il dibattito accademico è costantemente focalizzato sulla reale validità scientifica di tali approcci.
La scorciatoia più frequente è rappresentata dal campionamento di convenienza, che consiste nell'intervistare colleghi, pubblicare sondaggi su gruppi social o raccogliere dati dai primi visitatori di un sito web.
Sebbene questi gruppi risultino facilmente accessibili, la selezione non risponde a criteri probabilistici, bensì a criteri di mera opportunità e vicinanza, introducendo una grave distorsione sistematica nei risultati.
Un errore comune risiede nella convinzione che un campione molto numeroso possa compensare un vizio metodologico d'origine. Al contrario, un campione distorto di mille individui offre un valore scientifico nettamente inferiore rispetto a un campione autenticamente casuale e rigoroso di cento soggetti.
In assenza di una lista di campionamento esaustiva, non è possibile definire lo studio come probabilistico. Questa carenza metodologica rappresenta uno dei motivi principali per cui molti manoscritti scientifici vengono respinti quando i ricercatori provano a scegliere una rivista accademica per la pubblicazione, poiché i revisori scientifici esigono il massimo rigore nel disegno campionario.
Campionamento Casuale vs Campionamento Non Probabilistico
Comprendere questa dicotomia è un pilastro della metodologia della ricerca: da essa dipende la possibilità di generalizzare i risultati ottenuti alla popolazione complessiva (inferenza statistica).
Le differenze sul piano metodologico
Aspetto | Campionamento casuale | Campionamento non probabilistico |
Criterio di selezione | Puramente casuale e probabilistico | Basato sul giudizio del ricercatore o su criteri di convenienza |
Rischio di bias | Teoricamente minimo, se correttamente implementato | Intrinsecamente elevato e non quantificabile statisticamente |
Inferenza statistica | Consente di estendere le stime all'intera popolazione | Non permette la generalizzazione statistica dei risultati |
Il campionamento casuale fornisce le basi matematiche necessarie per l'applicazione della statistica inferenziale. Al contrario, i metodi non probabilistici non offrono alcuna garanzia teorica che il campione sia specchio fedele della popolazione d'origine.
Quando adottare ciascun approccio
La scelta deve ricadere sul campionamento casuale quando l'obiettivo dello studio richiede conclusioni precise, generalizzabili e scientificamente difendibili. Questo è indispensabile per:
Sperimentazioni cliniche e studi epidemiologici in sanità pubblica
Rilevazioni statistiche ufficiali di carattere governativo o censuario
Ricerche accademiche formali destinate alla pubblicazione peer-reviewed
I metodi non probabilistici possono essere presi in considerazione in presenza di specifici vincoli operativi:
Ricerche caratterizzate da tempistiche estremamente ristrette o budget limitati
Studi preliminari o di carattere puramente esplorativo, volti a raccogliere primi feedback qualitativi
Impossibilità oggettiva di mappare o raggiungere l'intera popolazione target (es. popolazioni marginali o nascoste)
In sintesi, il campionamento casuale si impiega per validare e dimostrare ipotesi scientifiche; il campionamento non probabilistico è ideale per esplorare nuovi ambiti di ricerca.
<ProTip title="⚖️ Suggerimento Professionale:" description="Evita rigorosamente di definire i campioni di convenienza come casuali nei report di ricerca scientifica" />
Applicazioni del Campionamento Casuale nel Mondo Reale
Questa metodologia non è solo un concetto teorico da manuale, ma rappresenta uno strumento operativo essenziale in molteplici ambiti professionali per guidare decisioni strategiche e minimizzare i bias.
Nel settore sanitario ed epidemiologico, costituisce la struttura portante dei trial clinici controllati e degli studi di prevalenza. Ad esempio, gli enti di sanità pubblica utilizzano il campionamento probabilistico per stimare la diffusione delle patologie a livello nazionale, orientando così le politiche sanitarie globali.
Nelle ricerche di mercato, le aziende leader vi fanno costante affidamento. Per comprendere i reali orientamenti dei consumatori o valutare la brand reputation in modo oggettivo, il campionamento casuale offre una fotografia accurata ed esente da distorsioni del target di riferimento.
Il campo della data science e dell'intelligenza artificiale ne valorizza enormemente le proprietà. Gli scienziati dei dati impiegano tecniche di campionamento casuale per strutturare dataset di addestramento bilanciati per gli algoritmi di machine learning, garantendo la correttezza etica e l'imparzialità dei modelli predittivi.
Metodologie avanzate come il ricampionamento bootstrap (utilizzato per stimare la variabilità statistica) e le simulazioni Monte Carlo si fondano interamente su ripetute estrazioni casuali.
Troviamo inoltre questa metodologia applicata in:
Scienze sociali, per la conduzione di sondaggi demoscopici di rilevanza nazionale.
Istituzioni pubbliche, per la progettazione di censimenti demografici e attività ispettive.
Processi industriali, per il controllo statistico di qualità sulle linee di produzione.
In ciascuno di questi scenari, l'elemento comune è l'uso del campionamento casuale per trasformare dati grezzi in analisi predittive affidabili, sostituendo l'intuizione soggettiva con decisioni basate sull'evidenza scientifica.
Errori Comuni e Buone Pratiche Metodologiche
Anche i team di ricerca con maggiore esperienza possono incorrere in sviste metodologiche in grado di inficiare la qualità dei dati fin dalle prime fasi del progetto.
Errori più frequenti
Alcune criticità metodologiche ricorrenti possono compromettere l'integrità del campione:
Utilizzo di elenchi della popolazione obsoleti, incompleti o non aggiornati.
Assimilazione impropria di dati raccolti per convenienza a veri campioni casuali.
Mancata esecuzione dei calcoli statistici necessari per determinare la corretta numerosità campionaria.
Omissione delle procedure volte a garantire la corretta rappresentazione dei sottogruppi chiave.
Linee guida operative per ottimizzare l'accuratezza
Garantire il rigore del processo richiede l'adozione di buone pratiche sistematiche:
Definire con assoluto rigore la popolazione target prima di iniziare qualsiasi operazione.
Selezionare una lista di campionamento proveniente da fonti ufficiali, verificate e complete.
Utilizzare algoritmi e software di randomizzazione certificati, evitando selezioni manuali o arbitrarie.
Validare a posteriori la struttura del campione ottenuto, confrontandone le principali metriche con i parametri noti della popolazione.
Un disegno di campionamento strutturato con rigore scientifico è ciò che eleva una semplice raccolta di dati a evidenza empirica credibile e autorevole.
Progetta il Tuo Campionamento con Rigore Fin dall'Inizio
Quando un campione non rappresenta fedelmente l'universo che si intende indagare, l'autorevolezza dell'intera ricerca ne risente, rallentando il progresso scientifico e sollevando legittimi dubbi metodologici. Anche una minima imprecisione nella selezione dei soggetti può riflettersi negativamente su tutte le fasi successive. Si tratta di un rischio concreto che ogni ricercatore desidera evitare.
<CTA title="Progetta Workflow di Ricerca Più Efficienti" description="Pianifica i metodi di campionamento e struttura la tua ricerca scientifica più rapidamente grazie al supporto etico dell'intelligenza artificiale" buttonLabel="Prova Jenni Gratuitamente" link="https://app.jenni.ai/register" />
L'adozione di Jenni all'interno del proprio workflow accademico consente di pianificare le strategie di campionamento con assoluta chiarezza, mantenendo la ricerca focalizzata sui più alti standard etici e metodologici. Il sistema supporta l'ottimizzazione e la stesura della metodologia, rendendo il lavoro finale solido, trasparente e facilmente difendibile in sede di peer review. È una risorsa preziosa per garantire la massima integrità scientifica ai tuoi risultati.