
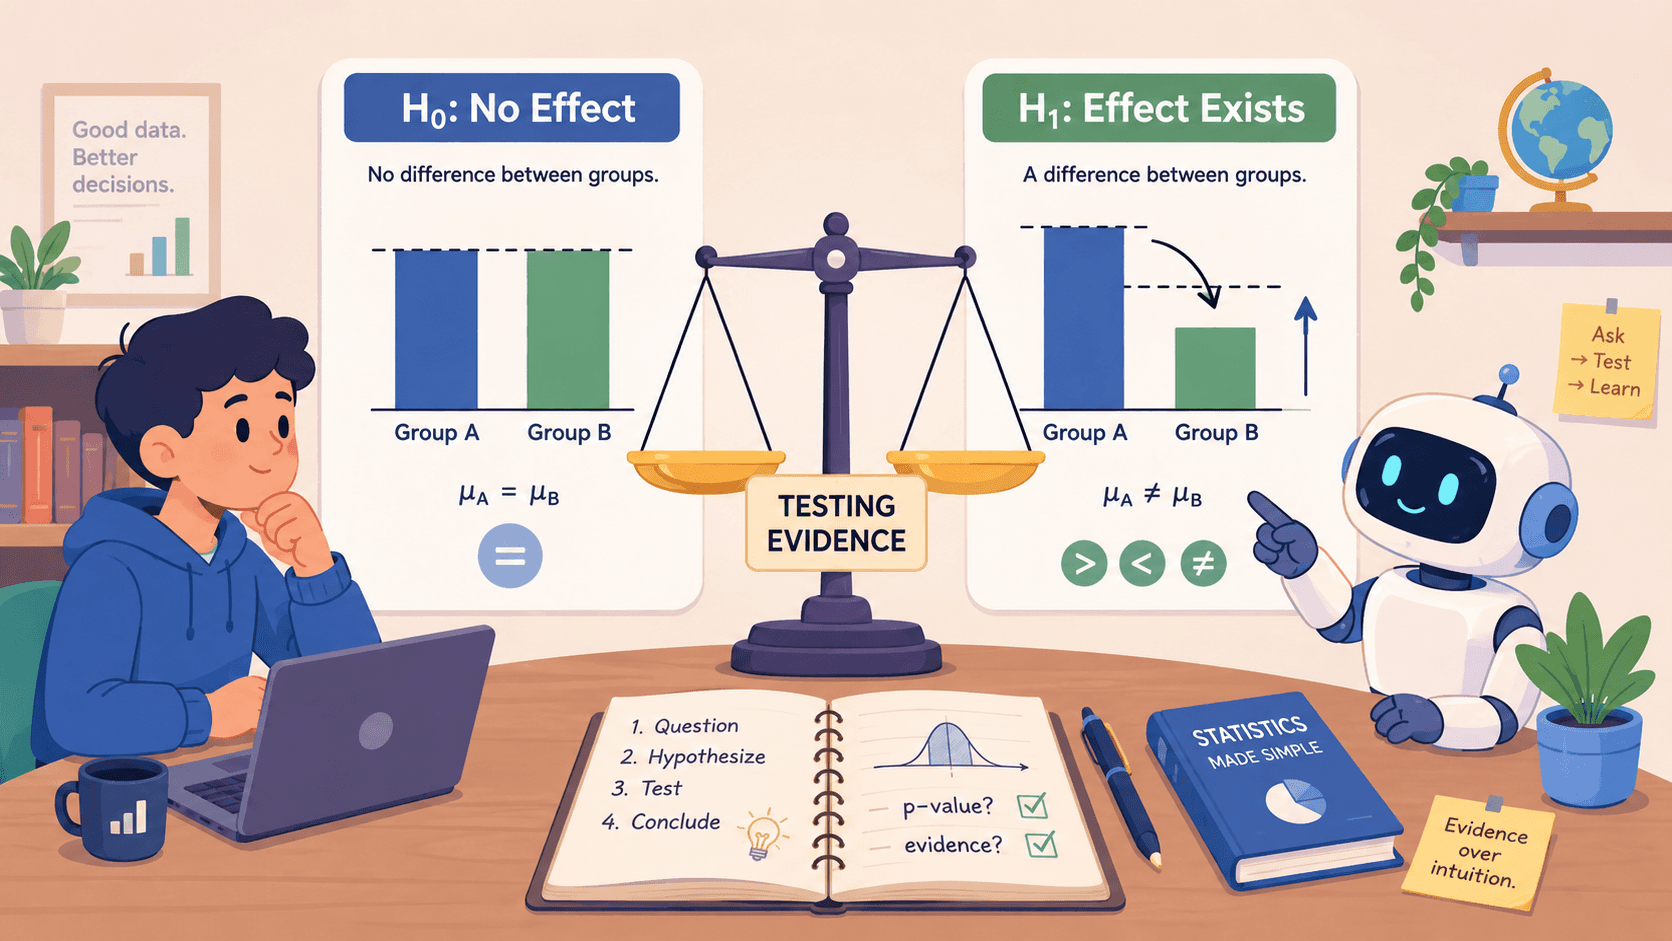
假设检验始于一个简单的问题:这个结果是真实的,还是仅仅是运气使然?这就是零假设和备择假设的作用所在。它们是医学、商业或教育领域的学者在设计检验以探求真相时的正式方式。在每一个利用数据进行决策的研究中,你都会看到它们的身影。
我们将通过实例对其进行拆解,指出人们常犯的错误,并为你提供一份如何撰写假设的直观指南。阅读完本文后,你将准确了解这两个陈述是如何构建起每一次统计调查的框架的。
<CTA title="撰写清晰的研究假设" description="在结构化引导下,将你的研究问题转化为精确且可检验的假设。" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
什么是零假设和备择假设?
这是关于你所研究的总体的一对对立陈述。你可以将它们视为统计学中的“无罪推定”设定。进行检验的全部目的就是为了看看数据实际上支持哪一个陈述。
美国国家标准与技术研究院(NIST)将其定义为零假设和备择假设的过程,即检查你的样本数据是否符合或不符合你最初对总体的假设。
零假设 (H0)
这是默认的、持怀疑态度的立场。它是指假设没有发生任何有趣的事情——没有变化、没有差异,也没有关联。你的目标是收集证据来反对它。
示例:
两种教学方法产生的平均测试分数相同。
一种新药对血压没有影响。
用于学习的时间量不影响最终成绩。
在符号表示中,它通常包含一个等号:
H0: μ₁ = μ₂ (均值相同)
H0: ρ = 0 (相关系数为零)
备择假设 (H1 或 Ha)
这是研究人员实际上相信或想要证明的命题。它指出确实存在某种效应、差异或关系。
示例:
教学方法 A 比方法 B 产生更高的分数。
这种新药可以降低血压。
更多的学习时间与更好的成绩相关联。
它通常使用不等号(≠、> 或 <)来书写:
H1: μ₁ ≠ μ₂ (均值不同)
H1: μ₁ > μ₂ (第一个均值较大)
H1: μ₁ < μ₂ (第一个均值较小)
<ProTip title="💡 专家提示:" description="在零假设中始终包含等号,以符合统计检验的逻辑。" />
为什么零假设与备择假设会令如此多学生感到困惑
这是一个常见的瓶颈。你或许可以读懂定义,但在逻辑上为什么我们要这样设定往往难以理清。以下是通常导致困惑的原因。
“为什么我不能把它们互换?”的问题
许多学生都会问这个问题。如果你相信备择假设是真的,为什么不直接把它设为零假设呢?原因在于机制本身:统计检验的数学计算是从假设零假设正确开始的。
你计算的所有概率,例如著名的 p 值,都是基于该起点。如果将它们互换,就会破坏底层的运算机制。
为了更深入地了解这如何融入更广泛的科学框架,理解不同的研究范式有助于澄清我们为什么要采用这种特定的怀疑论方法。
这里用一个法庭的比喻非常恰当:
H0: 被告是无罪的。
H1: 被告是有罪的。
法庭审判并不会试图去证明无罪,而是询问证据是否足够强,以至于可以拒绝无罪推定。
这种挫败感是普遍存在的
在学习论坛上,你会一遍又一遍地看到相同的帖子:
“这一章我已经读了三遍了,还是摸不着头脑。”
“我在课堂上听懂了,但自己就是不会应用。”
当这个概念被纯粹作为符号和规则来传授,而脱离了任何实际应用时,通常就会发生这种情况。
如何才能真正掌握它
你需要看到它的实际应用。在具体的场景中,这个框架就会立即变得清晰合理:
对网站按钮进行 A/B 测试。
确定一种新药是否比安慰剂效果更好。
比较两个课程体系下的学生表现。
在套用任何公式之前,针对一个具体且切实的实际问题写出这一对假设,才是建立真正理解的关键。
从研究问题到假设:一个简单的过程
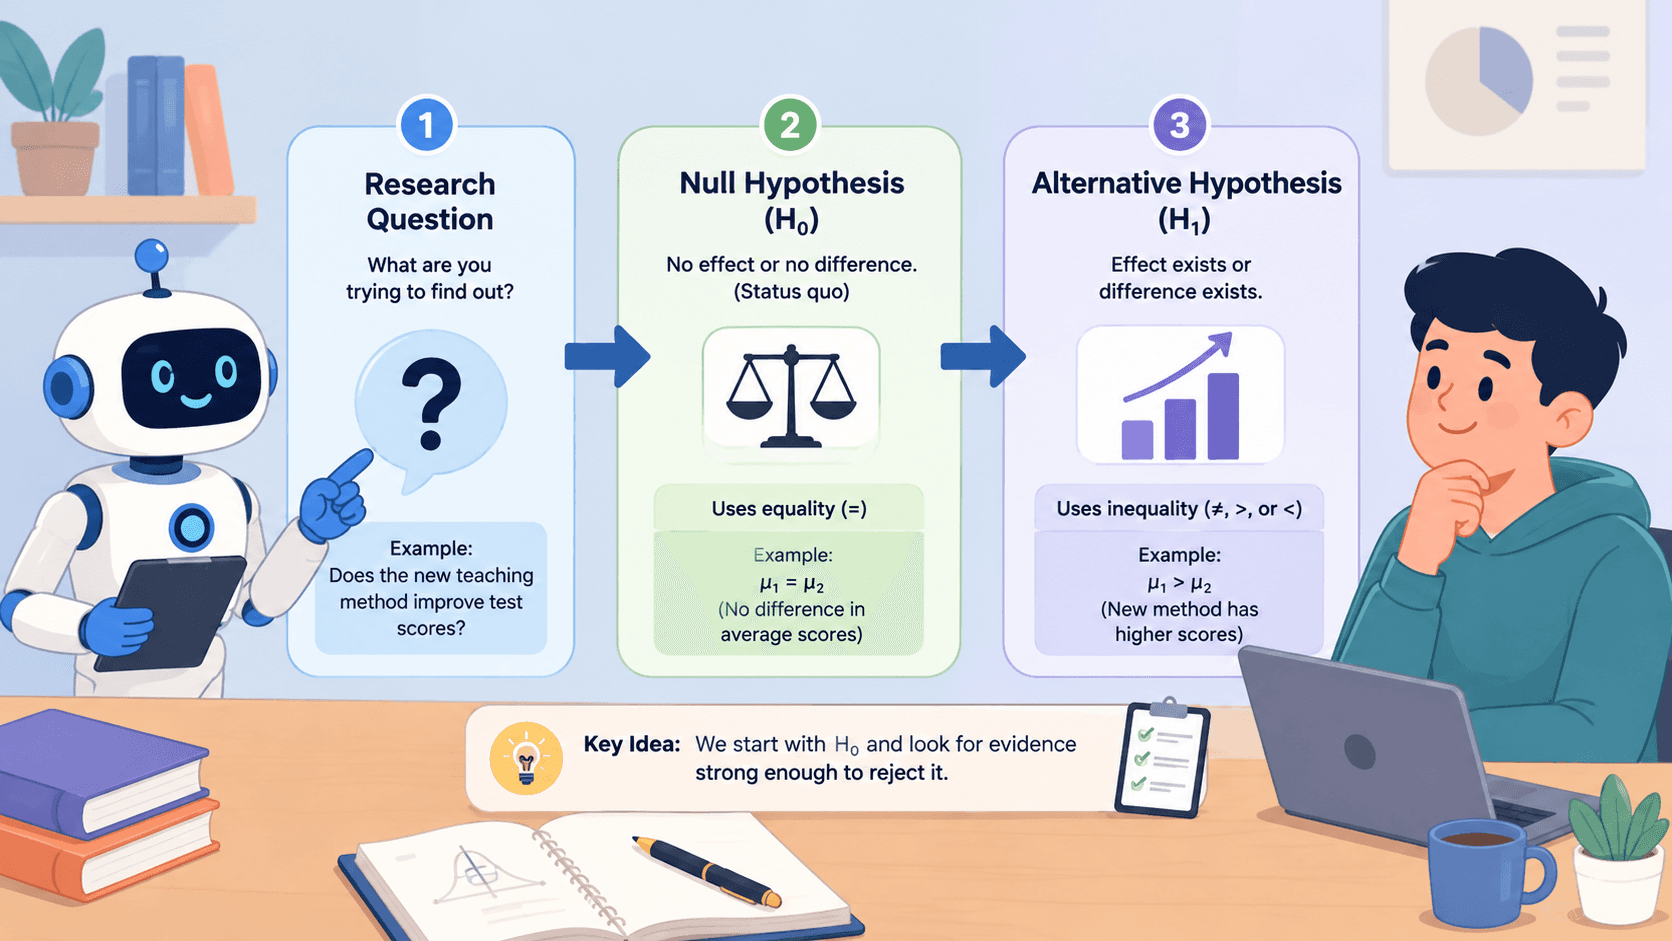
这是一个包含三个步骤的过程。其目标是提取一个宽泛的研究想法,并将其转化为具体且可检验的一对陈述。
第 1 步:提出一个直接的问题
从具体的事物开始,避免模糊的概念。了解如何有效地撰写研究问题是通往有效假设的第一步。
示例: 新的教学方法是否会带来更高的期末考试分数?
第 2 步:明确你正在测量的内容
请记住,你是在对整个总体(例如所有学生)做出声明,而不仅仅是研究中的样本。定义关键参数。
这通常是总体均值 (μ)、两个均值之间的差值 (μ₁ - μ₂) 或相关系数 (ρ)。
第 3 步:写出这两个假设
现在,将你的问题转化为正式的 H0 和 H1。零假设总是陈述“无效应”,备择假设则陈述你正在寻找的具体效应。
H0: μ_新方法 = μ_传统方法 (平均分数无差异)
H1: μ_新方法 > μ_传统方法 (新方法带来了更高的平均分数)
在进行定性与定量研究时,这种结构化的方法至关重要,因为它能确保你的数据收集专注于证明或推翻某个特定声明。
现实世界中的一个例子:睡眠与成绩
一位心理学家想知道睡眠不足是否会损害学术表现。
H0: 睡眠不足和休息充足的学生的平均测试分数相同。(μ_不足 = μ_充足)
H1: 睡眠不足的学生的平均测试分数较低。(μ_不足 < μ_充足)
这种高度精确的结构是心理学研究、药物试验和市场测试的核心支柱。
<ProTip title="💡 专家提示:" description="在收集数据之前撰写假设,以避免解释中的主观偏见。" />
单侧假设与双侧假设
你的备择假设不仅关系到是否存在某种效应,还关系到你正在寻找哪种类型的效应。这一选择是零假设和备择假设设计的基础部分。
单侧检验 (有方向性)
这侧重于寻找一个特定方向的变化。你有充分的理由相信该效应只会朝一个方向发展。
符号: H1: μ₁ > μ₂ 或 H1: μ₁ < μ₂
示例: 你正在测试一种肥料。你的假设是它能促进植物生长 (μ_施肥 > μ_对照)。你不会去测试它是否会减缓生长。
适用场景: 当先前的研究或理论对效应的方向给出了明确的预测时。
双侧检验 (无方向性)
这侧重于寻找任何差异,而不考虑方向。这是一种更为保守、不预设立场的方法。
符号: H1: μ₁ ≠ μ₂
示例: 你正在比较两种止痛药。你只想知道其中一种的效果是否与另一种不同,无论是更好还是更差 (μ_A ≠ μ_B)。
适用场景: 当你正在探索一个新领域,或者任何方向的效应都具有意义时。
快速横向对比
类型 | H1 中的符号 | 你的探究方向 |
单侧 | > 或 < | “A 组是否明确大于(或小于)B 组?” |
双侧 | ≠ | “A 组和 B 组之间是否存在差异?” |
在看到数据之前,你必须决定哪一个更符合你的研究问题。选择错误的方法可能会导致你遗漏真实的发现,或完全误读你的研究结果。
假设检验实际上是如何运作的
这个过程并不是要证明你的想法是正确的。它是要检查数据是否使你最初的、持怀疑态度的假设看起来不太可能成立。
基本逻辑
你首先要假定零假设 (H0) 是绝对正确的。然后你问自己:“如果 H0 是真的,那么我实际收集到的数据该有多令人惊讶?”
p 值就是这个问题的答案。如果零假设是正确的,仅凭随机机会看到你的研究结果(或更极端的情况)的概率就是 p 值。
一个很小的 p 值意味着在零假设下你的数据是不寻常的。而一个很大的 p 值则意味着如果零假设为真,你的数据完全在预料之中。
然而,我们在解释时必须谨慎。发表在《自然》(Nature on significance testing) 上关于显著性检验的研究指出,p 值经常被误解;它们并不告诉你你的假设为“真”的概率,而是说明你的数据与零假设的相容程度。
显著性水平,即 alpha (α),通常设定为 0.05 (5%)。
你需要一个临界点来决定什么算作“太令人惊讶”。
如果 p 值 ≤ α (例如 ≤ 0.05): 认为数据在 H0 下太不可能发生。你拒绝零假设。
如果 p 值 > α (例如 > 0.05): 数据没有反常到需要抛弃 H0。你未能拒绝零假设。
你并没有说什么
这是一个至关重要的区别。拒绝 H0 并不意味着你已经“证明”了备择假设 (H1) 是正确的。它只意味着证据足够强大,可以对零假设提出严重质疑。
你可以把它想象成法庭裁决。一个“有罪”的判决并不能绝对证明有罪;它意味着证据足以拒绝无罪推定。同样地,你永远不要去“接受”H0 或“证明”H1。你只是找到了足够的证据来拒绝 H0,或者没有找到。
<ProTip title="💡 专家提示:" description="在学术写作中,使用“未能拒绝零假设”而不是“接受零假设”。" />
假设检验中的常见错误
假设检验有几个经典的陷阱。了解它们可以帮助你避免从数据中得出错误的结论。
错误 1:针对样本撰写假设
你的假设是对你所研究的整个群体(即总体)的声明。而你的数据只是其中的一个样本。
错误示范: “A 组的样本均值大于 B 组。”
正确示范: “A 组的总体均值 (μ) 大于 B 组。”
错误 2:宣称你“接受”了零假设
你永远无法接受零假设。检验只能告诉你是否有足够的证据去推翻它。正确但听起来稍微冗长的表述是“我们未能拒绝零假设”。
这种措辞正确地暗示了数据只是不够强大,无法说服我们做出相反的结论;它并没有证明零假设是正确的。
错误 3:忘记了两类错误
每一个统计决策都伴随着犯错的风险。你需要知道它们是什么。
第一类错误 (假阳性): 当零假设实际上为真时拒绝了它。(你看到了一个实际上并不存在的效应。)
第二类错误 (假阴性): 当零假设实际上为假时未能拒绝它。(你漏掉了一个真实的效应。)
显著性水平(α,如 0.05)直接就是犯第一类错误的概率。
错误 4:将 p < 0.05 视为神迹
一个结果在统计上可能是“显著的”(p < 0.05),但在现实世界中可能微不足道。如果你有一个庞大的样本,你就可以检测到微小且毫无意义的差异。
相反,如果你的样本太小,一个重要的发现可能无法达到 p < 0.05。p 值告诉你的是可靠性,而不是效应的大小或重要性。
假设检验的真实世界示例
这个框架不仅仅存在于教科书中。它是许多领域中进行数据驱动决策的标准方法。
商业:网站的 A/B 测试
一个电子商务团队想知道重新设计的“立即购买”按钮是否会表现得更好。
H0: 新按钮的点击率与旧按钮相同。
H1: 新按钮的点击率更高。他们运行检验、分流流量并收集数据。如果结果强烈反驳 H0(低 p 值),他们就会在全公司推广新设计。如果不是,他们会坚持原版设计。
医学:临床药物试验
在一种新药被批准之前,它必须在对照试验中表现优于安慰剂。
H0: 该药并不比糖片更有效。
H1: 该药比安慰剂更有效。在这里,拒绝零假设不仅仅是一个学术问题,它是迈向监管部门批准和改变医生治疗疾病方式的关键一步。
教育:评估新课程
一个学区在半数教室中试点了一项新的数学计划。
H0: 在新计划和旧计划下,学生的熟练度是相同的。
H1: 在新计划下,学生的熟练度更高。从该检验中得出的统计结论将直接影响关于明年教什么的重大(且昂贵的)决定。
为什么滥用零假设可能非常危险
滥用这一统计工具不仅会导致糟糕的科学,还可能带来现实世界的后果,从浪费金钱到危害公共健康。
P 值的操纵(P-Hacking)问题
想象一下,一位研究人员测量了 20 种不同的结果。如果他们以 0.05 的显著性水平运行 20 次独立的检验,纯粹由于偶然性,即使实际上什么都没有发生,其中一次检验也会显示出“显著的”结果。
这种被称为“p 值操纵”的做法制造了虚假的发现。这就是为什么小型探索性研究的发现往往无法在更大、更严谨的试验中重复出来。
常见的误读
人们常常从结果中得出错误的结论:
“我们未能拒绝 H0,因此没有任何效应。” 这是不正确的。一个不显著的结果往往只是意味着你的研究没有足够的效能来检测到该效应。这是“缺乏证据证明存在”,而不是“证据证明不存在”。
忽略样本量的作用。 一项极小规模的研究可能会发现巨大的效应,但无法达到统计显著性。而一项大规模的研究可能会发现一个微不足道的、但在统计上显著的效应。在考虑 p 值的同时,必须结合实际效应的大小来进行评估。
当零假设本身不切实际时
在许多领域,特别是社会科学或生物学中,绝对零效应的观点是一种统计虚构。事物之间几乎总会存在某种微小的差异或相关性。
检验一个不切实际的“无效应”零假设可能会导致对统计显著性的盲目追求,而忽略了该发现是否有意义或有用。关注的焦点可能会从“这重要吗?”转变为简单的“我能得到 p < 0.05 吗?”
<ProTip title="💡 专家提示:" description="将统计显著性与实际显著性相结合,以做出更好的决策。" />
更清晰的假设检验路径
假设检验有时会令人感到困惑。这种结构有助于使你的分析保持逻辑性和一致性。
遵循以下步骤
从一个精确的研究问题开始。你实际想弄清楚的是什么?
弄清楚你感兴趣的总体参数,例如均值或比例。
构建你的零假设 (H0)。它应该始终陈述一种相等或“无效应”的状态。
构建你的备择假设 (H1)。这陈述了预期的变化方向或差异。
决定你的检验类型。它是单侧(寻找特定方向的变化)还是双侧(寻找任何差异)?
收集你的数据,并运行计算以获得你的检验统计量。
谨慎地解释 p 值。理解它对于反对 H0 的证据实际上告诉了你什么。
使用此顺序可以防止你混淆假设或误用检验。它将一个模糊的概念变成了一个清晰的流程。
让假设检验最终豁然开朗
你总是对哪个假设起什么作用感到犹豫不决。当你试图应用它时,这个逻辑就是无法在脑海中固定下来。当术语听起来非常相似且含义悄然滑走时,事情很快就会变得令人困惑。
<CTA title="将研究问题转化为清晰的假设" description="通过结构化的写作和引导式的假设构建,建立强大的统计推理能力。" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
假设检验不是死记硬背符号,而是理解一个逻辑框架。从一个清晰的研究问题开始,将零假设写为“无效应”,并让数据告诉你是否有足够的证据拒绝它。这一转变会让你的统计推理感到扎实,而不再是捉摸不定。