
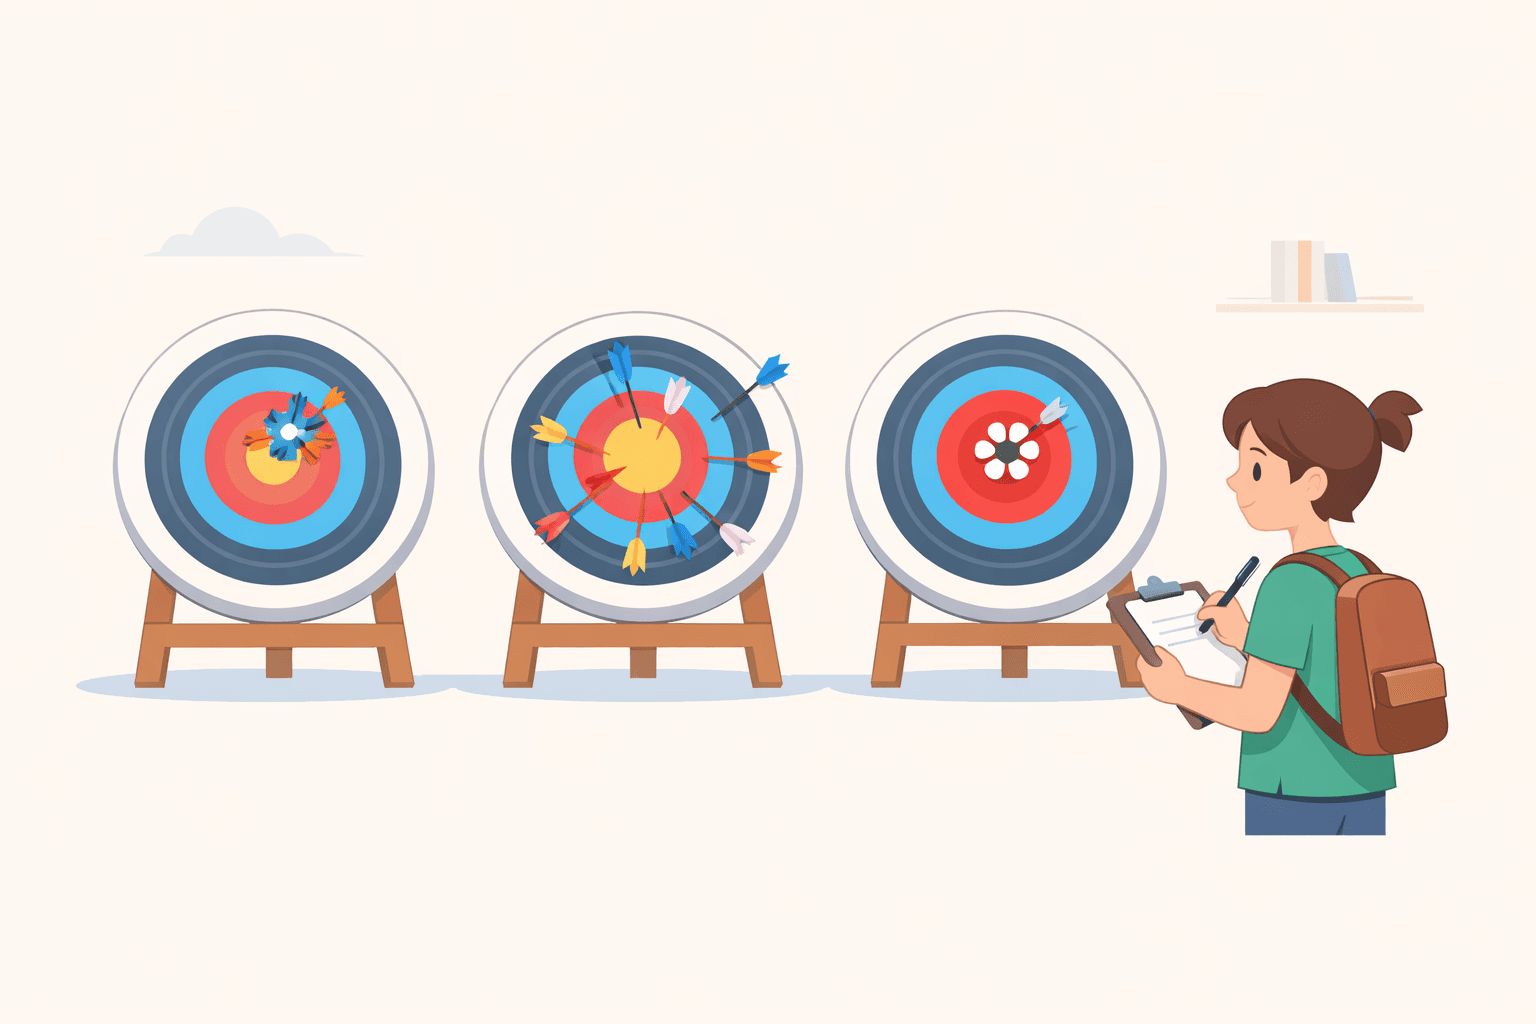
效度探讨的是您的研究是否真正测量了其声称要测量的内容。信度则检验如果重新进行该项研究,您是否会获得相同的实验结果。无论项目资金多么充足,粗糙的设计或模糊的测量工具都可能使这两者毁于一旦。
本指南为您提供了具体的解决步骤。我们将通过清晰的实例,展示如何提高测量精度、严密规划研究设计并解决常见的数据问题。请继续阅读以获取实用的解决方案。
<CTA title="强化您的研究设计" description="在数分钟内构建结构化、清晰且具有说服力的研究框架,告别困惑。" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
步骤 1:精确定义和测量构念
在研究任何事物之前,您需要先明确其定义。模糊的概念会导致不稳固的研究结果。
以“压力”或“学习”这类宽泛的概念为例,您无法对其进行直接测量。您必须将它们转化为可以实际计数或评分的具体指标。这一过程被称为变量的操作化。
压力可以操作化为血液样本中测得的皮质醇水平,或是使用李克特量表的问卷得分。
学习可以通过测试成绩或个体在特定任务中的表现来定义。
这种从理论到测量指标的转化,是确保构念效度的首要且最关键的一步。它能确保您的数据切实反映您的研究设想。
如果已存在优秀的测量工具,就无需“重新发明轮子”。使用经过验证的成熟量表可以减少误差,并提升研究的学术公信力。
此类工具通常自带内部一致性信度评分,例如克隆巴赫系数(Cronbach's alpha)在 0.7 以上,这是学术界常用的基准值。
美国国家卫生研究院(NIH)指出,在研究中采用已确立且经过验证的工具,能够显著提高测量精度。
一份优秀的测量工具通常包含以下方面的文献记录:
如何确立其内容效度(是否涵盖了该概念的所有核心维度?)。
其效标关联效度的证据(是否与已知的“金标准”相一致?)。
在以往使用中表现出的信度评分。
您还需要检验不同类型的效度。它们不可互换,各自检验着研究图景的不同部分。
内容效度:您的测量指标是否涵盖了该概念的所有重要维度?
构念效度:您的测量指标的表现是否符合您的理论预测?
效标关联效度:您的测量指标是否与另一项公认的同类测量指标高度相关?
兼顾这三者可以确保您的研究发现具有实质意义,而不仅仅是呈现出“一致的错误”。
<ProTip title="💡 专家建议:" description="使用经过验证的量表,快速减少测量误差并提升研究公信力。" />
步骤 2:强化研究设计并控制偏差
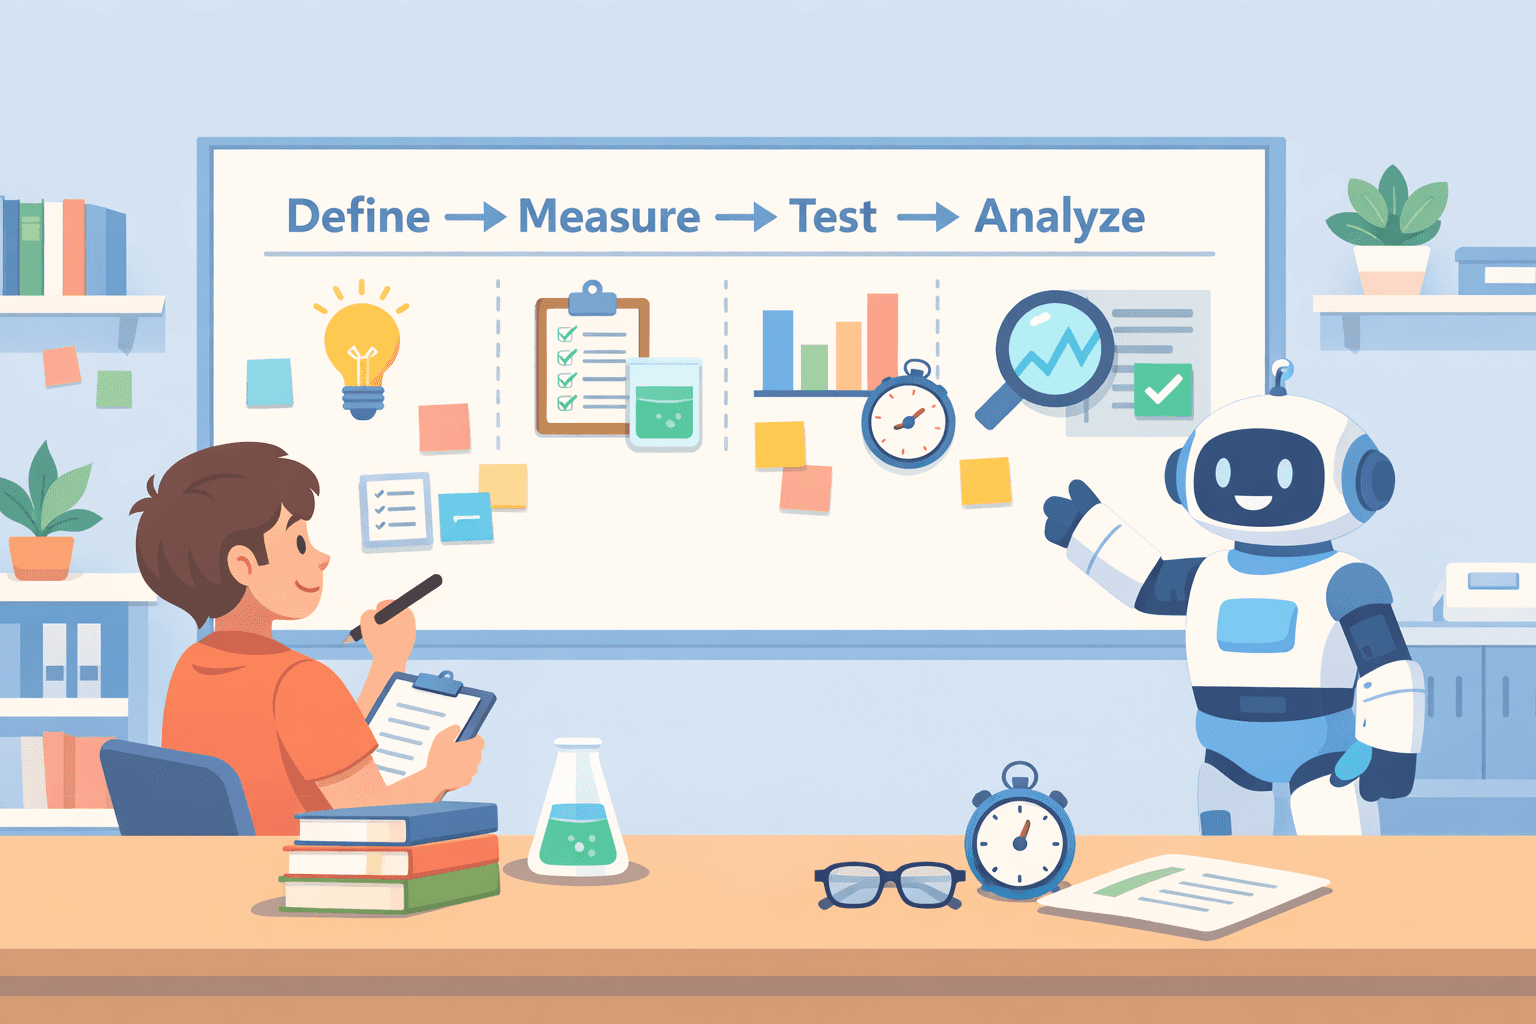
研究设计是研究的骨架。骨架软弱,一切都会瓦解。
首先,确保您的设计确实契合您提出的研究问题。如果您想探究 A 是否导致 B,您需要进行实验研究。问卷调查无法为您提供因果关系解答。
采用正确的方法可以强化研究的内部效度,并使您的统计结果更易于解释。
您还必须控制混杂变量。在医学试验中,随机分配和双盲程序等标准技术被专门用于减少系统性偏差。
世界卫生组织指出,更佳的准实验实践和控制组设计能够显著提升研究的置信度。
其次,实施标准化流程。向每位受试者提供完全相同的指导语;在相同的环境下进行测试;保持时间间隔的一致性。
这能减少数据中随机噪声的干扰,也是保障测量信度的一种直接方法。微小的不一致(例如问题措辞的细微变化)可能会悄无声息地降低整个数据集的信度。
最后,切勿忽略预实验(Pilot Test)。在正式开始大规模研究之前,先在 10 至 20 人的小群体中运行完整流程。这种演练有助于您发现含糊不清的问题、调整不合理的时间安排,并及时捕捉信度偏低的早期信号。
这是在您为大型项目投入时间与资源之前,提高效度和信度最快速、最实用的方法之一。
<ProTip title="⚠️ 温馨提示:" description="程序中微小的不一致可能会悄然降低整个数据集的信度。" />
步骤 3:优化抽样与推广性
研究对象的选择与研究方法同等重要。您的抽样方法决定了您的研究发现是否能够推广至具体受试群体之外。
为了提高推广性,应尽可能使用概率抽样。这意味着目标总体中的每位成员都有已知的被选中概率,从而使您的样本更具代表性并减少偏差。常见的概率抽样方法包括:
随机抽样
分层抽样
整群抽样
扩大样本量会有所帮助,但它并非灵丹妙药。如果您的测量工具本身存在缺陷,更大的样本量只会让这种缺陷变得更加稳定和明显。务必坦诚地说明您抽样方法的局限性。
理解信度与效度之间的本质区别,有助于您认识到:如果研究基础不牢固,偏差会随着样本量的增加而同比例放大。
这就是为什么提高测量精度比单纯追求大样本量(N值)更为重要。务必对您的抽样局限性保持透明。
坦诚地报告纳入(和排除)了哪些群体、您是如何招募受试者的,以及可能存在哪些偏差,实际上反而会增强您的学术公信力。即使在研究设计面临实际客观限制时,这也能建立起学术信任。
步骤 4:通过一致性提高信度
信度关注的是一致性。如果您再次进行测量,或者换一个人进行测量,能否获得相同的结果?
如果需要由他人来收集或对您的高质量数据进行编码,他们必须接受规范的培训。缺乏一致性的评估者会引入不必要的随机误差。
通常使用培训课程和校准演练来提高评分者间信度(不同人员之间的一致性)以及评分者内信度(同一个人在不同时间点的一致性)。
您可以使用 Cohen's kappa 或组内相关系数(ICC)等统计指标进行量化评估。此外,您的问卷设计至关重要。糟糕的问题会同时破坏效度和信度。
避免使用会暗示特定答案的诱导性问题。
避免使用同时询问两件事的双重问题(例如,“您觉得这款软件实用且易于使用吗?”)。
避免使用可能产生歧义的模糊措辞。
应专注于使用清晰、中立的语言表达。
最后,不要依赖单一测量指标。采用多种方法进行检验。在定量研究中,利用重测信度方法。在定性研究中,采用三角互证(Triangulation),结合访谈、观察和文献分析,以验证您的结论是否站得住脚。
了解研究中的各种信度类型可以帮助您为数据选择最合适的检验方法。
在定量研究中,使用多题项量表和重测信度(对相同受试者进行两次测量)。
在定性研究中,使用三角互证。结合访谈、观察和文献分析,以检验您的结论在不同数据源之间是否保持一致。
<ProTip title="💡 专家建议:" description="三角互证通过跨方法或跨数据源验证结果,从而增强研究发现的稳健性。" />
步骤 5:强化定性研究的效度与信度
对于定性研究而言,研究目标是可信度和深度,而非单纯的数据一致性。因此,其采取的策略也有所不同。
一种有力的方法是成员检验(Member Checking)。在分析完数据后,您返回受试者处,让他们评估您的解读是否准确。
您的分析总结是否符合他们的真实经历?这一步骤起到现实检验的作用,能显著提高您研究发现的可信度。
您还需要保持详细的审计追踪(Audit Trail),记录研究过程中做出的每一项决策。
这有助于保证研究的依赖性。此外,通过深入理解定性研究与定量研究的细微差别来优化您的方法;例如,定性研究高度依赖反思性,即您需要主动审视并承认自身的偏见。
审计追踪应当包括您对数据如何编码的笔记、收集过程中的观察记录,以及您作为研究者的自我反思。
这些文献记录保障了您研究的可靠性,清晰地展示了您得出结论的逻辑路径。
核心实践是将三角互证与反思性相结合。反思性意味着主动承认您作为研究者的个人偏见和视角。
随后,您将这种自我意识与三角互证结合,使用多种研究方法(如访谈和观察)或从不同来源收集数据。
这些实践共同增强了您研究的确证性,使您的结论更加稳健。
<ProTip title="🧠 深度洞察:" description="在定性分析中,反思性有助于您将客观解读与主观偏见分离开来。" />
步骤 6:利用统计和分析保障措施
统计分析不仅用于寻找研究结果,更用于检验数据的完整性。
首先,使用特定测试评估信度。常见方法包括:
克隆巴赫系数(Cronbach's alpha)(检验量表的内部一致性)
折半信度
等值复本信度
通常,克隆巴赫系数高于 0.7 是衡量信度可接受的常用(但非绝对)基准。
其次,运行稳健性检验和敏感性分析。观察在改变分析条件时,您的核心发现是否依然成立。
尝试剔除异常值、微调模型假设,或采用完全不同的分析方法。如果研究结果保持稳定,则是信度表现强劲的积极信号。
最后,使您的分析与已确立的研究范式保持一致,确保您的分析保障措施与理论框架相匹配。
如果您的统计检验显示信度较低,应将这些发现视为初步结果。避免基于薄弱的数据得出强烈的、确定性的结论。
避免从薄弱的数据中得出强烈的、确定性的结论。这能维护您的学术声誉,并促进您研究的整体可重复性。
快速对比:效度 vs 信度
理解两者的区别有助于您进行针对性的提升。
维度 | 效度 | 信度 |
定义 | 衡量准确性。您测量的是正确的对象吗? | 衡量一致性。再次测量能获得相同的结果吗? |
关注点 | 研究结果的正确性。 | 研究结果的稳定性。 |
示例 | 您的测试真正测的是智力,还是仅仅反映了应试技巧? | 如果对同一个人测量两次,得分是否大致相同? |
关键方法 | 构念效度验证、三角互证。 | 重测信度、克隆巴赫系数。 |
风险 | 测量了错误的构念。 | 获得不一致的结果。 |
两者缺一不可。信度高但无效的数据是“一致的错误”;有效但不可靠的数据则无法令人信服。
破坏效度与信度的常见错误
研究者常落入相同的陷阱,这些问题会削弱研究质量,并频繁出现在同行评审的意见中。
以下是一些常见错误:
过度依赖样本量而忽视测量质量。 误以为更大的样本量(N)能解决所有问题,而实际上,工具的缺陷只会让偏差在统计上更趋于稳定。
单纯为了提高克隆巴赫系数而删减题项。 为了达到 0.7 这一魔法数字而盲目修改问卷,却不顾此举是否会损害量表的内容效度。
使用便利样本而不承认其偏差。 仅调查易于接触到的群体,却未明确说明这将如何限制研究结果的适用范围。
跳过预实验。 如果省略试运行,您可能会因为没有提前测试而收集到糟糕或含糊不清的数据。
忽视混杂变量。 未在研究设计中控制可能解释您研究结果的其他因素,从而在您的论证中留下了重大漏洞。
<ProTip title="⚠️ 警告:" description="如果盲目操作,通过删减题项来提高信度可能会削弱构念效度。" />
让您的研究经得起审视
当研究结果不够一致或在评审中显得站不住脚时,您一定深感沮丧。这不仅延误了整体进度,还会让您对自己的学术成果产生自我怀疑。定义或流程中的微小漏洞都可能使最终结果产生偏差。这正是核心痛点所在。
<CTA title="设计经得起同行评审的研究" description="快速将您的研究设想转化为结构化、高信度且高教度的框架。" buttonLabel="免费试用 Jenni" link="https://cn.app.jenni.ai/register" />
使用 Jenni 能够帮助您从头到尾保持研究的严密性与可追踪性。它能辅助您定义、构建和记录研究工作,确保您的结果清晰一致。这是避免繁琐修改并对您的学术展示充满信心的简便途径。