
要研究一個龐大的群體,您可以隨機抽取其中的一小部分。這種方法稱為隨機抽樣,它讓每個人都有均等的機會被選中。它是醫學和民意調查等領域中值得信賴的研究基礎。
本指南將向您展示它是如何運作的、有哪些不同的可用技術,以及如何將它們應用於實際專案中。準備好學習了嗎?
<CTA title="構建更好的研究樣本" description="更快速地建立結構化抽樣計畫,並減少研究過程中的偏差" buttonLabel="免費試用 Jenni" link="https://app.jenni.ai/register" />
隨機抽樣在實踐中的真實意義
在實踐中,隨機抽樣意味著完全憑機率選擇受試者,這比聽起來要困難得多。
世界衛生組織指出,這種無偏見的方法是準確估算人口的關鍵。
一個好的樣本能反映出完整群體的年齡、收入和其他特徵的組合,這對於像迴歸分析這樣的測試至關重要。理論很簡單,但執行往往會失敗。
研究人員經常面臨參與者名單不佳等問題,迫使他們妥協於並非真正隨機的「足夠隨機」的方法。這種區別通常是學術界不同研究範式的分水嶺。
對於一個真正的隨機樣本,您需要三樣東西:
該群體中每個人的完整名單。
每個人被選中的已知機率。
基於隨機性而非便利性的選擇過程。
偏離這些規則,哪怕是一點點,都會引入偏差並使您的結果產生偏差。
<ProTip title="💡 專家提示:" description="在選擇參與者之前,務必核實您的抽樣框,以避免隱藏的偏差" />
核心隨機抽樣方法解析
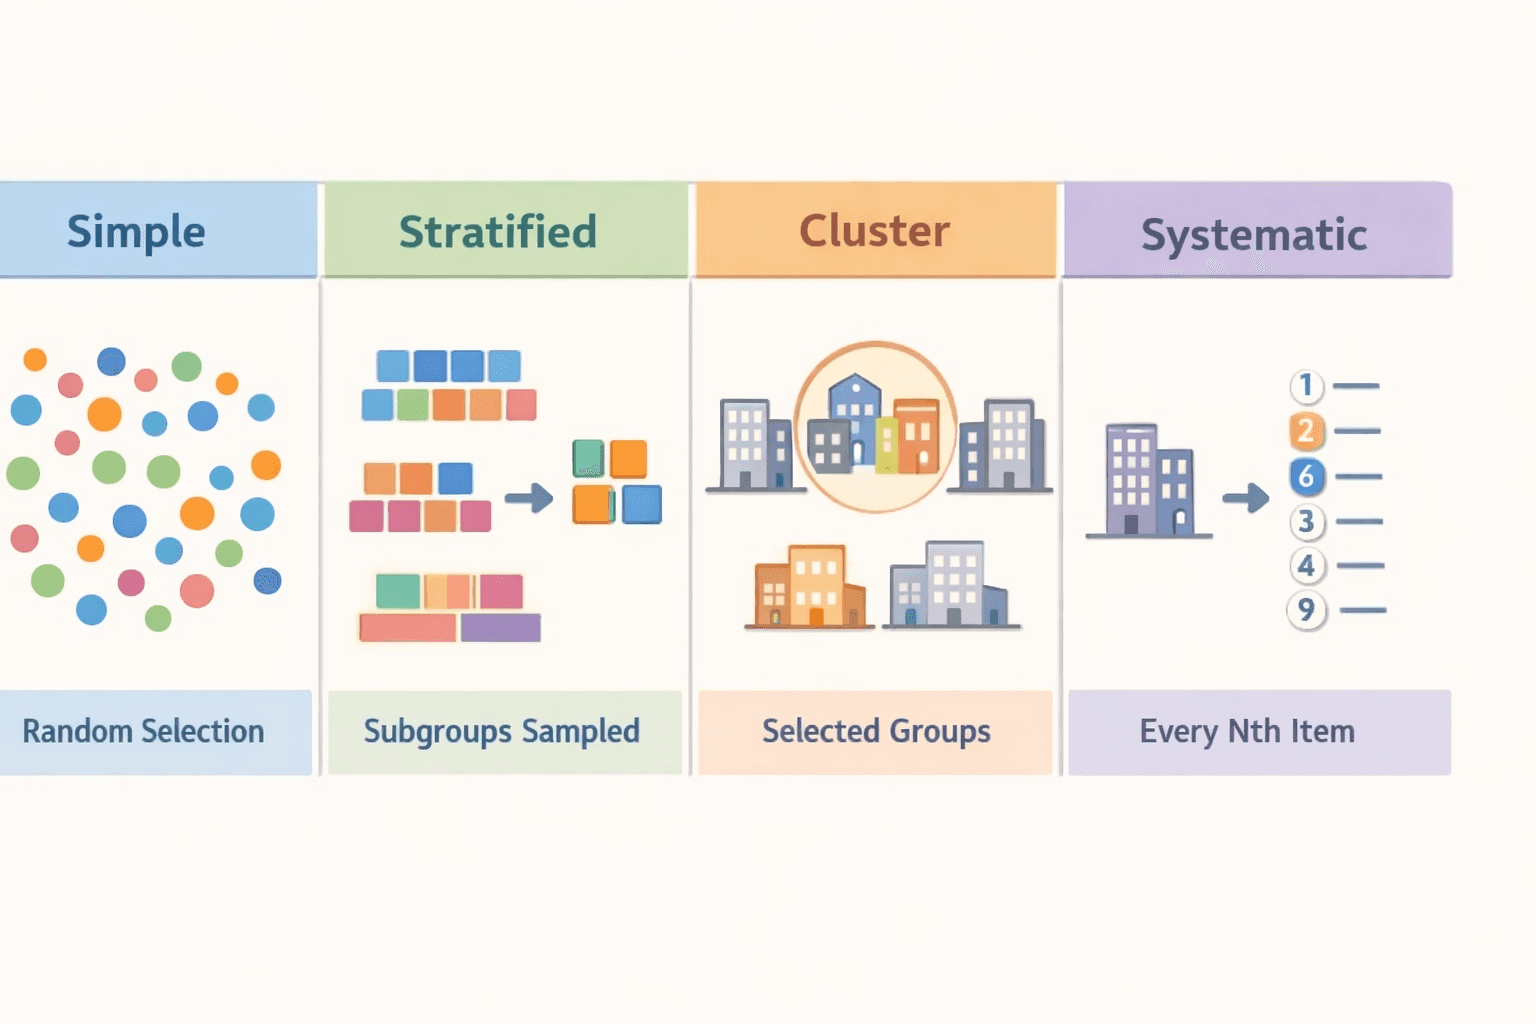
不同的技術以結構化的方式應用隨機性。最佳選擇取決於您的研究設計(無論您是在進行定性還是定量研究)以及您正在觀察的群體規模。
簡單隨機抽樣(純粹形式)
在這裡,每個人都有相同的機會被選中。研究人員通常使用隨機數生成器或抽籤式的抽取方式。
想像一個有 500 名學生的班級。您會給每個人一個編號,然後使用生成器選出其中的 50 個人。這就是教科書上的例子。
其統計效力很高,但它取決於是否擁有整個群體的完美、完整名單。如果您的名單有缺陷,結果也會有缺陷。
分層隨機抽樣(用於平衡代表性)
這種方法在從每個子群體中進行隨機抽樣之前,先將總體劃分為不同的子群體,如年齡段或收入水平。它能確保這些關鍵類別得到適當的代表。
例如,一項健康調查可能會按年齡年代(20-29 歲、30-39 歲等)進行分層,以確保所有群體都根據其在總體中的比例被納入。
其主要好處是減少樣本的變異性,並獲得每個子群體更準確的畫像。它被廣泛應用於市場研究等領域。
整群抽樣(對大群體高效)
與其選擇個體,不如隨機選擇整個預先存在的群體或「群集」,例如隨機選擇五所學校並調查其中的所有學生。
這是針對地理分佈分散的人口最常用的機率抽樣方法之一。
這種方法減少了旅行、時間和成本,這對於龐大且分散的人口來說是一個主要優勢。折衷之處在於,它通常比分層等方法引入更多的抽樣誤差。
系統抽樣(結構化隨機性)
在選定一個隨機起點後,您從名單中選擇每第 n 個人,例如數據庫隊列中的每第 10 個客戶。
它實施起來很簡單,但隱藏著風險。如果名單中存在循環模式(例如,每第 10 個條目總是經理),您的樣本就會產生偏差。
方法對比
方法 | 最佳應用場景 | 主要優勢 | 關鍵局限 |
簡單隨機 | 存在完整名單的較小群體 | 統計準確性高 | 需要完整、準確的名單 |
分層 | 具有重要且多樣化子群體的群體 | 確保關鍵特徵的代表性 | 規劃和執行更為複雜 |
整群 | 龐大且地理分散的群體 | 非常實用且具成本效益 | 通常具有較高的抽樣誤差 |
系統 | 無隱藏模式的有序數據集 | 實施簡單快速 | 易受名單中週期性偏差的影響 |
所有這些方法都支持機率抽樣的核心理念,但每種方法都伴隨著影響最終數據的實際權衡。
<ProTip title="📊 專家提示:" description="當群體規模或行為存在顯著差異時,請使用分層抽樣" />
逐步隨機抽樣流程
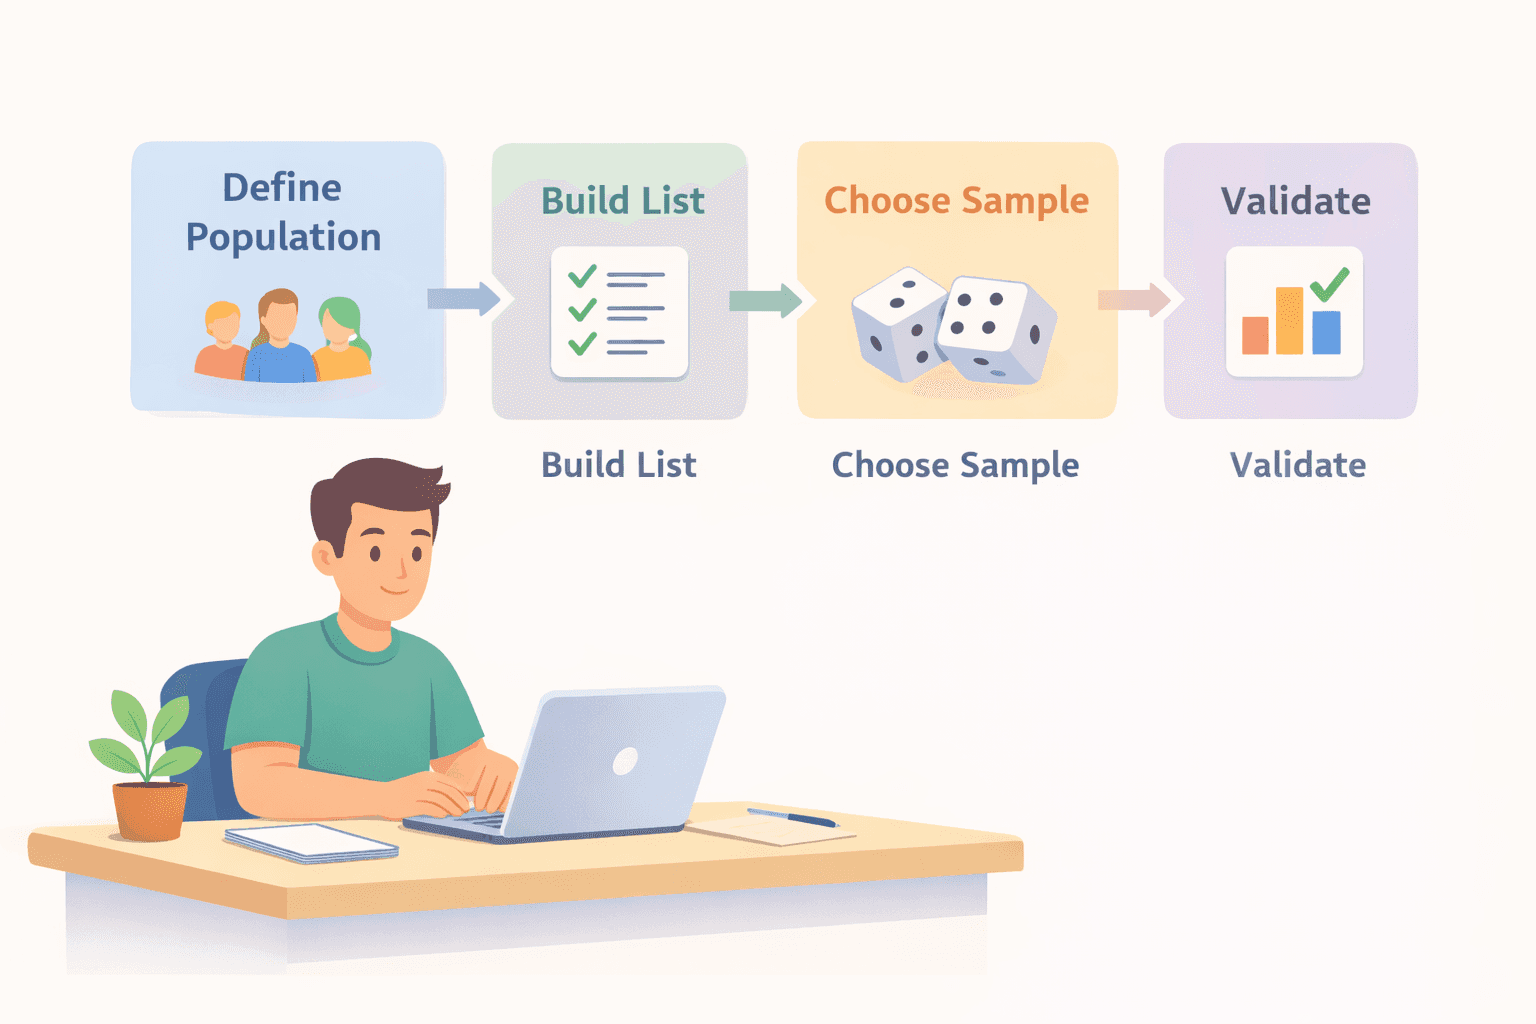
正確進行隨機抽樣意味著遵循清晰的順序。如果您跳過某個階段,您的數據很容易變得偏頗或無效。
步驟 1:定義您的群體和範圍
首先確切決定您要研究誰或什麼。要具體,與其說是「年輕人」,不如將其定義為「2024 年入學的泗水所有大學生」。這個最初的決定塑造了您整個研究計畫,並告訴您該專案是否可行。
步驟 2:建立抽樣框
這是您的總名單。它必須包括您剛剛定義的群體中的每一個成員。如果名單中漏掉了某些人,他們被選中的機率就是零,這會立即破壞隨機性。
皮尤研究中心已確定,有缺陷的抽樣框是導致重大調查產生偏差的主要原因。
步驟 3:確定樣本量
您需要選擇多少個單位?答案需要在信心和精準度之間取得平衡。哈佛大學陳曾熙公共衛生學院的一項分析指出,只有在選擇真正隨機的情況下,較大的樣本才能提高可靠性。
使用樣本量計算器來平衡您的置信水平和誤差範圍。要計算您的樣本量,您需要決定三件事:
您的置信水平(通常為 95%)
可接受的誤差範圍
您群體內的預期變異性
步驟 4:應用隨機選擇
這是您利用機率從抽樣框中挑選樣本的地方。常用工具包括:
數位隨機數生成器
列印的隨機數表
用於計算機生成選擇的專業軟體。關鍵是從過程中消除任何人工選擇。
步驟 5:驗證代表性
一旦您獲得了樣本,不要假定它是好的。檢查它。將樣本的基本特徵(如平均年齡或性別比例)與您所了解的完整群體特徵進行比較。
如果樣本看起來有明顯差異,說明出了問題。您可能需要返回到之前的步驟,通常是修正抽樣框或選擇方法。
<ProTip title="🧪 專家提示:" description="在進行全面數據收集之前,使用小型模擬測試您的抽樣方法" />
為什麼人們不信任「足夠隨機」的樣本
這種懷疑是有道理的。在現實世界中,許多研究人員不得不妥協於「足夠隨機」的方法,而網上論壇上也充斥著質疑其方法是否真正有效的人。
一個常見的捷徑是便利樣本,例如對您的同學進行民意調查、在特定的 Facebook 社團中發布調查,或使用前 100 名網站訪問者。
這些群體感覺易於接觸且多樣化,但選擇並非基於機率。它是基於誰最容易接觸到,這是一種經典的偏差形式。
一個重大的誤解是,收集更多的人就能解決問題。事實並非如此。一個由一千人組成的有偏差樣本,從根本上說不如一個由一百人組成的真正隨機樣本值得信賴。
如果您沒有一個完整的名單可以抽取,您就不能聲稱這是一個機率樣本。這種持續存在的差距正是為什麼許多研究在研究人員最終試圖選擇期刊發表研究時失敗的原因,因為同行評審會尋找抽樣的嚴謹性。
隨機抽樣 vs 非機率抽樣
正確理解這一區別是至關重要的。您的選擇決定了您是否可以將您的發現推廣到更大的群體。
它們在實踐中有何不同
維度 | 隨機抽樣 | 非機率抽樣 |
選擇如何運作 | 純粹憑機率(例如,抽籤) | 基於研究人員的判斷或便利性 |
偏差風險 | 如果操作正確,理論上較低 | 固有的高且通常無法控制 |
統計推論 | 允許對整個群體進行有效估算 | 不支持統計推廣 |
隨機抽樣是讓您進行預測的數學基礎(推論統計)。非機率抽樣無法保證您的樣本能反映更廣泛的群體。
何時使用每種方法
當您的結論需要精確且站得住腳時,請選擇隨機抽樣。 這對於以下方面至關重要:
臨床試驗和公共衛生研究
官方政府調查,如人口普查
發表結果的正式學術研究
在特定的實際限制下,選擇非機率方法:
您的專案時間或預算非常緊張
您只需要初步的、探索性的見解,例如早期階段的市場回饋
完整群體無法接觸到或無法列出名單(例如,研究一個隱秘的社群)
簡而言之,使用隨機抽樣來證明某事;使用非機率抽樣來了解某事。
<ProTip title="⚖️ 專家提示:" description="在研究報告中,不要將便利樣本標註為隨機抽樣" />
隨機抽樣的現實世界應用
這種方法不僅僅是一個教科書上的概念。它是一個在不同領域中使用的實用工具,旨在使決策更可靠並減少偏差。
在醫療保健領域,它是值得信賴的臨床試驗和追蹤疾病傳播研究的基石。例如,疾病預防控制中心(CDC)使用機率抽樣來估算美國有多少人患有特定疾病,以此指導公共衛生政策。
對於市場研究,企業依賴它。當一家企業想知道客戶對新產品或品牌聲譽的看法時,他們會使用隨機抽樣來獲得目標受眾的無偏快照。
數據科學和機器學習領域也極大地依賴它。分析師使用隨機抽樣來為演算法構建平衡的訓練數據集。
核心技術如自助抽樣法(自助法,通過對數據進行重新抽樣來估算不確定性)和蒙地卡羅模擬(對概率進行建模)都建立在重複的隨機抽取之上。
您還會發現它應用於:
社會科學,用於關於投票或就業等主題的全國性調查。
政府,用於設計準確的人口普查調查和審計。
業務運營,用於驗證製造線上產品的質量。
在這些領域中,共同的主線是使用隨機抽樣將原始數據轉化為可操作的分析,從猜測走向知情決策。
常見錯誤與最佳實踐
即使是經驗豐富的團隊,也可能犯下從一開始就削弱數據質量的錯誤。
常見錯誤
一些常見問題一致地削弱了樣本的完整性:
使用過時或不完整的總體名單。
誤將易於收集的「便利」數據當作真正的隨機樣本。
跳過必要的數學計算來確定樣本量需要多大。
未能確保總體中的關鍵子群體得到充分代表。
提高準確性的實用步驟
改進您的流程依賴於一些嚴謹的習慣:
在開始之前,精確定義您的研究群體。
從經過驗證、全面的數據中獲取您的抽樣框。
應用合適的隨機化工具或服務,不要只是手動挑選名字。
通過對照已知的群體指標檢查其人口統計特徵,來驗證您最終的樣本。
一個精心設計的抽樣方法是將有用、可靠的數據與一堆具有誤導性的數字區分開來的關鍵。
從一開始就正確進行隨機抽樣
當您的樣本不能完全代表您試圖研究的對象時,您會感覺得到,這會讓您的結果更難被信任。它會減緩您的進度,並引出您未曾預料到的問題。即使在如何選擇參與者方面犯下微小的失誤,也會影響到一切。這種風險是真實存在的。
<CTA title="設計更智慧的研究工作流" description="在引導式 AI 支持下,更快地規劃抽樣方法並構建研究結構" buttonLabel="免費試用 Jenni" link="https://app.jenni.ai/register" />
使用 Jenni 幫助您更清晰地規劃抽樣,讓您的研究保持在正軌上。它支持您如何構建方法並解釋您的方法,使您的工作更容易辯護和理解。這是保持結果穩固的簡單方法。