
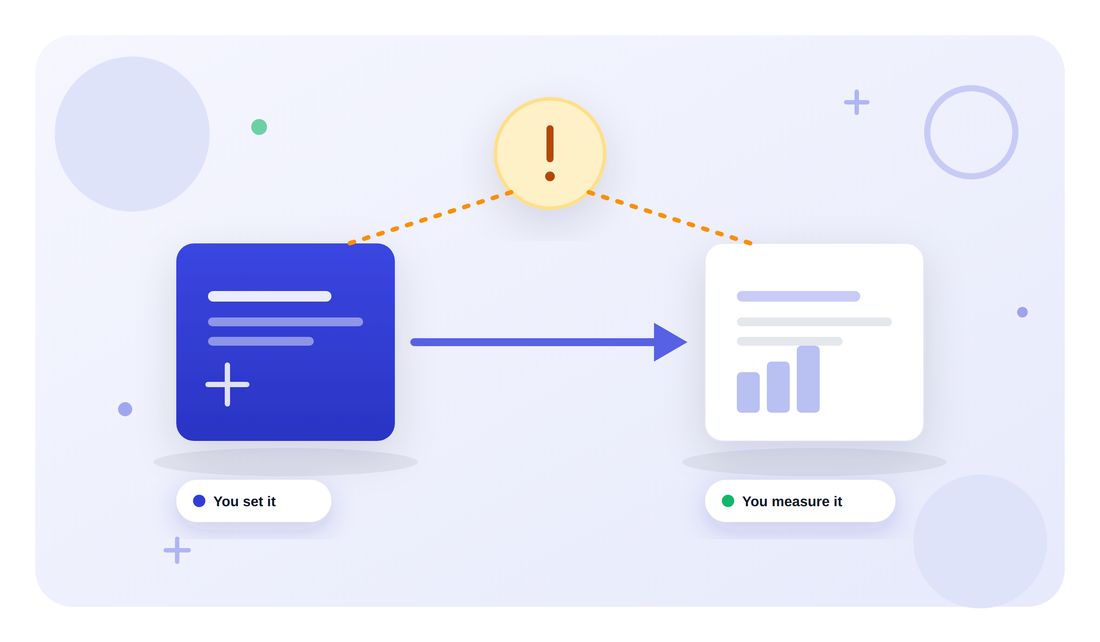
網路上幾乎所有關於自變量(獨立變量)和因變量(依變量)的解釋都是寫給學校學生的。在這方面排名靠前的網頁包括一個針對兒童的政府網站、一個六年級的數學複習頁面,以及一個百科全書條目。它們說的都是同一件事:自變量是你改變的那個,因變量是你測量的那個。這沒錯,但在你坐下來撰寫方法論章節的那一刻起,這點解釋就遠遠不夠了。
接下來的內容是為需要捍衛自己選擇的研究者準備的版本:如何可靠地識別這兩者、屬於同一部分的另外四種變量類型、為什麼混雜因素會讓你失分,以及如何將整件事寫成考官會接受的段落。
<CTA title="撰寫經得起考驗的方法論部分" description="Jenni 協助您從一開始就規劃和起草每個部分,並附上文獻來源" buttonLabel="免費試用 Jenni" link="https://app.jenni.ai/register" />
什麼是自變量和因變量?
自變量(獨立變量)是你操縱、分配或篩選的變量。它是假設的原因、輸入值,也就是最先出現的事物。因變量(依變量)是你事後測量以觀察其是否做出反應的變量。它是假設的結果,其數值被認為依賴於自變量,這也是其名稱的由來。
國立大學(National University)的統計資源給出了清晰的定義:自變量是由研究人員操縱,以確定它是否會導致因變量發生變化,而因變量則是被測量以觀察其數值是否取決於該變化。
由此衍生出兩個值得內化的慣例。在圖表中,自變量位於橫軸(X軸),因變量位於縱軸(Y軸)。在迴歸方程中,因變量是左側的 y,而自變量是右側的 x 項,這就是為什麼統計學家有時稱它們為左側變量和右側變量。
如何區分兩者
當遇到不熟悉的問題時,請依循以下步驟思考,而不是憑空猜測。這大約需要一分鐘,但能找出直覺失效的情況。
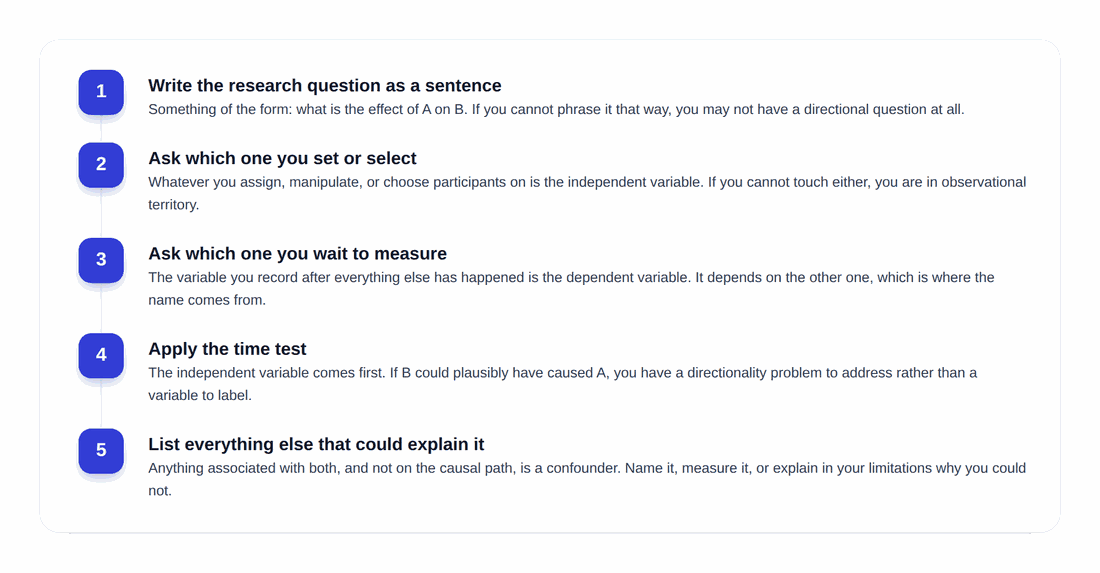
將研究問題寫成一個句子。 儘量採用A對B有何影響的形式。如果你無法用這種方式表述,你可能沒有一個具方向性的問題,這本身就是一個需要注意的重要關鍵。
問問自己設定或選擇了哪一個。 無論你分配、操縱還是根據什麼來選擇參與者,這就是自變量。在實驗中,由你來設定它。在觀察性研究中,你選擇它或僅僅記錄它發生的情況。
問問自己等待測量的是哪一個。 在所有其他事情發生後你記錄下來的變量就是因變量。
應用時間檢驗。 自變量先出現。如果 B 有可能導致 A,那麼你遇到的不是標籤錯誤問題,而是方向性問題,這應該寫入你的研究局限中。
列出所有其他可能解釋結果的因素。 任何與這兩個變量都有關聯,但不在它們之間因果路徑上的因素都是混雜因素。命名它、測量它,或者解釋你為什麼無法測量它。
應用於實際問題時,它看起來像這樣。
研究問題 | 自變量 | 因變量 |
睡眠時間會影響考試表現嗎? | 前一天晚上的睡眠時數 | 考試分數 |
新的教學方法能提高記憶保留率嗎? | 教學方法(新方法或標準方法) | 六週時的記憶保留測試分數 |
咖啡因劑量會改變反應時間嗎? | 咖啡因劑量(毫克) | 反應時間(毫秒) |
家庭收入能預測預期壽命嗎? | 家庭收入(觀察值而非設定值) | 死亡年齡 |
回饋頻率會影響工作滿意度嗎? | 每月主管回饋面談次數 | 工作滿意度量表得分 |
注意第四行。沒有人會分配一個人的收入。在這種情況下,標準術語開始顯得有些牽強,這點將在下文進一步探討。
<ProTip title="🎚️ 設定或測量:" description="如果你能想像將參與者分配到該變量的某個水平,它就是你的自變量。如果你唯一能做的就是記錄發生的情況,它就是你的因變量" />
方法論部分中另外四個重要的變量
一個僅命名了兩個變量的方法論章節幾乎總是不完整的。學術報告標準期望看到更多,審查員也會尋找它們。

控制變量 (Control variables)
控制變量是你刻意保持不變的變量,使其無法變化並干擾比較。在同一天的同一時間、同一房間內對所有人進行測試,可以控制環境和晝夜節律的影響。控制變量不作為效應進行分析,它們已被排除在干擾因素之外。
混雜變量 (Confounding variables)
混雜因素與自變量和因變量都有關聯,且不在它們之間的因果路徑上。這是使結論失效的關鍵因素,下文將有專門的一節對此進行介紹。
調節變量 (Moderating variables)
調節變量會改變關係的強度或方向。在 Baron 和 Kenny 的權威定義中,調節變量是影響自變量或預測變量與因變量或效標變量之間關係的方向和/或強度的變量。如果你的干預措施對有經驗的員工有效,而對新員工無效,那麼經驗就是一個調節變量。調節變量回答了「對誰有效」和「何時有效」的問題。
中介變量 (Mediating variables)
中介變量處於因果路徑之上,並解釋了其作用機制。同樣來自 Baron 和 Kenny 的定義:當一個變量在某種程度上解釋了預測變量與效標變量之間的關係時,它就起到了中介變量的作用。如果睡眠因為影響了專注力進而影響考試成績,那麼專注力就是中介變量。中介變量回答了「如何起作用」的問題。
最容易讓人混淆的是調節變量與中介變量。調節變量是效應發生變化的「條件」。中介變量是效應發生的「鏈條中的一個步驟」。將其中一個誤標為另一個會改變你的分析和你的學術主張。
為什麼混雜因素是至關重要的
混雜是相關性研究結果被推翻的原因,它有著精確的定義,而非模糊的概念。哥倫比亞大學的流行病學教學資源引用了 Last 的《流行病學詞典》:混雜是由於與暴露和結果都有關聯,但不是它們之間因果路徑的中介步驟的外部因素,導致對暴露於結果的估計效應產生的偏倚。
俄勒岡州立大學的開放流行病學教科書中指出,該定義產生了三項檢驗。要成為混雜因素,變量必須與暴露在統計學上相關、必須導致結果,且絕不能處於兩者之間的因果路徑上。第三個條件是人們最容易忘記的,教科書對其後果的描述非常直接:因果路徑上的變量是中介因素,而不是混雜因素。對中介因素進行控制並不會淨化你的估計值,反而會破壞你試圖測量的效應。
實際案例:喝更多咖啡的人患肺癌的機率更高。咖啡不會導致肺癌。吸菸與喝咖啡有關,且會導致肺癌,而它並不是咖啡到癌症任何因果路徑中的一個步驟。吸菸是一個混雜因素,任何忽略它的分析都會產生一個看似真實、具有統計學顯著性,但完全是虛假的結果。
<ProTip title="🕵️ 尋找混雜因素:" description="在收集任何數據之前,列出五個可能導致你的結果且與你的預測變量相關聯的變量。測量那些你能測量的。那些你無法測量的,就是你預先寫好的研究局限部分" />
同一個變量可以是任何一種角色
變量本身並沒有任何本質特徵使其成為自變量或因變量。角色來自於研究問題,而不是變量本身。
當你詢問睡眠是否影響考試表現時,睡眠時間是自變量。當你詢問焦慮是否影響睡眠時,它就變成了因變量。在管理實踐研究中,工作滿意度是一個因變量;而在員工流失率研究中,它則是一個自變量。這個標籤描述的是其在論證中的位置。
這也是為什麼方向性問題是一個真正的威脅,而不僅僅是技術細節。正如 BCcampus 研究方法教科書所說,壓力和不良規劃是相關的,而處於壓力中可能和反過來一樣,容易損害未雨綢繆的能力,而像責任心這樣的第三個變量可能會同時推動這兩者。在沒有實驗或強大時間設計的情況下,你無法僅憑數據解決這個問題,在討論部分假裝可以,是失去讀者信任最快的方法。
<ProTip title="🔀 方向檢驗:" description="反向寫出你的因果主張,看看它聽起來是否仍然合理。如果是,你的設計必須證明該方向的合理性,而不是直接假設它" />
何時「自變量」是錯誤的術語
在真正的實驗中,這種術語使用起來很自然,因為你確實獨立於其他所有事物來設定自變量。但在觀察性工作中並非如此,一些方法學家認為在這種情況下使用該詞會產生誤導。
BCcampus 教科書對相關性設計的觀點非常直接:在既不認為任何一個變量會導致另一個變量,也沒有操縱任何事物的情況下,自變量和因變量這些術語並不適用於這類研究。國立大學也提出了同樣的觀點。維基百科指出,一些作者更傾向於使用「解釋變量」(explanatory variable),正是因為被視為獨立的量可能既不是統計上獨立的,也無法被獨立操縱。
請注意,這是一個現行的慣例,而不是一個定論,許多優秀的分析師在處理觀察數據時仍然會使用「自變量」而無需道歉。實用的指南是遵循你所在的領域:流行病學使用「暴露」(exposure)和「結果」(outcome),臨床試驗使用「終點」(endpoint),迴歸文獻使用「預測變量」(predictor)和「響應變量」(response),而在相關性研究中,心理學則使用「預測變量」和「效標變量」(criterion)。匹配這些慣例表明你了解自己是在哪種學術傳統中寫作。
如何將變量寫入方法論部分
這是每個排名靠前的網頁都會跳過的步驟,但它卻是唯一實際出現在你論文中的步驟。
目前最優秀的規範來自 STROBE(觀察性研究報告規範)。其第 7 項要求你清晰定義所有結果、暴露、預測、潛在的混雜因素和效應修飾因子,並在適用時給出診斷標準。詳細說明中還增加了另外三個期望:每個變量的數據來源和評估方法、評估方法在不同群體和不同時間是否具有可比性,以及測量每個變量的組織層級。
將其視為清單,段落自然就能寫成。對於每個變量:它是什麼、如何測量的、使用什麼工具、在什麼層級測量,以及為什麼它出現在模型中。以下是實際應用的樣子:
自變量為睡眠時間,以小時為單位,在測試當天早上使用單一問題進行自我報告。因變量為考試表現,具體操作為標準化模組結束評估的百分制得分。先前的平均績點(GPA)從機構記錄中獲取,並作為協變量納入,因為它與睡眠習慣和學術表現均相關,且不在它們之間的因果路徑上。
這三個句子中的每一句都回答了評閱人原本需要詢問的問題。請注意,第三句為協變量提供了合理解釋,而不僅僅是列出它,這就是「報告選擇的方法論部分」與「捍衛選擇的方法論部分」之間的區別。
<ProTip title="📋 準確報告:" description="在整篇文檔中始終使用相同的詞彙來命名你的變量。在方法論中被稱為『睡眠時間』而在結果中被稱為『睡眠質量』的變量會被解讀為兩個不同的概念,仔細的審查員會詢問你到底測量了哪一個" />
如何使用 Jenni 起草你的變量部分
一旦你清楚了變量是什麼,起草就是結構性的工作了。
步驟 1。準確描述你的需求。 在提示詞中說出研究名稱、研究對象和變量。模糊的提示詞只會產生一個通用的段落,無法通過導師的審核。
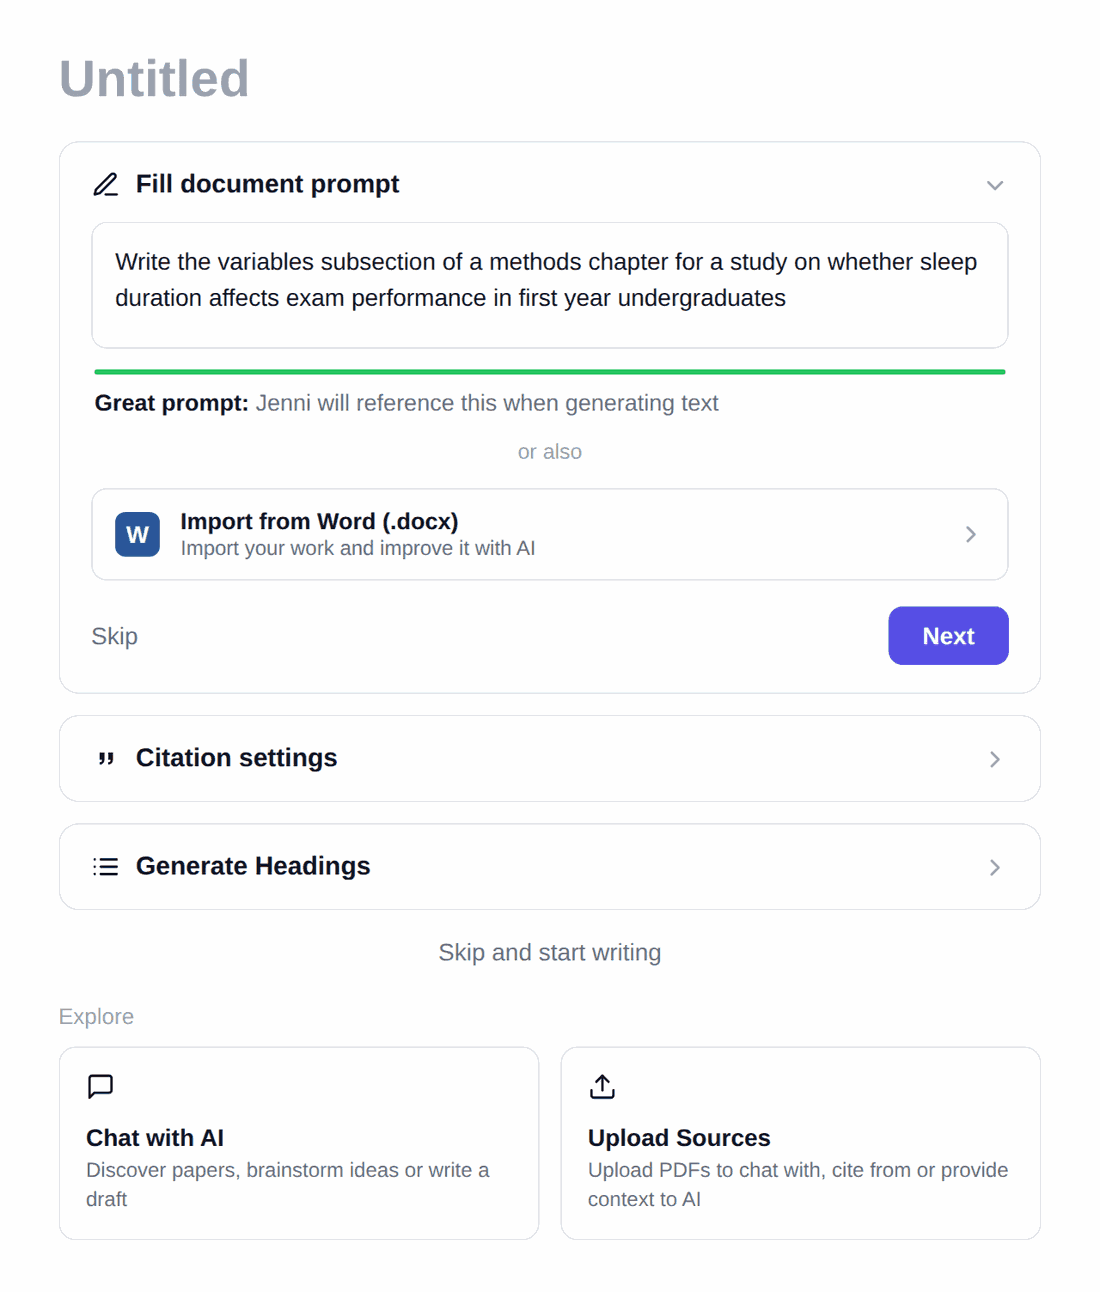
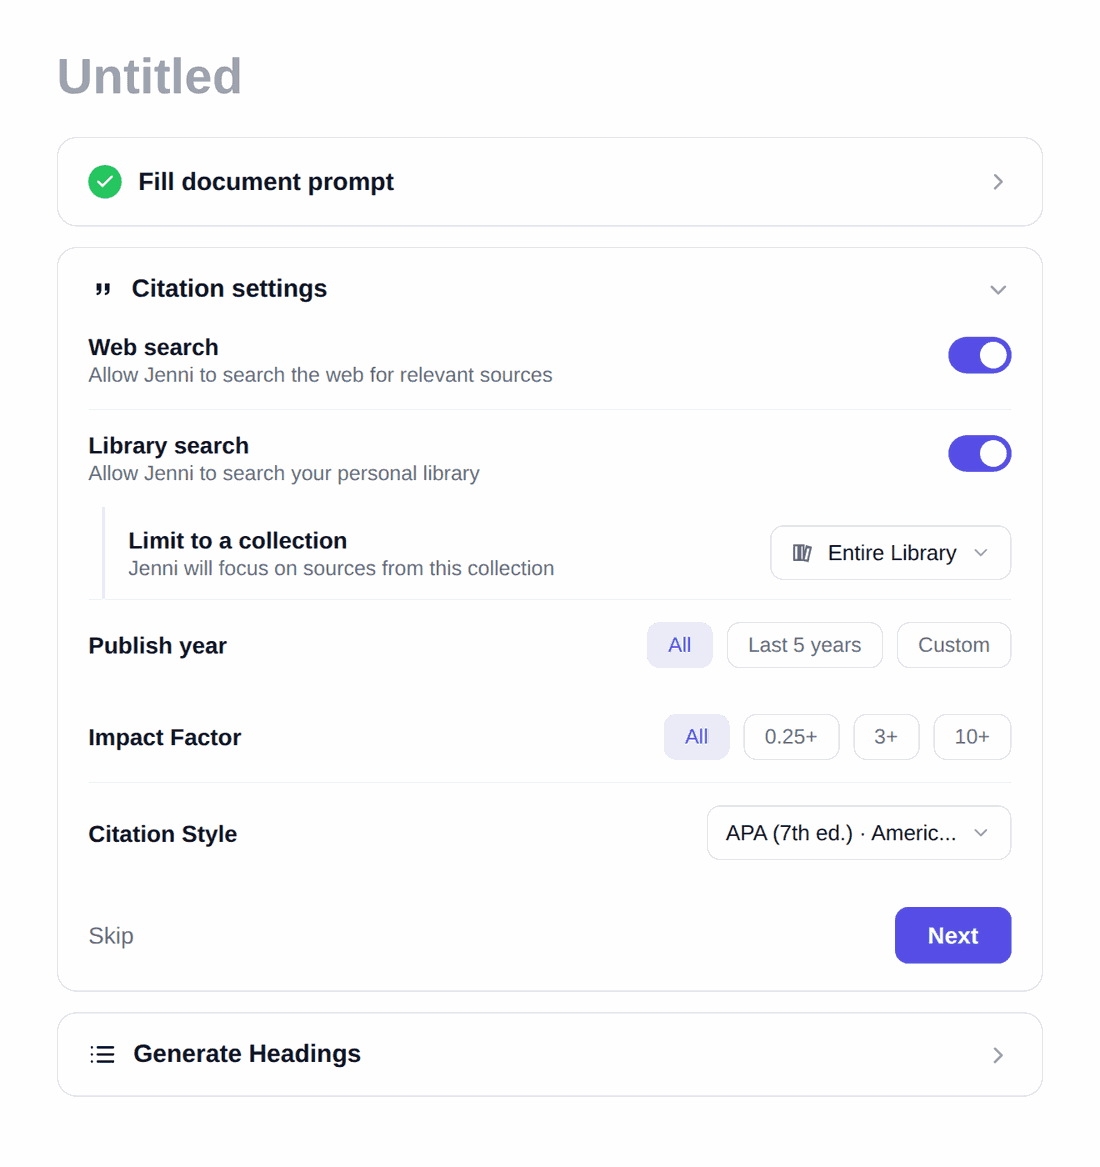
步驟 2。設定你的引文偏好。 選擇你學系要求的格式。方法論部分包含了令人驚訝的引文數量,因為每個工具和每個既定的測量方法都需要一個引文。
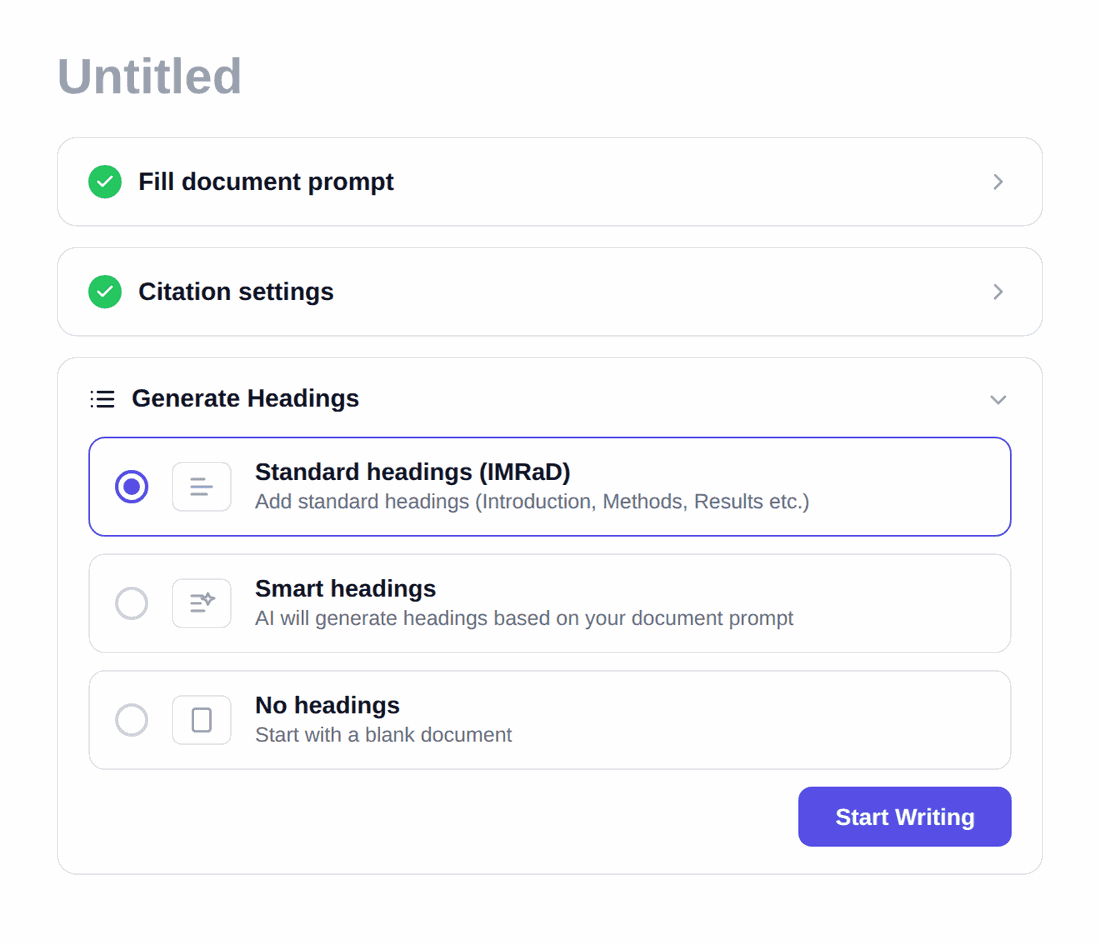
步驟 3。生成標題。 在撰寫正文之前先構建方法論章節的大綱,以便變量子章節處於相對於設計、參與者和分析的正確位置。
步驟 4。逐個變量進行起草。 針對每個變量依次完成 STROBE 清單:定義、測量、工具、層級和合理解釋。通過 DOI 將任何已發表工具的引文拉入你的文獻庫,確保引用從一開始就是正確的。
步驟 5。在導師審閱前進行自我檢查。 在該部分運行 Claim Confidence(聲明置信度)功能,以找出任何你暗示了因果關係但研究設計無法支持的地方,在變量部分,這通常是指誤用了「影響」而本應使用「與……相關」。
標籤正確,論證自然水到渠成
正確命名你的自變量和因變量只是其中最微不足道的一部分。其價值在於這個過程強迫你去面對的問題:你的問題是否真的具有方向性、你是否能為這個方向辯護、還有什麼其他因素可以解釋結果,以及你使用的詞彙是否與你進行的設計相匹配。
<CTA title="充滿信心地起草你的方法論章節" description="結構化每個部分、引用每個工具,並檢查你的學術主張是否與你的設計相符" buttonLabel="免費試用 Jenni" link="https://app.jenni.ai/register" />
本週對你自己的問題進行這五步檢查,然後寫出上述段落的三句版。如果你無法填寫任何變量的測量方法或工具,這就是下一步需要解決的問題,遠在你撰寫方法論部分的下一個字之前。同樣的學術規範貫穿於學術論文的每個部分,而這一切都從這裡開始。