によって
ジャスティン・ウォン
—
無作為抽出法(ランダムサンプリング)の解説:手法、手順、そして実際の活用事例

大規模な母集団を調査するために、その一部をランダムに抽出することがあります。この方法はランダムサンプリング(無作為抽出)と呼ばれ、全員に選ばれるチャンスが等しく与えられます。これは、医学や世論調査などの分野において、信頼性の高い研究を行うための基盤となっています。
このガイドでは、ランダムサンプリングの仕組み、さまざまな手法、そして実際のプロジェクトへの適用方法を解説します。準備はよろしいですか?
<CTA title="より優れた研究サンプルを構築する" description="サンプリング計画をより迅速に構築し、研究プロセスにおけるバイアスを排除します" buttonLabel="Jenni を無料で試す" link="https://app.jenni.ai/register" />
実務におけるランダムサンプリングの真の意味
実務において、ランダムサンプリングとは純粋に偶然によって対象を選ぶことを意味しますが、これは言うほど簡単なことではありません。
世界保健機関(WHO)は、この偏りのないアプローチが正確な人口推計を行うための鍵であると指摘しています。
優れたサンプルは、全体の年齢、所得、その他の特徴の構成比を反映している必要があり、これは回帰分析などのテストにおいて極めて重要です。理論は単純ですが、実行段階で失敗することが多々あります。
研究者は、不完全な対象者リストなどの問題に直面することが多く、結果として、真にランダムではない「十分にランダムに近い」方法で妥協せざるを得ない場合があります。この違いが、学術界における異なる研究パラダイムの境界線となることがよくあります。
本物のランダムサンプルを抽出するには、次の3つの要素が必要です。
母集団全員を網羅した完全なリスト。
各個人が選ばれる確率が明確であること。
利便性ではなく、偶発性に基づいた選定プロセスであること。
これらのルールから少しでも外れると、バイアスが生じて結果が歪んでしまいます。
<ProTip title="💡 プロのアドバイス:" description="隠れたバイアスを避けるため、参加者を選定する前に必ずサンプリングフレーム(抽出台帳)を検証してください" />
主なランダムサンプリング手法の解説
手法によって、構造化された方法でランダム性が適用されます。最適な選択は、研究デザイン(質的研究と量的研究のどちらを行うか)や、対象とする集団の規模によって異なります。
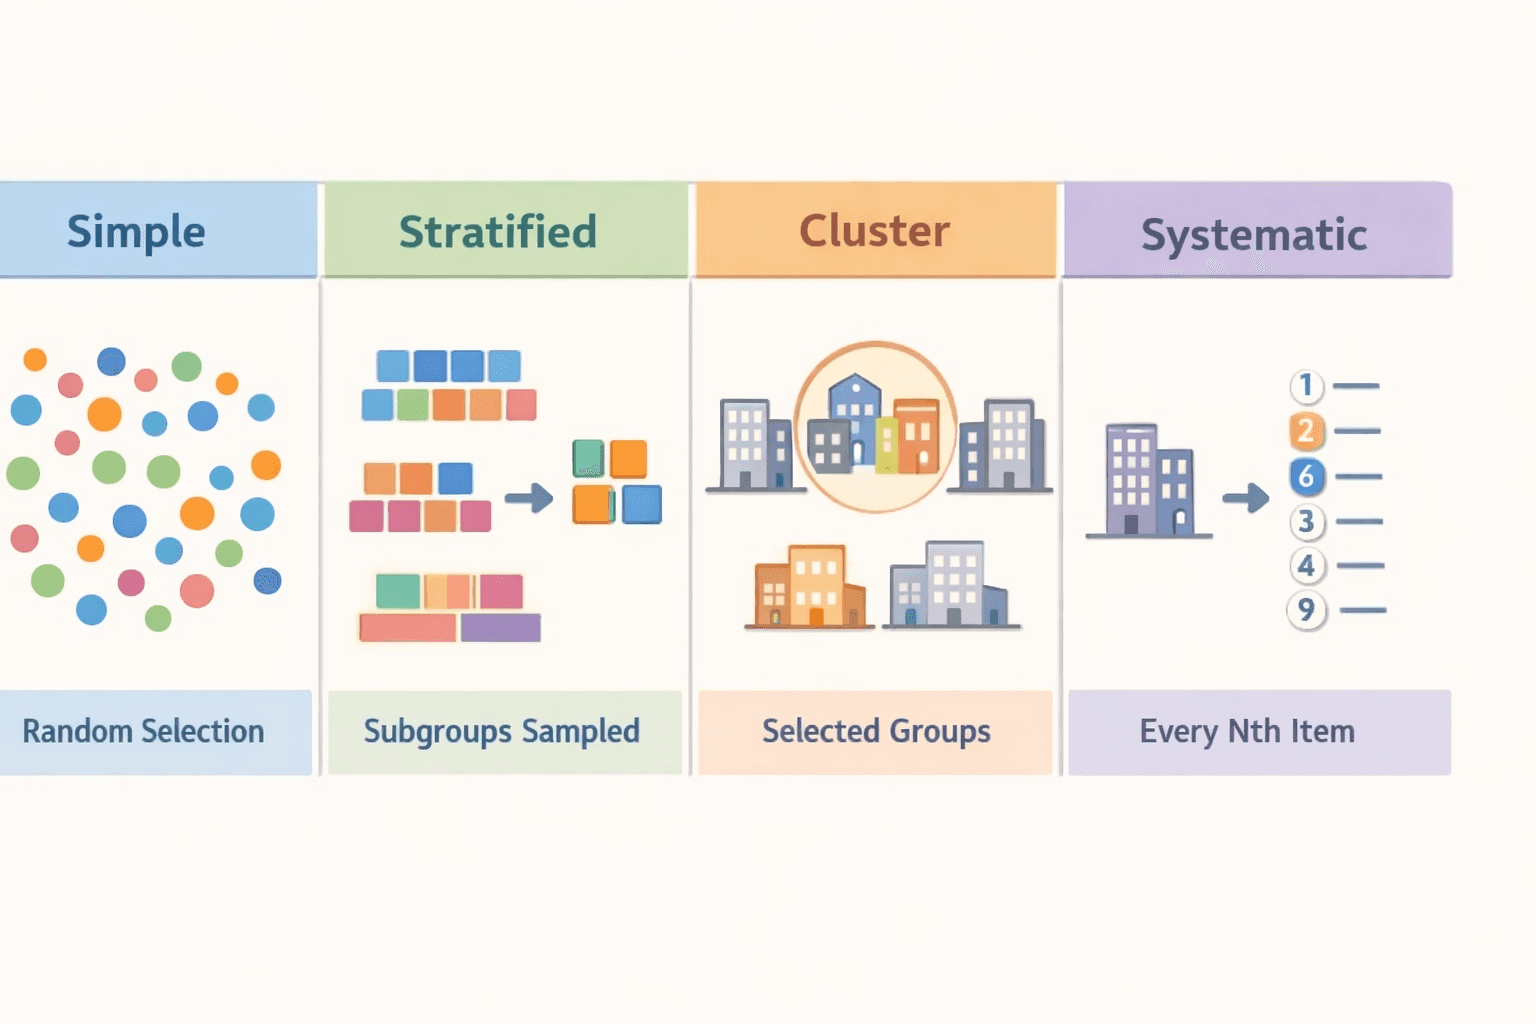
単純無作為抽出法(最も純粋な形)
ここでは、全員が選ばれる確率が完全に同一です。研究者は通常、乱数生成器や抽選方式を使用します。
500人の生徒がいるクラスを例に考えてみましょう。全員に番号を割り振り、乱数生成器を使って50人を選びます。これが教科書通りの代表例です。
統計的精度は高いですが、母集団全体の完璧で完全なリストが存在することが前提となります。リストに不備があれば、結果も不完全なものになります。
層化無作為抽出法(バランスの取れた代表性の確保)
この手法では、ランダムサンプリングを行う前に、母集団を年齢層や所得水準などの重複しないグループ(層)に分割します。これにより、重要なカテゴリーが適切に反映されるようになります。
たとえば健康調査では、年齢層(20代、30代など)ごとに層化し、各グループが母集団の割合に応じて確実に含まれるようにします。
主なメリットは、サンプル内のばらつきを抑え、各サブグループのより正確な状況を把握できる点です。市場調査などの分野で広く使われています。
多段・クラスター抽出法(大規模グループに効率的)
個人を選ぶ代わりに、既存のグループ全体(「クラスター」)をランダムに選択します。たとえば、5つの学校をランダムに選び、その学校のすべての生徒を調査するような方法です。
これは、地理的に分散している母集団に対する最も一般的な確率サンプリング手法の一つです。
このアプローチは、移動、時間、コストを削減できるため、広範囲に分散した大規模な母集団を調査する際に大きな利点となります。一方で、層化抽出法などの手法に比べてサンプリングエラー(抽出誤差)が大きくなりやすいというデメリットもあります。
系統的抽出法(構造化された規則性)
ランダムな開始点を決めた後、データベースのキューにおける10番目ごとの顧客のように、リストから一定の間隔(n番目)で対象者を抽出します。
実行は簡単ですが、隠れたリスクがあります。もしリストに周期的なパターンがある場合(たとえば、常に10番目のエントリーがマネージャーである場合など)、サンプルに偏りが生じてしまいます。
各手法の比較
手法 | 最適なユースケース | 主な強み | 主な限界 |
単純無作為 | 完全なリストが存在する比較的小規模な母集団 | 高い統計的精度 | 完全かつ正確なリストが必要 |
層化無作為 | 重要かつ多様なサブグループを持つ母集団 | 主要な特徴の代表性を確保 | 計画と実行がより複雑 |
クラスター | 地理的に広範囲に分散した大規模な母集団 | 非常に実用的でコスト効率が高い | 一般的にサンプリングエラーが大きくなる |
系統的 | 隠れたパターンのない整理されたデータセット | シンプルで迅速に導入可能 | リストの周期的なバイアスの影響を受けやすい |
これらの手法はいずれも確率サンプリングの基本思想を支えるものですが、それぞれに実用上のトレードオフがあり、最終的なデータに影響を与えます。
<ProTip title="📊 プロのアドバイス:" description="母集団のグループ間で規模や行動に大きな差がある場合は、層化サンプリングを使用してください" />
ランダムサンプリングのステップ・バイ・ステップ・プロセス
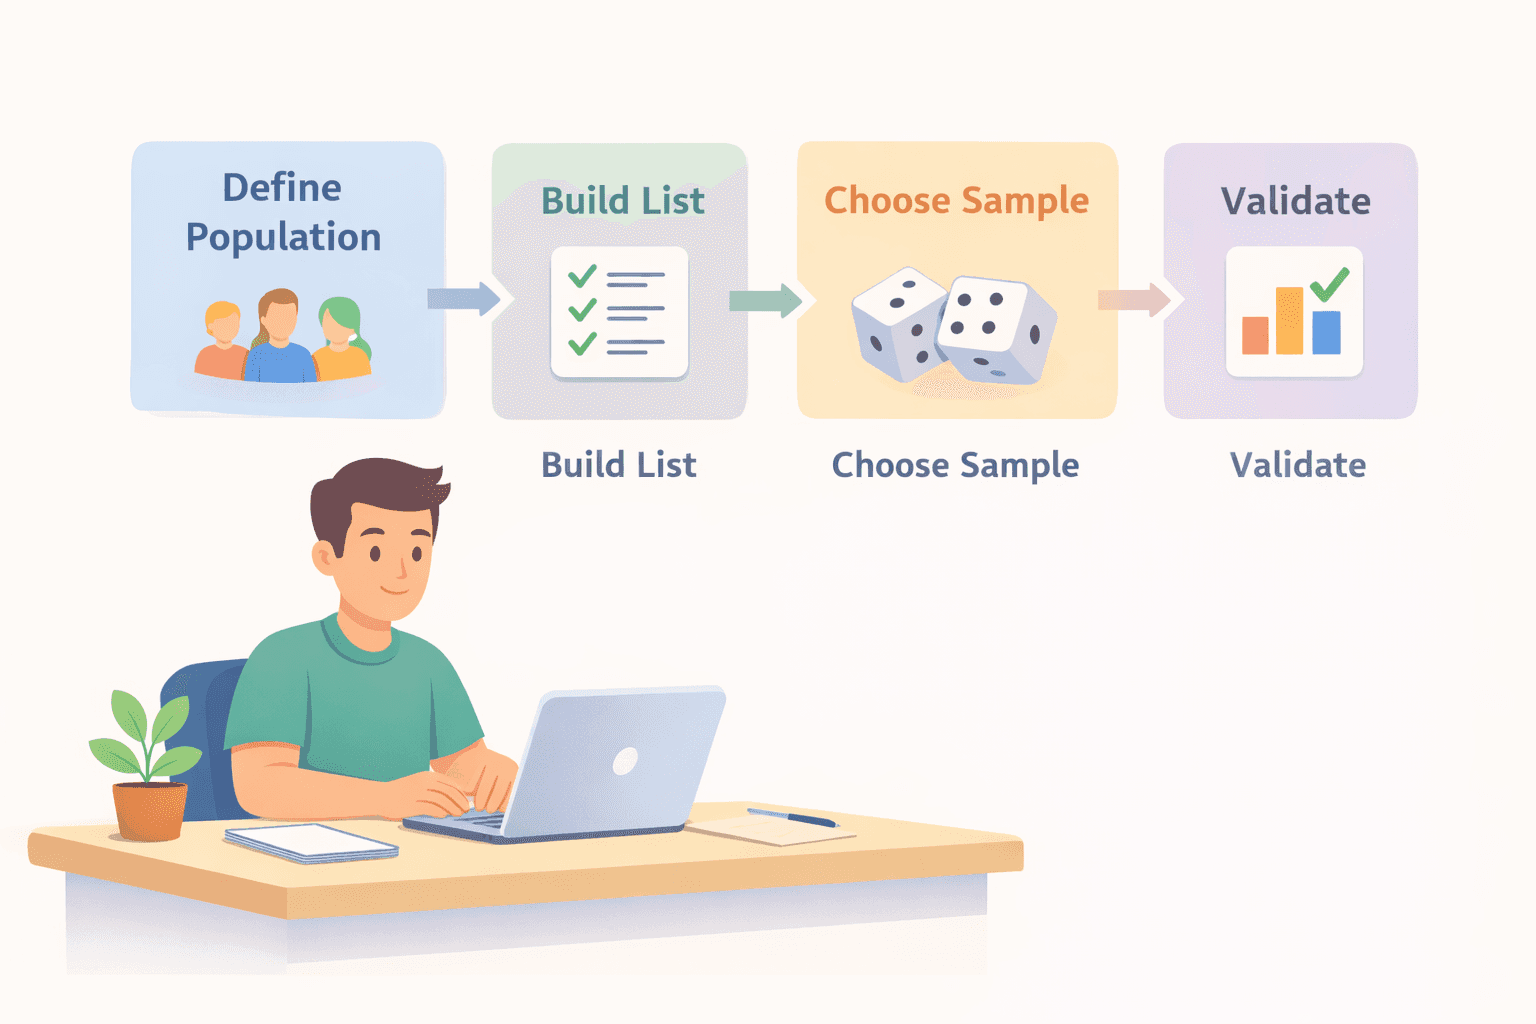
ランダムサンプリングを正しく行うには、明確な手順に従う必要があります。途中の段階をスキップすると、データが簡単に偏ったり、使い物にならなくなったりします。
ステップ 1: 母集団と調査範囲を定義する
まずは、誰を、あるいは何を研究しているのかを正確に決定します。曖昧に「若者」とするのではなく、「2024年度にスラバヤの大学に在籍しているすべての学生」のように具体的に定義します。この最初の決定が研究計画全体を左右し、プロジェクトの実現可能性を判断する基準になります。
ステップ 2: サンプリングフレームを作成する
これはマスターリストです。先ほど定義した母集団の全員が含まれている必要があります。このリストから漏れている人がいると、その人が選ばれる確率はゼロになり、ランダム性が即座に損なわれます。
ピュー・リサーチ・センターは、不完全なサンプリングフレームが主要な世論調査におけるバイアスの主な原因であると指摘しています。
ステップ 3: サンプルサイズを決定する
何人(いくつのユニット)を抽出する必要があるでしょうか?答えは、信頼度と精度のバランスにあります。ハーバードT.H.チャン公衆衛生大学院の分析によると、サンプルサイズを大きくしても、選定が純粋にランダムでなければ信頼性は向上しません。
サンプルサイズ計算ツールを使用して、信頼水準と許容誤差のバランスをとってください。サイズを計算するには、次の3つの項目を決める必要があります。
信頼水準(通常は95%)
許容誤差(許容できる誤差の範囲)
母集団内で予想されるばらつき
ステップ 4: ランダム抽出を適用する
ここで、偶然の要素を用いてリストからサンプルを抽出します。一般的なツールには以下のようなものがあります。
デジタル乱数生成器
印刷された乱数表
コンピュータによる選択のための専用ソフトウェア。重要なのは、プロセスから人間の恣意性を完全に排除することです。
ステップ 5: 代表性を検証する
サンプルが抽出できたら、それで終わりではありません。検証が必要です。平均年齢や男女比など、サンプルの基本的な特徴を、把握している母集団全体の特徴と比較します。
もしサンプルに明らかな違いが見られる場合は、どこかで問題が発生しています。前のステップに戻り、サンプリングフレームや抽出方法を修正する必要があるでしょう。
<ProTip title="🧪 プロのアドバイス:" description="本格的なデータ収集を開始する前に、小さなシミュレーションを行ってサンプリング方法をテストしてください" />
なぜ「十分にランダムに近い」サンプルは疑われるのか
その懐疑的な見方は極めて妥当です。現実の世界では、多くの研究者が「十分にランダムに近い」方法で妥協せざるを得ず、オンラインのフォーラムでは、そのアプローチが本当に有効なのか疑問を呈する声が溢れています。
よくある近道は、クラスメートにアンケートを取ったり、特定のFacebookグループに調査を投稿したり、Webサイトの最初の100人の訪問者を利用したりする「便宜的サンプリング」です。
これらのグループはアプローチしやすく多様に見えますが、選定は偶然に基づいているわけではありません。連絡が最も取りやすい相手に基づいているため、これは典型的なバイアスの一種です。
大きな誤解として、人数を多く集めれば解決するというものがありますが、それは間違いです。偏りのある1,000人のサンプルは、純粋にランダムに抽出された100人のサンプルよりも、根本的に信頼性が低くなります。
抽出の元となる完全なリストがない限り、それを確率サンプリングと呼ぶことはできません。この根深い課題があるため、研究者が最終的に研究論文を投稿するジャーナルを選ぶ段階になって、査読者からサンプリングの厳密さを厳しく問われ、不採択になってしまうケースが後を絶ちません。
ランダムサンプリング vs 非確率サンプリング
この違いを正しく理解することは極めて重要です。どちらを選択するかによって、得られた知見をより大きなグループに一般化できるかどうかが決まります。
実務における違い
側面 | ランダムサンプリング(確率サンプリング) | 非確率サンプリング |
選定の仕組み | 完全に偶然によるもの(例:抽選) | 研究者の判断や利便性に基づく |
バイアスのリスク | 正しく行われれば論理的に低い | 本質的に高く、制御が困難なことが多い |
統計的推測 | 母集団全体に対する有効な推計が可能 | 統計的な一般化はできない |
ランダムサンプリングは、予測を可能にする数学(推測統計学)の基礎となります。非確率サンプリングでは、サンプルがより広い母集団を反映していることを保証できません。
それぞれのアプローチをいつ使用すべきか
結論に正確性と信頼性が求められる場合は、ランダムサンプリングを選択してください。 これは以下において極めて重要です。
治験や公衆衛生に関する研究
国勢調査などの政府による公式統計調査
結果が公表される正式な学術研究
時間や予算に明確な制約がある場合は、非確率サンプリングを選択します。
プロジェクトの時間や予算が非常に限られている場合
初期段階の市場フィードバックのように、予備的・探索的なインサイトのみが必要な場合
母集団全体へのアクセスやリスト化が不可能な場合(例:表に出にくいクローズドなコミュニティの研究)
要約すると、何かを実証するためにはランダムサンプリングを、何かを探索的に知るためには非確率サンプリングを使用します。
<ProTip title="⚖️ Pro Tip:" description="研究レポートにおいて、便宜的サンプルをランダムサンプリングと表記しないでください" />
ランダムサンプリングの現実世界での応用例
この手法は教科書の中だけの話ではありません。意思決定の信頼性を高め、バイアスを軽減するために、さまざまな分野で実用的なツールとして使われています。
医療・ヘルスケア分野では、信頼性の高い治験や疾患の感染拡大を追跡する研究のバックボーンとなっています。たとえば、アメリカ疾病予防管理センター(CDC)は、確率サンプリングを用いて全米の特定の疾患の罹患者数を推計し、公衆衛生政策に役立てています。
市場調査において、企業はこの手法に大きく依存しています。新製品に対する顧客の本音やブランドの評判を把握したいとき、ランダムサンプリングを用いることで、ターゲット層の偏りのない全体像を把握できます。
データサイエンスや機械学習の分野でも、ランダムサンプリングは重宝されています。アナリストは、アルゴリズムのためのバランスの取れたトレーニングデータセットを構築するためにサンプリングを使用します。
データの不確実性を評価するブートストラップサンプリング(再サンプリング)や、確率をモデリングするモンテカルロシミュレーションなどの主要技術は、繰り返しのランダム抽出に基づいています。
他にも以下のような場面で活用されています。
社会科学:投票行動や雇用に関する全国的な調査など
行政:正確な国勢調査や監査の設計など
ビジネス運営:製造ラインから製品の品質を検証する検査など
これらすべての分野に共通しているのは、ランダムサンプリングを活用することで、生データを実用的な分析に変え、推測からデータに裏付けられた意思決定へとシフトさせている点です。
よくある間違いとベストプラクティス
経験豊富なチームであっても、最初からデータの品質を損なうようなミスを犯してしまうことがあります。
頻出するミス
以下のような一般的な問題が、サンプルの整合性を一貫して低下させます。
母集団全体の古くなったリストや不完全なリストを使用すること。
手軽に集めた「便宜的な」データを、真のランダムサンプルと誤解すること。
必要なサンプルサイズを決定するための計算を怠ること。
母集団の中の重要なサブグループが適切に反映されるように考慮しないこと。
精度を高めるための実用的ステップ
プロセスを改善するには、いくつかの規律ある習慣が必要です。
開始する前に、母集団を正確に定義すること。
検証済みの包括的なデータからサンプリングフレームを取得すること。
手作業で名前を選ぶのではなく、適切なランダム化ツールやサービスを適用すること。
最終的なサンプルのデモグラフィック(人口統計属性)を既知の母集団データと比較し、代表性を検証すること。
慎重に設計されたサンプリング方法こそが、信頼性の高い有用なデータと、誤解を招く数値の羅列とを分ける境界線となります。
最初から正しいランダムサンプリングを
調査対象を正しく反映していないサンプルを使っていると、結果への信頼性が揺らぎ、研究の進捗が滞ったり、予想外の疑問を突きつけられたりします。参加者選定におけるわずかなミスが、すべてに影響を与える現実的なリスクとなります。
<CTA title="よりスマートな研究ワークフローを設計する" description="AIのサポートにより、サンプリング方法の計画や研究の構成をより迅速に構築します" buttonLabel="Jenni を無料で試す" link="https://app.jenni.ai/register" />
Jenni を活用すれば、サンプリング計画をよりクリアに作成でき、研究を軌道に乗せることができます。手法の構築やアプローチの説明を論理的にサポートし、研究内容の裏付けと理解を容易にします。結果の堅実性を保つためのシンプルなアプローチです。