Durch
Justin Wong
—
Zufallsstichprobe erklärt: Methoden, Schritte und reale Anwendung

Justin Wong
Leiter des Wachstums
Abgeschlossen mit einem Bachelor in Global Business & Digital Arts, Nebenfach in Unternehmertum
Um eine große Bevölkerungsgruppe zu untersuchen, wählt man zufällig einen kleinen Teil davon aus. Diese Methode, die als Zufallsstichprobe (Random Sampling) bezeichnet wird, gibt jedem die gleiche Chance, ausgewählt zu werden. Sie ist das Fundament für vertrauenswürdige Forschung in Bereichen wie der Medizin und der Meinungsforschung.
Dieser Leitfaden zeigt Ihnen, wie sie funktioniert, welche verschiedenen Techniken zur Verfügung stehen und wie Sie diese in einem realen Projekt anwenden können. Sind Sie bereit zu lernen, wie?
<CTA title="Bessere Forschungsstichproben erstellen" description="Strukturierte Stichprobenpläne schneller erstellen und Verzerrungen im Forschungsprozess reduzieren" buttonLabel="Jenni kostenlos testen" link="https://app.jenni.ai/register" />
Was Zufallsstichproben in der Praxis wirklich bedeuten
In der Praxis bedeutet eine Zufallsstichprobe, dass die Probanden rein zufällig ausgewählt werden – was schwieriger ist, als es klingt.
Die Weltgesundheitsorganisation weist darauf hin, dass dieser unvoreingenommene Ansatz der Schlüssel für genaue Bevölkerungsschätzungen ist.
Eine gute Stichprobe spiegelt die Mischung aus Alter, Einkommen und anderen Merkmalen der gesamten Gruppe wider, was sie für Tests wie die Regressionsanalyse unerlässlich macht. Die Theorie ist unkompliziert, aber die Ausführung scheitert oft.
Forscher stehen häufig vor Problemen wie fehlerhaften Teilnehmerlisten, was sie dazu zwingt, sich mit „zufällig genug“-Methoden zufrieden zu geben, die nicht wirklich zufällig sind. Diese Unterscheidung ist oft die Trennlinie zwischen verschiedenen Forschungsparadigmen in der Wissenschaft.
Für eine echte Zufallsstichprobe benötigen Sie drei Dinge:
Eine vollständige Liste aller Personen in der Bevölkerung.
Eine bekannte Chance für jede Person, ausgewählt zu werden.
Ein Auswahlverfahren, das auf Zufall und nicht auf Bequemlichkeit basiert.
Das Abweichen von diesen Regeln, selbst ein wenig, führt zu Verzerrungen (Bias) und verfälscht Ihre Ergebnisse.
<ProTip title="💡 Pro-Tipp:" description="Überprüfen Sie vor der Auswahl der Teilnehmer immer Ihren Stichprobenrahmen, um versteckte Verzerrungen zu vermeiden" />
Die wichtigsten Methoden der Zufallsstichprobe erklärt
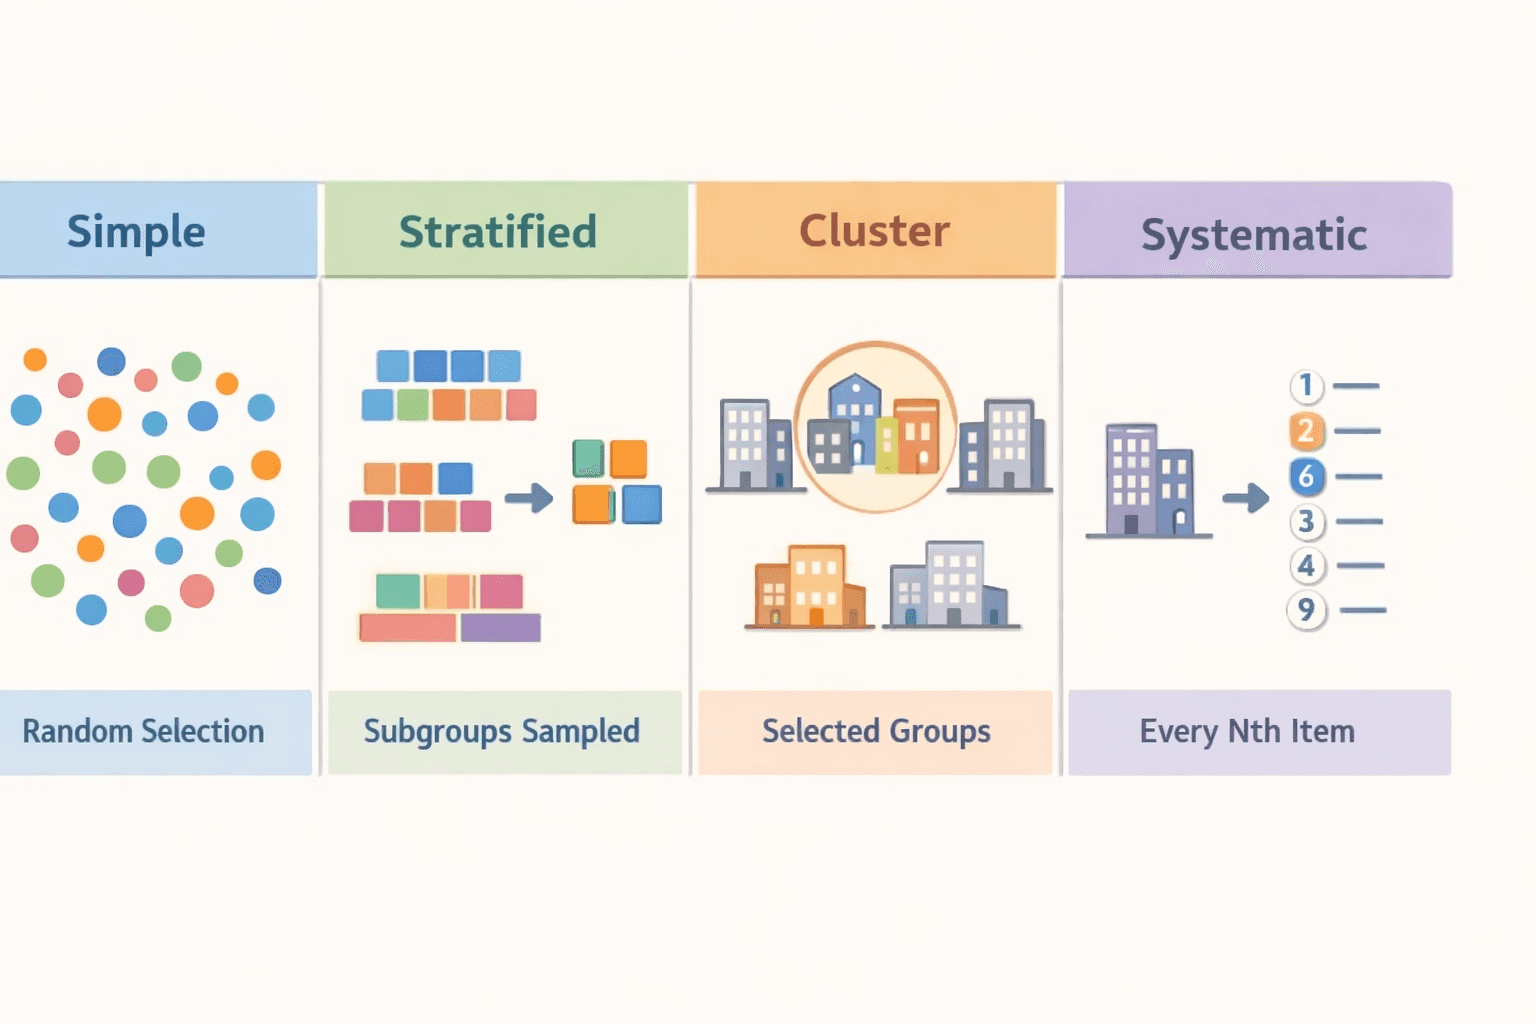
Verschiedene Techniken wenden den Zufall in einer strukturierten Weise an. Die beste Wahl hängt von Ihrem Studiendesign ab, unabhängig davon, ob Sie qualitative oder quantitative Forschung betreiben, und von der Größe der Gruppe, die Sie untersuchen.
Einfache Zufallsstichprobe (die reine Form)
Hier hat jede einzelne Person die gleiche Chance, ausgewählt zu werden. Forscher verwenden in der Regel Zufallszahlengeneratoren oder Ziehungen im Lotteriestil.
Stellen Sie sich eine Klasse mit 500 Schülern vor. Sie würden jedem eine Nummer geben und dann mit einem Generator 50 von ihnen auswählen. Das ist das klassische Lehrbuchbeispiel.
Die statistische Aussagekraft ist hoch, aber sie hängt davon ab, dass man eine perfekte, vollständige Liste der gesamten Bevölkerung hat. Wenn Ihre Liste fehlerhaft ist, sind es die Ergebnisse auch.
Geschichtete Zufallsstichprobe (für eine ausgewogene Repräsentation)
Diese Methode teilt die Bevölkerung in verschiedene Untergruppen auf, wie Altersgruppen oder Einkommensstufen, bevor aus jeder Gruppe eine Zufallsstichprobe gezogen wird. Dadurch wird sichergestellt, dass diese Schlüsselkategorien angemessen vertreten sind.
Eine Gesundheitsumfrage könnte beispielsweise nach Altersjahrzehnten (20-29, 30-39 usw.) schichten, um sicherzustellen, dass alle Gruppen entsprechend ihrem Anteil an der Bevölkerung einbezogen werden.
Die Hauptvorteile bestehen darin, die Variabilität in der Stichprobe zu verringern und ein genaueres Bild von jeder Untergruppe zu erhalten. Sie wird in Bereichen wie der Marktforschung häufig eingesetzt.
Klumpenstichprobe (effizient für große Gruppen)
Anstatt Einzelpersonen auszuwählen, wählen Sie zufällig ganze bereits existierende Gruppen oder „Klumpen“ aus, z. B. indem Sie fünf Schulen zufällig auswählen und alle Schüler an diesen Schulen befragen.
Dies ist eine der gängigsten Methoden der Wahrscheinlichkeitsstichprobe für geografisch verstreute Populationen.
Dieser Ansatz reduziert Reisezeiten, Zeitaufwand und Kosten, was ein großer Vorteil für große, weit verstreute Populationen ist. Der Nachteil ist, dass er in der Regel einen größeren Stichprobenfehler verursacht als Methoden wie die Schichtung.
Systematische Stichprobe (strukturierter Zufall)
Nachdem Sie einen zufälligen Startpunkt ausgewählt haben, wählen Sie jede n-te Person aus Ihrer Liste aus, z. B. jeden 10. Kunden in einer Datenbankwarteschlange.
Sie ist einfach durchzuführen, birgt jedoch ein verstecktes Risiko. Wenn es in der Liste ein wiederkehrendes Muster gibt (z. B. wenn jeder 10. Eintrag immer ein Manager ist), ist Ihre Stichprobe verzerrt.
Vergleich der Methoden
Methode | Bester Anwendungsfall | Größte Stärke | Wesentliche Einschränkung |
Einfache Zufallsauswahl | Kleinere Populationen, für die eine vollständige Liste existiert | Hohe statistische Genauigkeit | Erfordert eine vollständige, genaue Liste |
Geschichtete Auswahl | Populationen mit wichtigen, vielfältigen Untergruppen | Sichert die Repräsentation von Schlüsselmerkmalen | Komplexer in der Planung und Durchführung |
Klumpenauswahl | Große, geografisch verstreute Populationen | Sehr praktisch und kosteneffizient | Hat im Allgemeinen einen höheren Stichprobenfehler |
Systematische Auswahl | Geordnete Datensätze ohne versteckte Muster | Einfach und schnell zu implementieren | Anfällig für zyklische Verzerrungen in der Liste |
All diese Methoden unterstützen den Grundgedanken der Wahrscheinlichkeitsauswahl, aber jede bringt praktische Kompromisse mit sich, die Ihre endgültigen Daten prägen.
<ProTip title="📊 Pro-Tipp:" description="Verwenden Sie die geschichtete Stichprobe, wenn sich Bevölkerungsgruppen in Größe oder Verhalten erheblich unterscheiden" />
Schritt-für-Schritt-Prozess der Zufallsstichprobe
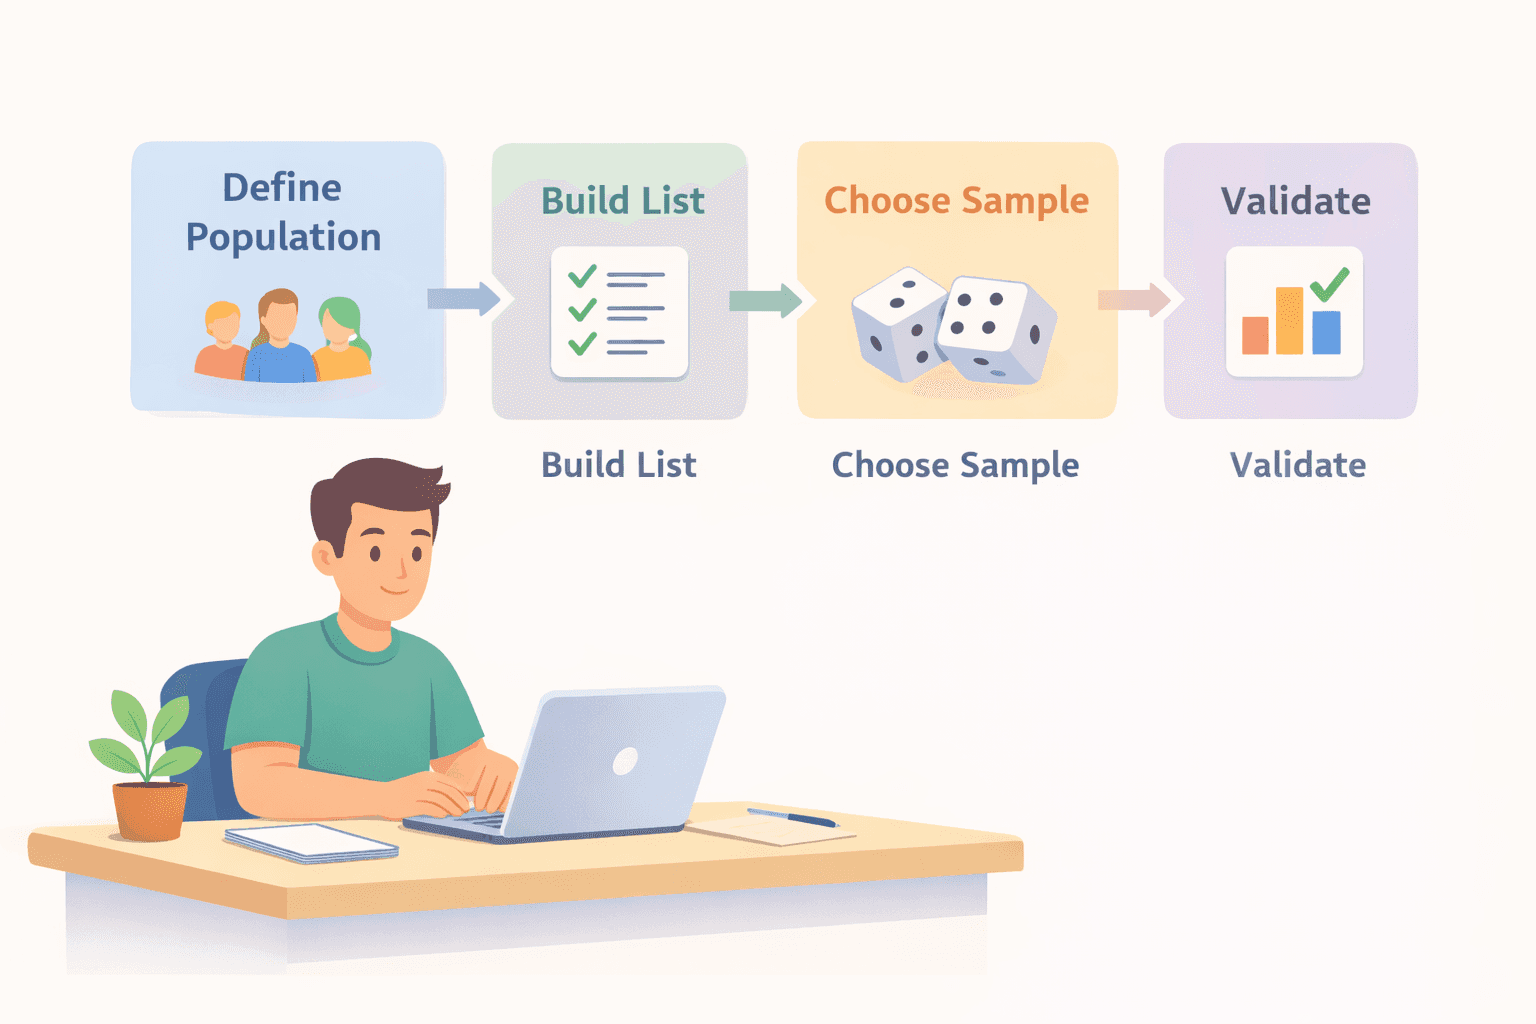
Zufallsstichproben richtig durchzuführen bedeutet, einer klaren Abfolge zu folgen. Wenn Sie eine Phase überspringen, können Ihre Daten leicht verzerrt oder unbrauchbar werden.
Schritt 1: Definieren Sie Ihre Grundgesamtheit und Ihren Umfang
Beginnen Sie damit, genau zu bestimmen, wen oder was Sie untersuchen. Seien Sie präzise: Statt „junge Erwachsene“ definieren Sie es als „alle im Jahr 2024 eingeschriebenen Universitätsstudenten in Surabaya“. Diese erste Entscheidung prägt Ihren gesamten Forschungsplan und zeigt Ihnen, ob das Projekt überhaupt machbar ist.
Schritt 2: Erstellen Sie einen Stichprobenrahmen
Dies ist Ihre Masterliste. Sie muss jedes einzelne Mitglied der soeben definierten Population enthalten. Wenn Personen auf dieser Liste fehlen, haben sie keine Chance, ausgewählt zu werden, was die Zufälligkeit sofort zunichte macht.
Das Pew Research Center hat fehlerhafte Stichprobenrahmen als eine der Hauptursachen für Verzerrungen in großen Umfragen identifiziert.
Schritt 3: Bestimmen Sie den Stichprobenumfang
Wie viele Einheiten müssen Sie auswählen? Die Antwort wägt Vertrauen und Präzision ab. Eine Analyse der Harvard T.H. Chan School of Public Health weist darauf hin, dass eine größere Stichprobe die Zuverlässigkeit nur dann erhöht, wenn die Auswahl wirklich zufällig ist.
Verwenden Sie einen Stichprobenrechner, um Ihr Konfidenzniveau und Ihre Fehlermarge auszubalancieren. Um Ihre Größe zu berechnen, müssen Sie sich für drei Dinge entscheiden:
Ihr Konfidenzniveau (normalerweise 95%)
Eine akzeptable Fehlermarge
Die erwartete Variabilität innerhalb Ihrer Bevölkerung
Schritt 4: Wenden Sie die Zufallsauswahl an
An dieser Stelle nutzen Sie den Zufall, um Ihre Stichprobe aus dem Rahmen auszuwählen. Zu den gängigen Werkzeugen gehören:
Ein digitaler Zufallszahlengenerator
Eine gedruckte Tabelle mit Zufallszahlen
Spezialisierte Software für die computergestützte Auswahl. Der Schlüssel liegt darin, jede menschliche Entscheidung aus dem Prozess auszuschließen.
Schritt 5: Repräsentativität validieren
Sobald Sie Ihre Stichprobe haben, gehen Sie nicht einfach davon aus, dass sie gut ist. Überprüfen Sie sie. Vergleichen Sie die grundlegenden Merkmale der Stichprobe, wie das Durchschnittsalter oder die Geschlechterverteilung, mit dem, was Sie über die Gesamtbevölkerung wissen.
Wenn die Stichprobe merklich anders aussieht, ist etwas schiefgelaufen. Sie müssen wahrscheinlich zu einem früheren Schritt zurückkehren, oft um den Stichprobenrahmen oder die Auswahlmethode zu korrigieren.
<ProTip title="🧪 Pro-Tipp:" description="Testen Sie Ihre Stichprobenmethode mit kleinen Simulationen vor der eigentlichen Datenerhebung" />
Warum Menschen „zufällig genügen“ Stichproben misstrauen
Diese Skepsis ist begründet. In der realen Welt müssen sich viele Forscher mit „zufällig genügen“-Methoden begnügen, und Online-Foren sind voll von Menschen, die sich fragen, ob ihr Ansatz wirklich valide ist.
Eine beliebte Abkürzung ist die Gelegenheitsstichprobe (Convenience Sampling): Die Befragung Ihrer Klassenkameraden, das Posten einer Umfrage in einer bestimmten Facebook-Gruppe oder die Befragung der ersten 100 Website-Besucher.
Diese Gruppen wirken zugänglich und vielfältig, aber die Auswahl basiert nicht auf dem Zufall. Sie basiert darauf, wer am einfachsten zu erreichen ist, was eine klassische Form der Verzerrung darstellt.
Ein weit verbreitetes Missverständnis ist, dass die Erfassung von mehr Personen das Problem löst. Das tut es nicht. Eine verzerrte Stichprobe von tausend Personen ist grundlegend weniger vertrauenswürdig als eine echte Zufallsstichprobe von hundert Personen.
Wenn Sie keine vollständige Liste haben, aus der Sie ziehen können, können Sie nicht behaupten, es handele sich um eine Wahrscheinlichkeitsstichprobe. Diese anhaltende Lücke ist der Grund, warum viele Studien scheitern, wenn Forscher schließlich versuchen, eine Fachzeitschrift für die Veröffentlichung ihrer Forschung auszuwählen, da Peer-Reviewer auf die Stringenz der Stichprobenziehung achten.
Zufallsstichprobe vs. Nicht-Wahrscheinlichkeitsstichprobe
Diesen Unterschied richtig zu verstehen, ist von grundlegender Bedeutung. Ihre Wahl bestimmt, ob Sie Ihre Ergebnisse auf eine größere Gruppe verallgemeinern können.
Wie sie sich in der Praxis unterscheiden
Aspekt | Zufallsstichprobe | Nicht-Wahrscheinlichkeitsstichprobe |
Wie die Auswahl funktioniert | Rein zufällig (z. B. eine Lotterie) | Basierend auf dem Urteil oder der Bequemlichkeit des Forschers |
Risiko einer Verzerrung | Theoretisch gering, wenn korrekt durchgeführt | Inhärent hoch und oft unkontrollierbar |
Statistische Inferenz | Ermöglicht gültige Schätzungen für die gesamte Bevölkerung | Unterstützt keine statistische Verallgemeinerung |
Die Zufallsstichprobe ist die Grundlage für die Mathematik, die es Ihnen ermöglicht, Vorhersagen zu treffen (Inferenzstatistik). Eine Nicht-Wahrscheinlichkeitsstichprobe kann nicht garantieren, dass Ihre Stichprobe die breitere Bevölkerung widerspiegelt.
Wann man welchen Ansatz wählt
Wählen Sie die Zufallsstichprobe, wenn Ihre Schlussfolgerungen präzise und vertretbar sein müssen. Dies ist entscheidend für:
Klinische Studien und die Erforschung der öffentlichen Gesundheit
Offizielle Regierungsstatistiken, wie z. B. eine Volkszählung
Formale akademische Studien, deren Ergebnisse veröffentlicht werden
Entscheiden Sie sich unter bestimmten praktischen Einschränkungen für Nicht-Wahrscheinlichkeitsmethoden:
Ihr Projekt hat sehr enge Zeit- oder Budgetgrenzen
Sie benötigen lediglich erste, explorative Erkenntnisse, wie z. B. Marktfeedback in der Frühphase
Es ist unmöglich, auf die gesamte Bevölkerung zuzugreifen oder sie aufzulisten (z. B. bei der Untersuchung einer verborgenen Gemeinschaft)
Kurz gesagt: Verwenden Sie Zufallsstichproben, um etwas zu beweisen; verwenden Sie Nicht-Wahrscheinlichkeitsstichproben, um etwas kennenzulernen.
<ProTip title="⚖️ Pro-Tipp:" description="Bezeichnen Sie Gelegenheitsstichproben in Forschungsberichten nicht als Zufallsstichproben" />
Praktische Anwendungen von Zufallsstichproben
Diese Methode ist nicht nur eine Idee aus dem Lehrbuch. Sie ist ein praktisches Werkzeug, das in verschiedenen Bereichen eingesetzt wird, um Entscheidungen zuverlässiger zu machen und Verzerrungen abzubauen.
Im Gesundheitswesen ist sie das Rückgrat vertrauenswürdiger klinischer Studien und Untersuchungen, die die Ausbreitung von Krankheiten verfolgen. Beispielsweise verwendet das CDC Wahrscheinlichkeitsstichproben, um zu schätzen, wie viele Menschen in den USA an einer bestimmten Krankheit leiden, was wiederum als Richtschnur für die öffentliche Gesundheitspolitik dient.
Für die Marktforschung sind Unternehmen darauf angewiesen. Wenn ein Unternehmen wissen möchte, was Kunden über ein neues Produkt oder den Ruf einer Marke denken, nutzen sie Zufallsstichproben, um ein unvoreingenommenes Bild ihrer Zielgruppe zu erhalten.
Der Bereich der Datenwissenschaft und des maschinellen Lernens stützt sich stark darauf. Analysten verwenden Zufallsstichproben, um ausgewogene Trainingsdatensätze für Algorithmen aufzubauen.
Grundlegende Techniken wie das Bootstrap-Sampling (das Daten erneut zieht, um Unsicherheiten zu schätzen) und Monte-Carlo-Simulationen (die Wahrscheinlichkeiten modellieren) basieren auf wiederholten Zufallsziehungen.
Sie finden sie auch im Einsatz bei:
Sozialwissenschaften, für nationale Umfragen zu Themen wie Wahlen oder Beschäftigung.
Regierungen, für die Gestaltung präziser Volkszählungen und Audits.
Geschäftsabläufen, zur Validierung der Produktqualität in einer Produktionslinie.
In all diesen Bereichen ist der rote Faden die Verwendung von Zufallsstichproben, um Rohdaten in verwertbare Analysen zu verwandeln und so von Vermutungen zu fundierten Entscheidungen überzugehen.
Häufige Fehler und Best Practices
Selbst erfahrene Teams können Fehler machen, die die Qualität ihrer Daten von Anfang an untergraben.
Häufige Fehler
Einige weit verbreitete Probleme schwächen die Integrität der Stichprobe immer wieder:
Verwendung einer veralteten oder unvollständigen Liste der Gesamtbevölkerung.
Verwechslung von leicht zu beschaffenden „Gelegenheitsdaten“ mit einer echten Zufallsstichprobe.
Auslassen der notwendigen Mathematik, um zu bestimmen, wie groß die Stichprobe sein muss.
Versäumnis, sicherzustellen, dass wichtige Untergruppen innerhalb der Bevölkerung angemessen vertreten sind.
Praktische Schritte für bessere Genauigkeit
Die Verbesserung Ihres Prozesses beruht auf einigen disziplinierten Gewohnheiten:
Definieren Sie Ihre Zielgruppe präzise, bevor Sie beginnen.
Beziehen Sie Ihren Stichprobenrahmen aus verifizierten, umfassenden Daten.
Verwenden Sie geeignete Randomisierungswerkzeuge oder -dienste, wählen Sie Namen nicht einfach manuell aus.
Validieren Sie Ihre endgültige Stichprobe, indem Sie deren demografische Merkmale mit bekannten Bevölkerungsdaten abgleichen.
Eine sorgfältig konzipierte Stichprobenmethode unterscheidet nützliche, glaubwürdige Daten von einer Sammlung irreführender Zahlen.
Machen Sie die Zufallsstichprobe von Anfang an richtig
Man spürt es, wenn die Stichprobe das, was man untersuchen möchte, nicht vollständig widerspiegelt – und es macht es schwieriger, den Ergebnissen zu vertrauen. Es bremst Ihren Fortschritt und wirft Fragen auf, die Sie nicht erwartet haben. Selbst kleine Fehltritte bei der Auswahl der Teilnehmer können alles beeinflussen. Dieses Risiko ist real.
<CTA title="Intelligentere Forschungs-Workflows gestalten" description="Stichprobenmethoden planen und Forschung schneller strukturieren mit geführter KI-Unterstützung" buttonLabel="Jenni kostenlos testen" link="https://app.jenni.ai/register" />
Die Nutzung von Jenni hilft Ihnen, Ihre Stichprobenziehung klarer zu planen, damit Ihre Forschung auf Kurs bleibt. Sie unterstützt Sie bei der Strukturierung von Methoden und der Erklärung Ihres Ansatzes, sodass Ihre Arbeit leichter zu verteidigen und zu verstehen ist. Es ist ein einfacher Weg, um solide Ergebnisse zu sichern.