
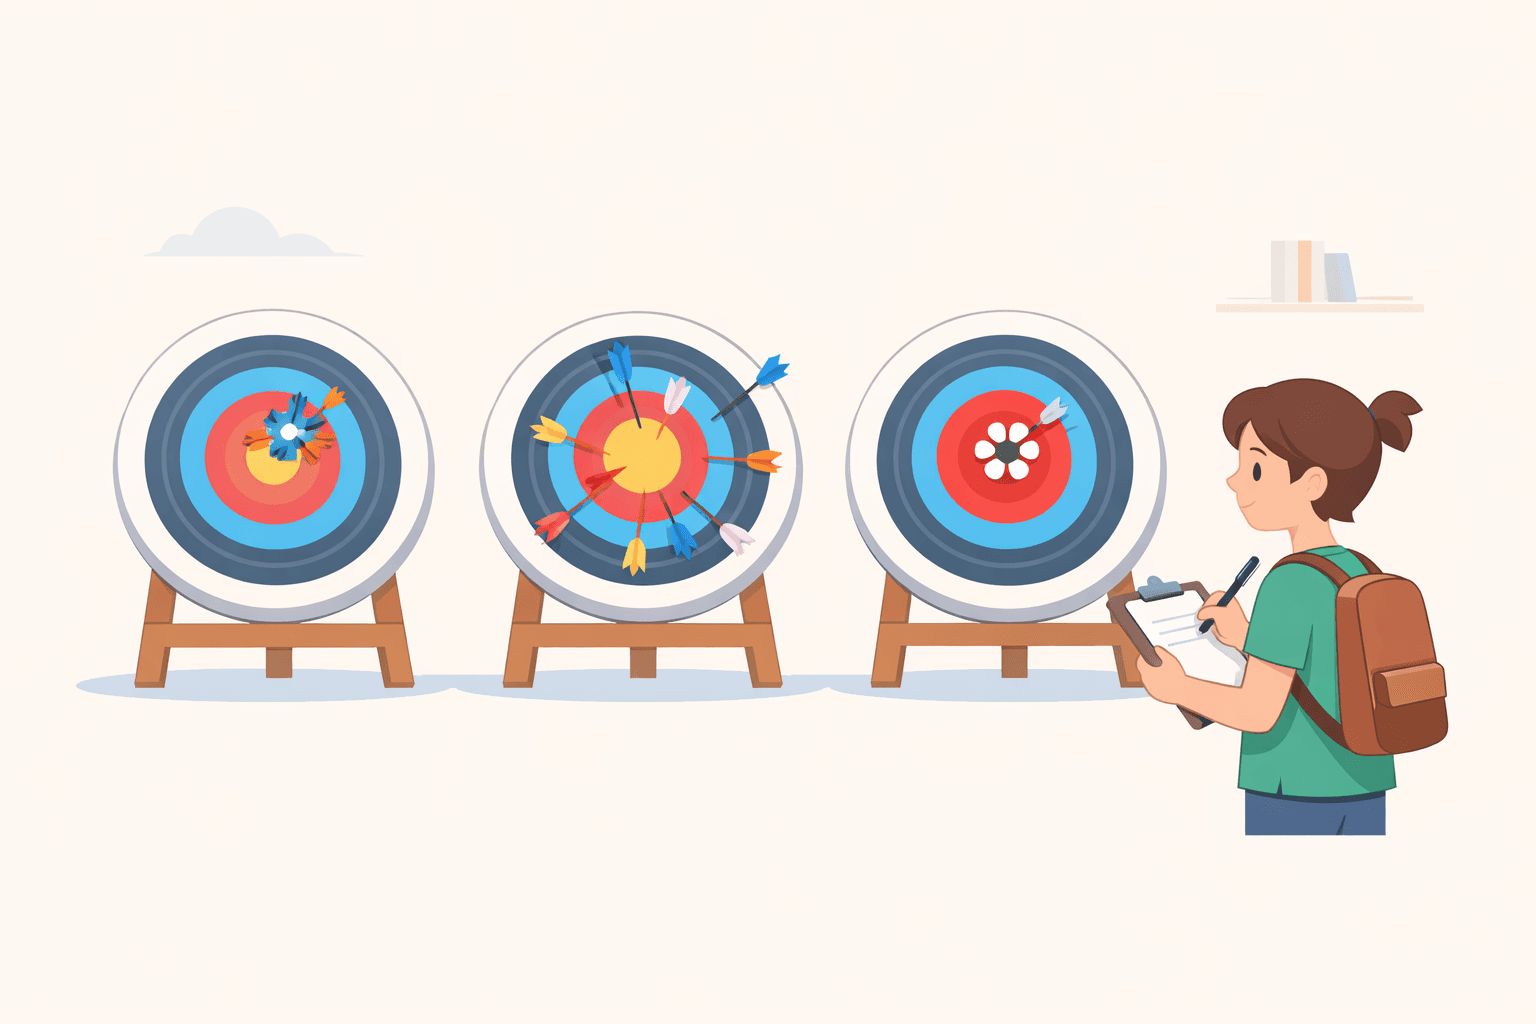
效度(Validity)探討的是您的研究是否確實衡量了它聲稱要衡量的主題。信度(Reliability)則是檢驗如果您再次進行該項研究,是否會得到相同的結果。無論您在項目背後投入了多少資金,粗糙的設計或模糊的測量工具都會將這兩者破壞殆盡。
本指南為您提供了具體的步驟來解決這個問題。我們將通過清晰的實例,向您展示如何精準化您的測量、收緊您的研究設計,並解決典型的數據問題。請繼續閱讀以獲取實用的解決方案。
<CTA title="加強您的研究設計" description="在幾分鐘內創建結構化、清晰且站得住腳的研究框架,免除混亂。" buttonLabel="免費試用 Jenni" link="https://app.jenni.ai/register" />
步驟 1:精準定義並測量構念
在您研究任何事物之前,您需要先定義您正在觀察的對象。模糊的概念會導致不穩定的結果。
以「壓力」或「學習」等寬泛的概念為例。您無法直接測量這些概念。您必須將它們轉化為您實際上可以計數或評分的指標。這被稱為將您的變量「操作化」(operationalizing)。
壓力可以轉化為血液樣本中測得的皮質醇水平,或者使用李克特量表的問卷評分。
學習可以通過測試成績或某人在執行特定任務時的表現來定義。
這種從理論到測量的轉化,是建構效度(construct validity)的第一步,也是最重要的一步。它能確保您的數據確實反映了您的想法。
如果已經存在良好的測量工具,就不要自己重新製造尺規。使用經過驗證的工具可以減少誤差並提升研究的可信度。
這類工具通常會自帶其內部一致性信度的評分,例如克隆巴赫係數(Cronbach's alpha)在 0.7 以上,這是一個常見的基準。
美國國家衛生研究院(NIH)指出,使用已建立且經過驗證的工具能顯著提高研究中的測量準確性。
一個優秀的工具通常包含以下方面的說明文檔:
其內容效度(content validity)是如何建立的(它是否涵蓋了該概念的所有部分?)。
其效標關聯效度(criterion validity)的證據(它是否與已知的黃金標準相符?)。
其在以往使用中的信度評分。
您還需要檢查不同類型的效度。它們不可互相替代;每一種都測試著拼圖中不同的板塊。
內容效度:您的測量是否包含了您概念的所有重要維度?
建構效度:您的測量表現是否符合您的理論預期?
效標關聯效度:您的測量是否與另一個針對同一事物的、公認的測量高度相關?
兼顧這三者可以確保您的研究結果是有意義的,而不僅僅是一直錯得很有規律。
<ProTip title="💡 專業提示:" description="使用經過驗證的量表來減少測量誤差並迅速提高可信度。" />
步驟 2:加強研究設計並控制偏差
您研究的設計是它的骨架。脆弱的骨架會讓一切分崩離析。
首先,確保您的設計確實契合您提出的問題。如果您想知道 A 是否導致 B,您需要進行實驗。僅憑一項調查問卷是無法給您這個答案的。
使用正確的方法可以加強您研究的內部效度(internal validity),並使您的統計結果更容易解釋。
您還必須控制混雜變量。在醫學試驗中,隨機分配和雙盲程序等標準技術正是被專門用來減少偏差的。
世界衛生組織指出,更好的準實驗實踐和控制設計能顯著提升可信度。
接下來,使一切標準化。給每位參與者完全相同的指示。在相同的環境中進行測試。保持時間點的一致性。
這減少了數據中隨機、雜亂的誤差,是支持測量信度的直接方法。微小的不一致(例如問題措辭的細微變化)會悄悄降低您整個數據集的信度。
最後,不要跳過預調查(pilot test)。在您投入正式研究之前,先在一個 10-20 人的小群體中運行完整流程。這種預演能幫您發現模糊不清的問題、調整不當的時間安排,並捕捉到低信度的早期跡象。
這是在您將時間和資源投入到大規模項目之前,提高效度和信度最快、最實用的方法之一。
<ProTip title="⚠️ 提醒:" description="流程中微小的不一致會悄悄降低整個數據集的信度。" />
步驟 3:改進抽樣與推廣性
您研究的對象與您如何研究他們同樣重要。您的抽樣方法決定了您的研究結果是否適用於您特定群體之外的其他人。
為了提高可推廣性(generalizability),請儘可能使用概率抽樣。這意味著您目標總體中的每個人都有已知的機會被選中,這使您的樣本更具代表性並減少了偏差。常見的方法有:
隨機抽樣
分層抽樣
整群抽樣
更大的樣本量可能有所幫助,但這並非萬靈藥。如果您的測量工具存在缺陷,更大的樣本量只會讓這種缺陷在統計上顯得更穩定、更明顯。請務必坦誠說明您在抽樣上的局限性。
理解信度與效度之間的核心區別有助於您意識到,如果根基不穩,偏差會隨著樣本量放大而等比例放大。
這就是為什麼提高測量的準確性比單純追求更大的樣本量(N 值)更為重要。請務必坦誠說明您在抽樣上的局限性。
如實報告哪些人被納入(以及哪些人被排除)、您是如何招募人員的,以及可能存在哪些偏差,實際上能增強您的可信度。即使您的設計面臨實際約束,這也能建立起信任。
步驟 4:通過一致性提高信度
信度關乎一致性。如果您再次測量,或者由不同的人來測量,您能得到相同的結果嗎?
如果是由他人來收集或編碼您的數據,他們需要接受適當的培訓。一個不一致的觀察者會增加多餘的噪聲。
培訓會議和校準練習可用於提高評分者間信度(interrater reliability,不同人之間的一致性)和評分者內信度(intrarater reliability,同一個人在一段時間內的一致性)。
您可以使用 Cohen's kappa 或組內相關係數等統計數據來正式衡量這一點。您的問卷設計至關重要。糟糕的問題會同時破壞效度和信度。
避免使用會誘導特定答案的誘導性問題。
避免使用一次詢問兩件事的雙管問題(例如:「您覺得這款軟體實用且易於使用嗎?」)。
避免使用可能產生不同解讀的模糊語言。
相反,應專注於清晰、中立的措辭。
最後,不要依賴單一的測量。使用多重檢驗。在定量研究中,利用重測法。在定性研究中,使用三角互證(triangulation),將訪談、觀察和文獻分析結合起來,以檢驗您的結論是否站得住腳。
了解研究中各種不同類型的信度有助於您為自己的數據選擇合適的檢驗方式。
在定量研究中,使用多項目量表和重測信度(對同一群人進行兩次測量)。
在定性研究中,使用三角互證。將訪談、觀察和文獻分析結合起來,看看您的結論在不同的資料來源中是否能保持一致。
<ProTip title="💡 專業提示:" description="三角互證通過跨方法或跨來源確認結果,進而增強研究結果。" />
步驟 5:加強定性研究的效度與信度
對於定性研究,目標是可信度和深度,而不僅僅是數值上的一致。其策略有所不同。
一種強有力的方法是成員檢核(member checking)。在您分析完數據後,您返回去讓參與者審核您的解讀。
您的總結符合他們的經歷嗎?這一步驟起到了現實檢驗的作用,提升了您研究結果的可信度。
您還需要保持詳細的審計軌跡(audit trail),記錄您在研究過程中做出的每一項決定。
這能支持研究的依賴性(dependability)。此外,通過理解定性研究與定量研究的細微差別來使您的方法與眾不同;例如,定性研究在很大程度上依賴於反思性(reflexivity),即您主動承認並審視自己的偏見。
這應包括您關於如何對數據進行編碼的筆記、您在收集過程中的觀察,以及您作為研究者的自身反思。
這些文檔支持了您工作可靠性,它展示了您是如何得出結論的。
一個關鍵的實踐是將三角互證與反思性相結合。反思性意味著作為研究者,要主動承認自己的偏見和觀點。
然後,您將這種自我意識與三角互證相結合,使用多種方法(如訪談和觀察)或從不同來源收集數據。
這些實踐結合在一起,增強了您研究的确證性(confirmability),使您的結論更加穩固。
<ProTip title="🧠 洞察:" description="在定性分析中,反思性有助於您將解讀與個人偏見區分開來。" />
步驟 6:使用統計和分析保障措施
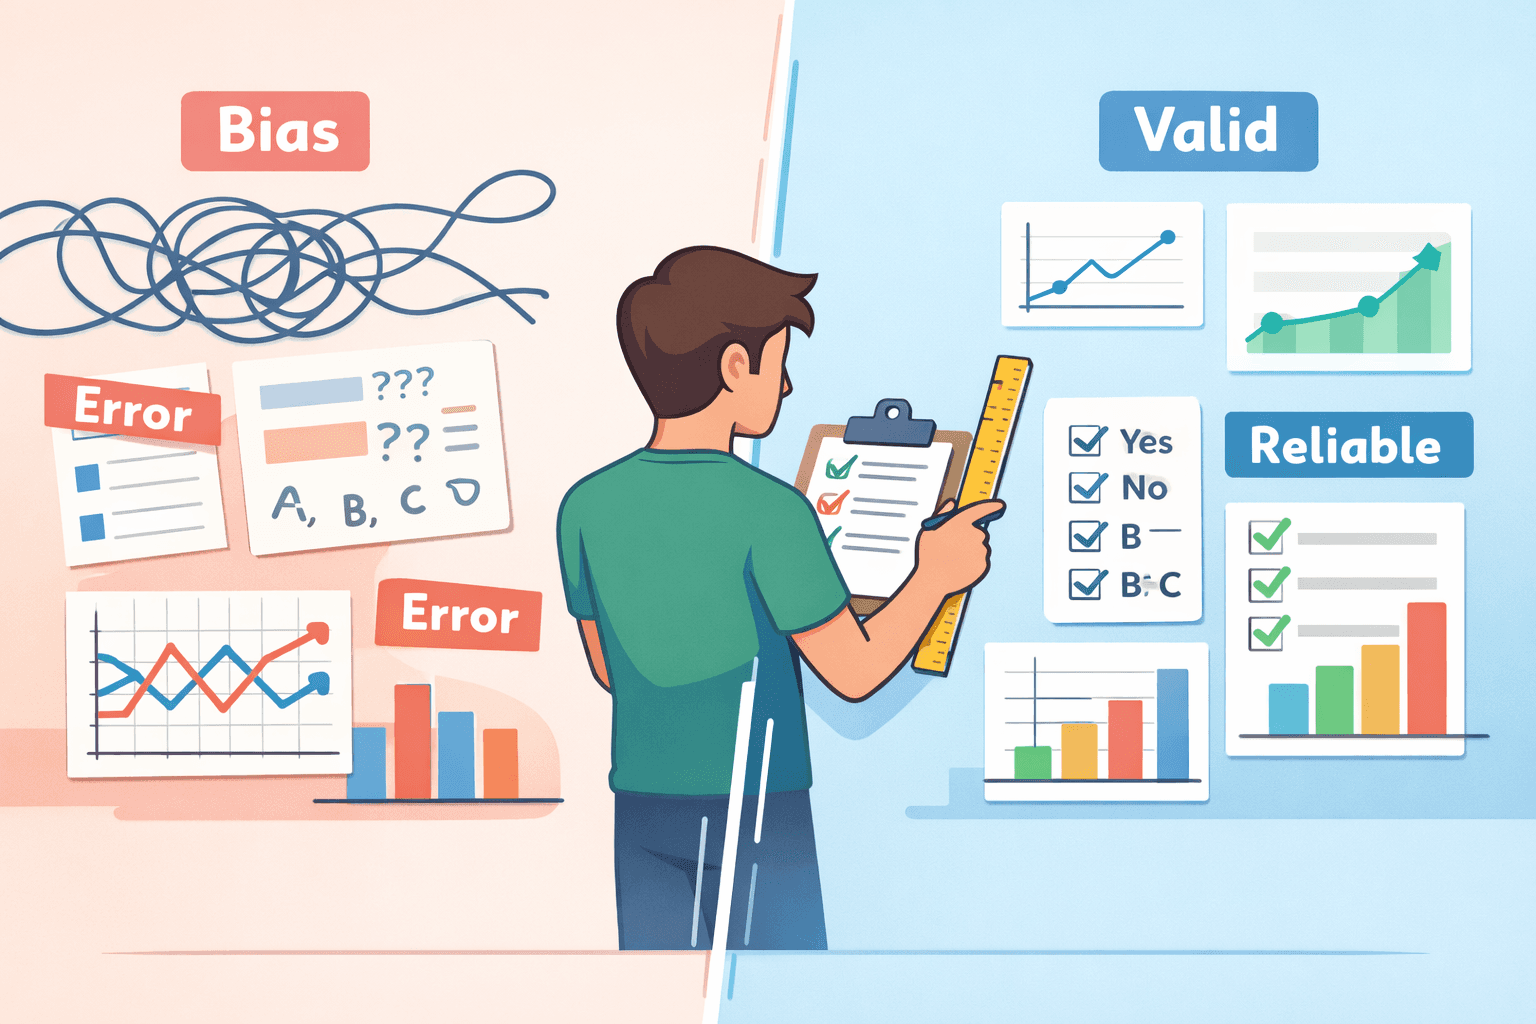
統計分析不僅僅是為了解析結果,也是為了檢查數據的完整性。
首先,使用特定的測試來評估信度。常用的方法有:
克隆巴赫係數 (Cronbach's alpha)(用於評估量表的內部一致性)
折半信度 (Split-half reliability)
複本信度 (Parallel forms reliability)
Cronbach's alpha 評分高於 0.7 是一個典型(儘管並非絕對)的可接受信度基準。
然後,運行穩健性(robustness)和敏感性(sensitivity)檢驗。看看當您改變條件時,您的核心發現是否依然成立。
嘗試剔除異常值、調整您的模型假設,或者使用完全不同的分析方法。如果結果保持穩定,這就是信度良好的強烈信號。
最後,將您的分析與已確立的研究正規(research paradigms)保持一致,以確保您的分析保障措施與您的理論框架相匹配。
如果您的統計檢驗顯示信度較低,請將這些發現視為初步結果。避免從薄弱的數據中得出強烈、絕對的結論。
避免從薄弱的數據中得出強烈、絕對的結論。這能保護您的信譽,並支持您研究的整體可重複性(reproducibility)。
快速對比:效度 vs 信度
理解兩者的區別有助於您進行有策略的提升。
維度 | 效度 | 信度 |
定義 | 衡量準確性。您測量的是正確的事物嗎? | 衡量一致性。您能再次得到相同的結果嗎? |
核心關注 | 結果的正確性。 | 結果的穩定性。 |
示例 | 您的測試確實測量了智力,還是僅僅測量了應試技巧? | 如果您對同一個人測量兩次,您得到的評分大致相同嗎? |
關鍵方法 | 建構效度驗證、三角互證。 | 重測法、克隆巴赫係數(Cronbach's alpha)。 |
風險 | 測量了錯誤的概念。 | 得到不一致的結果。 |
您兩者都需要。有信度但無效度的數據是持續錯誤的。有效度但無信度的數據則不可信。
損害效度與信度的常見錯誤
研究人員經常會陷入相同的陷阱,這會削弱他們的工作,並經常出現在同行評審的意見中。
以下是一些常見的錯誤:
過度依賴樣本量而忽視測量質量。 認為更大的 N 值能解決所有問題,然而當測量存在缺陷時,只會讓這個缺陷在統計上更穩定。
僅為了提高 Cronbach's alpha 而刪除題目。 為了達到 0.7 這個魔術數字而對問卷進行微調,卻沒有檢查是否實際上損害了量表的內容效度。
使用便利樣本(convenience samples)而不承認其偏差。 僅研究容易接觸到的人群,卻沒有清晰說明這如何限制了您研究結果的適用對象。
跳過預調查(pilot test)。 如果您跳過試運行,您可能會因為沒有事先進行測試而收集到糟糕或混亂的數據,從而面臨風險。
忽視混雜變量。 在設計研究時,未能控制可能解釋您結果的其他因素,這在您的論證中留下了一個重大漏洞。
<ProTip title="⚠️ 警告:" description="如果盲目進行,通過刪除項目來修復信度可能會削弱建構效度。" />
讓您的研究經得起審查
您一定體會過這種挫敗感:當您的結果不太對得上,或者在評審中顯得站不穩腳。這會拖慢一切進度,並讓您對自己的工作產生懷疑。定義或流程中的微小漏洞都可能使整個結果產生偏差。這就是問題所在。
<CTA title="設計經得起審查的研究" description="快速將您的研究想法轉化為結構化、可靠且有效力的框架。" buttonLabel="免費試用 Jenni" link="https://app.jenni.ai/register" />
使用 Jenni 有助於您在整個過程中使一切保持嚴密且易於追蹤。它支持您如何定義、構建和記錄您的工作,使您的研究結果保持一致和清晰。這是避免混亂修改並對您展示的內容充滿信心的簡單方法。