
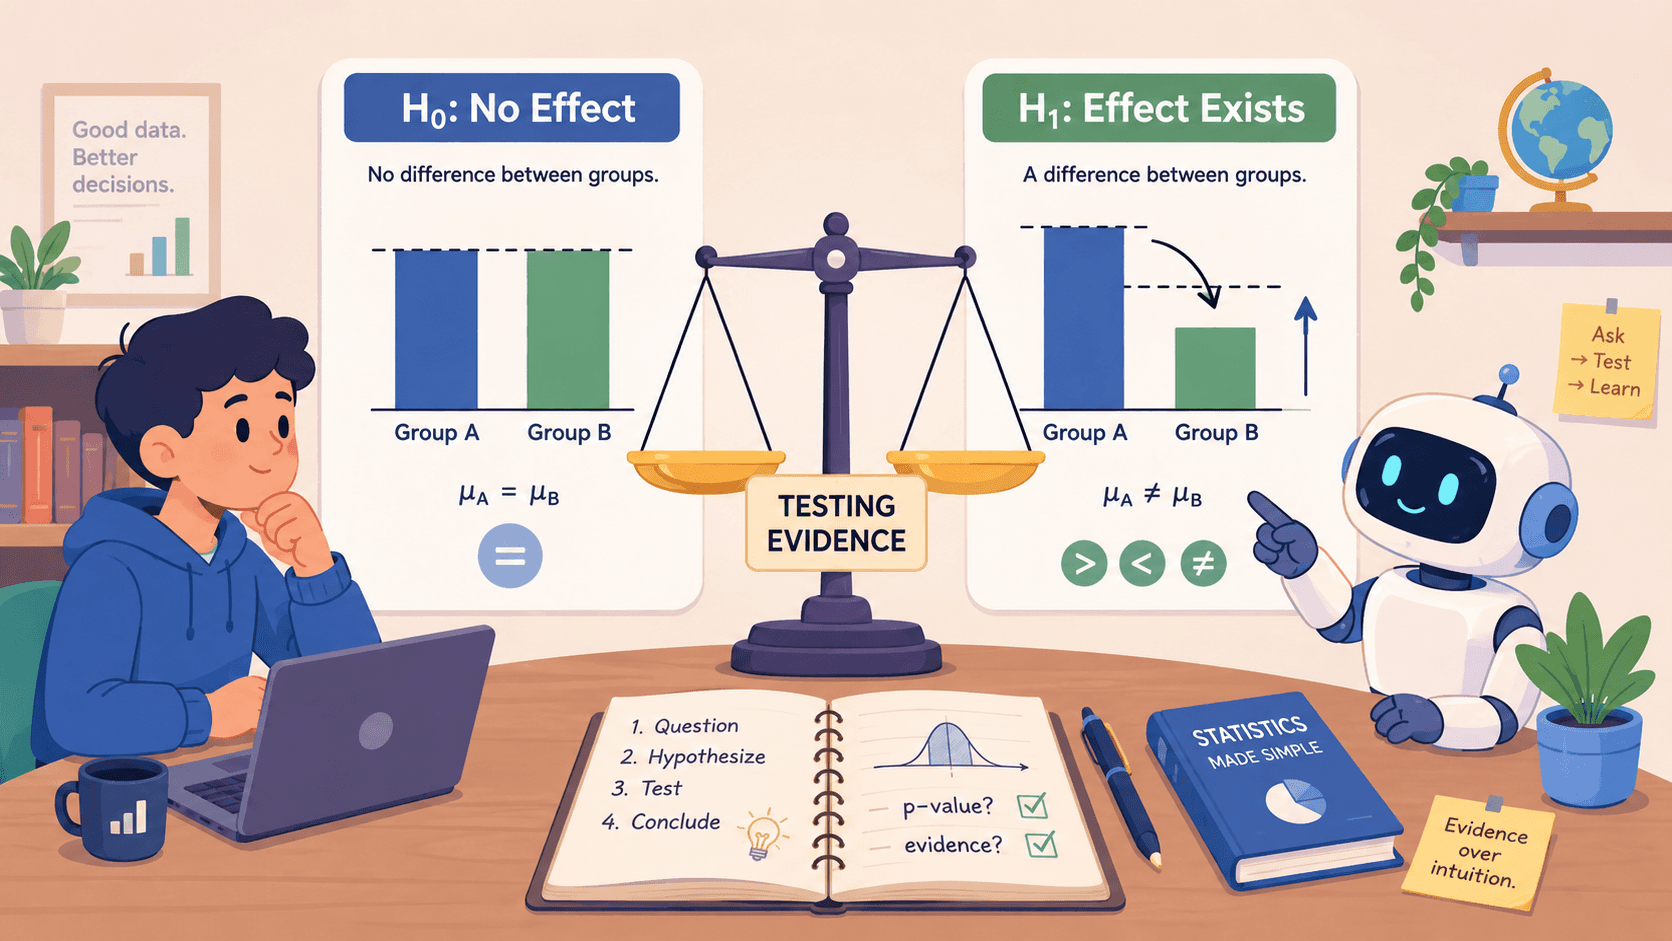
統計学的検定は、シンプルな問いから始まります。「この結果は本物か、それとも単なる偶然か?」 帰無仮説と対立仮説はそのために存在します。これらは、医学、ビジネス、教育などの分野の研究者が、それを明らかにするために検定を設定する際の正式な手法です。データを使用して意思決定を行うあらゆる研究で、これらを目にすることになります。
ここでは、具体例を交えて解説し、多くの人が陥りがちな落とし穴を指摘し、自身で仮説を作成するためのわかりやすいガイドを提供します。読み終える頃には、これら2つの表明がすべての統計的調査をどのように構成しているのかを正確に理解できるようになっているでしょう。
<CTA title="明確な研究仮説を作成する" description="構造化されたガイダンスに従って、研究上の問いを精密で検証可能な仮説へと変換しましょう。" buttonLabel="Jenni を無料で試す" link="https://app.jenni.ai/register" />
帰無仮説と対立仮説とは何か?
これらは、研究対象である母集団に関する2つの相反する表明です。統計学における「疑わしきは罰せず(無罪推定)」の仕組みと考えてください。検定を行う目的のすべては、データが実際にどちらを支持しているかを確認することにあります。
米国国立標準技術研究所(NIST)は、これを帰無仮説と対立仮説のプロセスと定義しており、サンプルデータが母集団に関する初期の仮定に適合しているか、あるいは適合していないかを検証します。
帰無仮説 (H0)
これはデフォルトの、疑い深い立場です。「何も興味深いことは起きていない」「変化はない」「違いはない」「関連性はない」という仮定です。この仮説を覆すための証拠を集めることになります。
例:
2つの教授法による平均テストスコアは同一である。
新薬は血圧にまったく影響を与えない。
勉強に費やした時間は、最終成績に影響しない。
記号で表す場合、通常は等号が含まれます。
H0: μ₁ = μ₂(平均値は同じである)
H0: ρ = 0(相関はゼロである)
対立仮説 (H1 または Ha)
これは、研究者が実際に信じていること、あるいは証明したいことです。「効果、違い、または関係が存在する」ということを主張します。
例:
教授法Aは、教授法Bよりも高いスコアをもたらす。
新薬は血圧を低下させる。
勉強時間の増加は、成績の向上と関連している。
これは不等号(≠、>、または <)を用いて記述されます。
H1: μ₁ ≠ μ₂(平均値は異なる)
H1: μ₁ > μ₂(最初の平均値の方が大きい)
H1: μ₁ < μ₂(最初の平均値の方が小さい)
<ProTip title="💡 プロのヒント:" description="統計検定の論理に合わせるため、帰無仮説には常に等号を含めるようにしましょう。" />
なぜ帰無仮説と対立仮説は多くの学生を混乱させるのか
これはよくあるハードルです。定義を読むことはできても、なぜこのような設定にするのかという「論理」がピンとこないことがよくあります。混乱が生じる主な原因は以下の通りです。
「なぜ入れ替えてはいけないのか?」という問題
多くの学生がこの質問をします。対立仮説が正しいと信じているなら、なぜそれを帰無仮説にしないのでしょうか? その理由はメカニズムにあります。統計検定の計算は、まず帰無仮説が正しいと仮定することから始まるからです。
有名なp値など、計算するすべての確率は、その出発点に基づいています。これらを入れ替えてしまうと、根本的な仕組みが崩れてしまいます。
これがより広い科学的枠組みにどのように適合するのかを深く理解するために、異なる研究パラダイムを理解することは、なぜこの特定の懐疑的なアプローチを使用するのかを明確にするのに役立ちます。
法廷の例えが分かりやすいでしょう。
H0: 被告は無罪である。
H1: 被告は有罪である。
裁判は無罪を証明しようとするものではありません。証拠が、無罪の推定を覆す(棄却する)のに十分なほど強力であるかどうかを問うのです。
フラストレーションは本物
学習フォーラムでは、何度も同じ投稿を目にすることになります。
「章を3回読んだけど、まださっぱりわからない。」
「授業では理解できるけど、自分で応用できない。」
これは、この概念が実際の用途から切り離され、単なる記号やルールとして教えられている場合に起こりがちです。
実際に理解を定着させるもの
実際に動いているところを見る必要があります。この枠組みは、具体的なシナリオにおいてすぐに理解できるようになります。
ウェブサイトのボタンの A/B テストを実施する。
新薬がプラセボよりも効果があるかどうかを判断する。
2つのカリキュラム間で生徒の成績を比較する。
数式に入る前に、具体的で有形の問題に対して対となる仮説が書き出されているのを見ることが、真の理解を築くことにつながります。
研究上の問いから仮説へ:シンプルなプロセス
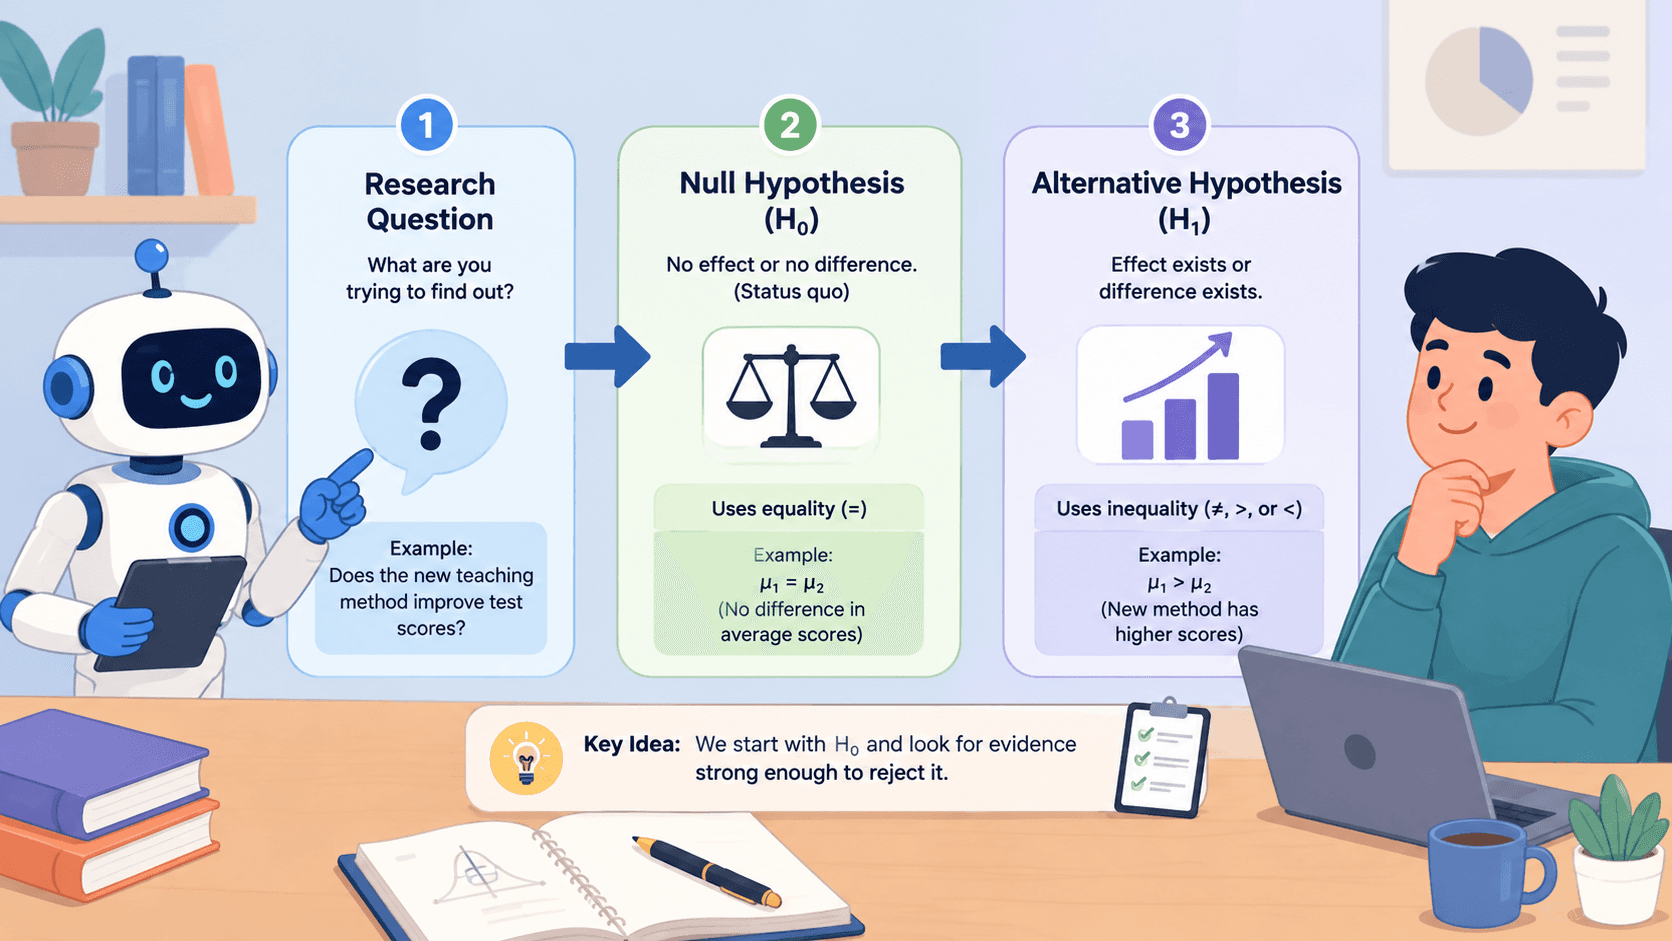
これは3ステップのプロセスです。目標は、大まかな研究アイデアを、検証可能で具体的な一対の表明に変換することです。
ステップ 1: 直接的な問いを立てる
具体的なことから始めましょう。曖昧なアイデアは避けます。研究上の問いを効果的に書く方法を知ることは、有効な仮説への第一歩です。
例: 新しい教授法は、期末試験のスコア向上につながるか?
ステップ 2: 何を測定しているかを特定する
研究におけるサンプルだけでなく、母集団全体(例:すべての学生)についての主張を行っていることを忘れないでください。鍵となるパラメータを定義します。
これは通常、母平均(μ)、2つの平均値の差(μ₁ - μ₂)、または相関(ρ)になります。
ステップ 3: 2つの仮説を書く
ここで、問いを正式な H0 と H1 に翻訳します。帰無仮説は常に「効果なし」を示します。対立仮説は、あなたが期待している具体的な効果を示します。
H0: μ_新教授法 = μ_旧教授法(平均スコアに差はない)
H1: μ_新教授法 > μ_旧教授法(新しい教授法の方が平均スコアが高い)
この構造化されたアプローチは、質的研究と量的研究を行う際に不可欠であり、データ収集が特定の主張の証明または反証に確実に集中するようにします。
現実世界の例:睡眠と成績
心理学者が、睡眠不足が学業成績を低下させるかどうかを知りたいと考えています。
H0: 睡眠不足の学生と十分な睡眠をとった学生の平均テストスコアは同じである。(μ_睡眠不足 = μ_睡眠十分)
H1: 睡眠不足の学生の方が平均テストスコアが低い。(μ_睡眠不足 < μ_睡眠十分)
このまったく同じ構造が、心理学、薬物治験、市場テストにおける研究のバックボーンとなっています。
<ProTip title="💡 プロのヒント:" description="解釈のバイアスを避けるため、データ収集を開始する前に仮説を立てましょう。" />
片側仮説と両側仮説
対立仮説は、効果があるかどうかだけでなく、どのような効果を求めているかについても定義します。この選択は、帰無仮説と対立仮説の設計において根本的な要素です。
片側検定(方向性あり)
これは、特定の1つの方向への変化を調べます。効果が一方向にしか進まないと信じる強い理由がある場合に使用します。
記号: H1: μ₁ > μ₂ または H1: μ₁ < μ₂
例: 肥料をテストしているとします。仮説は、それが植物の成長を促進するというものです(μ_肥料あり > μ_対照群)。成長を阻害するかどうかはテストしません。
使用するタイミング: 先行研究や理論によって、効果の方向性について明確な予測が立っている場合。
両側検定(方向性なし)
これは方向に関係なく、何らかの違いがあるかどうかを調べます。より保守的で、偏りのないアプローチです。
記号: H1: μ₁ ≠ μ₂
例: 2つの鎮痛剤を比較しているとします。一方が他方と異なる働きをするか(良くも悪くも)を知りたいだけです(μ_A ≠ μ_B)。
使用するタイミング: 新しい分野を探索している場合、またはどちらの方向への効果であっても意味がある場合。
簡単な比較
タイプ | H1 における記号 | 問いの内容 |
片側 | > または < | 「グループAは、グループBよりも具体的に大きい(または小さい)か?」 |
両側 | ≠ | 「グループAとグループBは互いに異なるか?」 |
データを見る前に、どちらが研究上の問いに適合するかを決定する必要があります。誤った方を選択すると、実際の発見を見逃したり、結果を完全に誤解したりする可能性があります。
仮説検定は実際にどのように機能するのか
このプロセスは、自分の考えが正しいと証明することではありません。データによって、最初の懐疑的な仮定(帰無仮説)が「あり得そうにない」ように見えるかどうかを確認することです。
基本的な論理
まず、帰無仮説(H0)が絶対的に正しいと仮定することから始めます。そして、「もし H0 が正しいとしたら、実際に収集したデータが得られるのはどのくらい驚くべきこと(稀なこと)だろうか?」と問いかけます。
その問いへの答えが p値 です。帰無仮説が正しいとした場合に、ランダムな偶然だけで、今回の結果(またはそれ以上に極端な結果)が得られる確率のことです。
p値が小さいということは、帰無仮説の下では今回のデータが非常に珍しい(起こりにくい)ものであることを意味します。p値が大きいということは、帰無仮説が正しい場合に十分予想されるデータであることを意味します。
ただし、解釈には注意が必要です。有意性検定に関して Nature に掲載された研究では、p値が誤解されがちであることが強調されています。p値は仮説が「真」である確率を示すのではなく、データが帰無仮説とどの程度適合しているかを示すものです。
意思決定ルール
「驚くべき(稀な)基準」を決めるためのカットオフポイントが必要です。これが有意水準アルファ(α)であり、一般的には 0.05(5%)に設定されます。
p値 ≤ α(例:≤ 0.05)の場合: データは H0 の下では起こりそうにないと見なされます。このとき、帰無仮説を棄却します。
p値 > α(例:> 0.05)の場合: データは H0 を捨てるほど珍しいものではありません。このとき、帰無仮説を棄却できません(保留します)。
言ってはいけないこと
これは極めて重要な区別です。H0 を棄却したからといって、対立仮説(H1)が正しいと「証明」したわけではありません。証拠が帰無仮説に深刻な疑問を投げかけるのに十分なほど強力であったことを意味するに過ぎません。
裁判の判決のように考えてください。「有罪」の判決は、絶対に有罪であることを証明するものではありません。無罪の推定を覆す(棄却する)のに十分な証拠があったことを意味します。同様に、H0 を「受容(採択)」したり、H1 を「証明」したりすることはありません。H0 を棄却するのに十分な証拠が見つかったか、あるいは見つからなかったか、のどちらかだけです。
<ProTip title="💡 プロのヒント:" description="学術的な執筆では、「帰無仮説を採択する」ではなく「帰無仮説を棄却できない」と表現しましょう。" />
仮説検定におけるよくある間違い
仮説検定には、いくつかの典型的な落とし穴があります。これらを知っておくことで、データから誤った結論を導き出すのを避けることができます。
間違い 1: サンプルについて記述してしまう
仮説は、研究しているグループ全体、つまり「母集団」に関する主張です。データはそこから得られた単なる「サンプル(標本)」に過ぎません。
誤り: 「グループAのサンプル平均は、グループBよりも大きい。」
正しい: 「グループAの母平均(μ)は、グループBよりも大きい。」
間違い 2: 帰無仮説を「受け入れる(採択する)」と言ってしまう
帰無仮説を受け入れる(採択する)ことは決してありません。検定は、それを捨てるための十分な証拠があるかどうかを示すだけです。少々回りくどい表現ですが、正しい表現は「帰無仮説を棄却できない」です。
この表現は、データが単に仮説を覆すほど強力ではなかったことを正しく含意しており、帰無仮説が真であることを証明するものではありません。
間違い 3: 2つのエラータイプを忘れてしまう
あらゆる統計的決定には、誤りのリスクが伴います。それが何であるかを知る必要があります。
第一種の誤り(偽陽性): 実際には真である帰無仮説を棄却してしまうこと。(実際には存在しない効果があると思い込んでしまう。)
第二種の誤り(偽陰性): 実際には偽である帰無仮説を棄却できないこと。(実際の効果を見逃してしまう。)
有意水準(0.05などのα)は、第一種の誤りを犯す確率に直接対応しています。
間違い 4: 「p < 0.05」を魔法のように扱う
結果が「統計的に有意」(p < 0.05)であっても、現実世界ではまったく些細なことである場合があります。サンプルサイズが膨大であれば、極めて小さく無意味な差異であっても検出できてしまいます。
逆に、サンプルサイズが小さすぎると、重要な発見であっても p < 0.05 に達しないことがあります。p値は信頼性について教えてくれますが、効果の大きさや重要性については教えてくれません。
仮説検定の現実世界の例
この枠組みは教科書の中だけのものではありません。多くの分野でデータに基づいた意思決定を行うための標準的な方法です。
ビジネス: ウェブサイトの A/B テスト
ECサイトのチームが、新しくデザインした「今すぐ購入」ボタンの方が効果があるかどうかを検証しています。
H0: 新しいボタンのクリック率は、古いボタンと同じである。
H1: 新しいボタンの方がクリック率が高い。彼らはテストを実行し、トラフィックを分割してデータを収集します。結果が H0 と強く矛盾する場合(低いp値)、新しいデザインを全社的に導入します。そうでなければ、オリジナルのデザインを維持します。
医学: 臨床試験
新薬が承認されるには、管理された試験においてプラセボ(偽薬)を上回る効果を示す必要があります。
H0: その薬は砂糖の錠剤(プラセボ)と同等の効果しかない。
H1: その薬はプラセボよりも効果がある。ここで帰無仮説を棄却することは、単なる学術的なことではなく、規制当局による承認や、医師による病気の治療法の変革に向けた重要なステップとなります。
教育: 新しいカリキュラムの評価
ある学区が、半数の教室で新しい算数プログラムを試験的に導入します。
H0: 生徒の習熟度は、新しいプログラムと古いプログラムで同じである。
H1: 生徒の習熟度は、新しいプログラムの方が高い。この検定から得られる統計的結論は、来年何を教えるべきかという、極めて重大(かつ高額な費用が伴う)意思決定に直接反映されます。
帰無仮説の誤用が危険である理由
この統計ツールを誤用することは、単に質の低い科学につながるだけでなく、資金の無駄遣いから公衆衛生への害に至るまで、現実世界に深刻な結果をもたらす可能性があります。
pハッキング(p-hacking)の問題
研究者が20の異なる成果を測定したと仮定します。もし有意水準 0.05 で20の別々の検定を実行した場合、実際には何も起きていなくても、純粋な偶然だけで、そのうちの1つが「有意な」結果を示す可能性があります。
この手法は「pハッキング」と呼ばれ、誤った発見を生み出します。小規模な探索的研究から得られた知見が、より大規模で慎重な試験において再現されないことが多いのは、これが原因です。
よくある誤解
多くの人が、結果から誤った結論を導き出します。
「H0 を棄却できなかった。だから効果はない。」 これは誤りです。有意でない結果は、単に研究の検出力が効果を検出するのに十分でなかったことを意味する場合が多いためです。これは「不在の証拠」であり、「証拠がないこと」を証明するものではありません。
サンプルサイズの役割を無視する。 小規模な研究では、大きな効果が見られても統計的に有意に達しないことがあります。大規模な研究では、極めて小さな効果であっても統計的に有意になることがあります。p値は、効果の実際の大きさと並べて考慮する必要があります。
帰無仮説そのものが非現実的な場合
多くの分野、特に社会科学や生物学においては、効果が「絶対的にゼロである」という考え自体が統計的なフィクションである場合があります。ほぼ常に、何らかの極めて小さな違いや相関が存在するからです。
あり得そうにない「効果なし」という帰無仮説を検証することは、発見が意味のあるものか有用なものかを無視して、不必要な統計的有意性の追求につながる可能性があります。焦点が「これは重要か?」から、単に「p < 0.05 にできるか?」に移ってしまうおそれがあります。
<ProTip title="💡 プロのヒント:" description="より良い意思決定のために、統計的有意性と実用的な有意性を組み合わせて考えましょう。" />
仮説検定のための明確な道筋
仮説検定は混乱しがちです。以下の構成に従うことで、一貫性のある論理的な分析を維持することができます。
ステップに従う
正確な研究上の問いから始めましょう。実際に何を明らかにしようとしていますか?
平均値や比率など、関心のある母集団パラメータを把握しましょう。
帰無仮説(H0)を設定しましょう。これは常に等価、または「効果なし」の状態を示すべきです。
対立仮説(H1)を設定しましょう。これは期待される変化の方向、または違いを示します。
検定のタイプを決定しましょう。片側検定(特定の方向への変化を調べる)ですか、それとも両側検定(あらゆる違いを調べる)ですか?
データを収集し、計算を行って検定統計量を算出しましょう。
p値の解釈には注意を払いましょう。それが H0 に反対する証拠について、実際に何を物語っているかを理解してください。
この順序に従うことで、仮説を混同したり、検定を誤って適用したりするのを防ぐことができます。曖昧な概念が、明確な手順へと変わるでしょう。
仮説検定を完全に理解する
どちらの仮説が何を示すのか、何度も迷ってしまうことがあるかもしれません。応用しようとすると、その論理がうまく定着しないことがあります。用語が似ていて、意味が抜け落ちてしまうと、すぐに混乱してしまいます。
<CTA title="研究上の問いを明確な仮説に変える" description="構造化された執筆とガイド付きの仮説作成により、強固な統計的推論を構築しましょう。" buttonLabel="Jenni を無料で試す" link="https://app.jenni.ai/register" />
仮説検定とは、記号を暗記することではなく、論理的な枠組みを理解することです。明確な研究上の問いから始め、帰無仮説を「効果なし」として書き、それを棄却するのに十分な証拠があるかどうかをデータに語らせましょう。この意識の変化が、統計的推論を曖昧なものではなく、確かなものにしてくれます。