
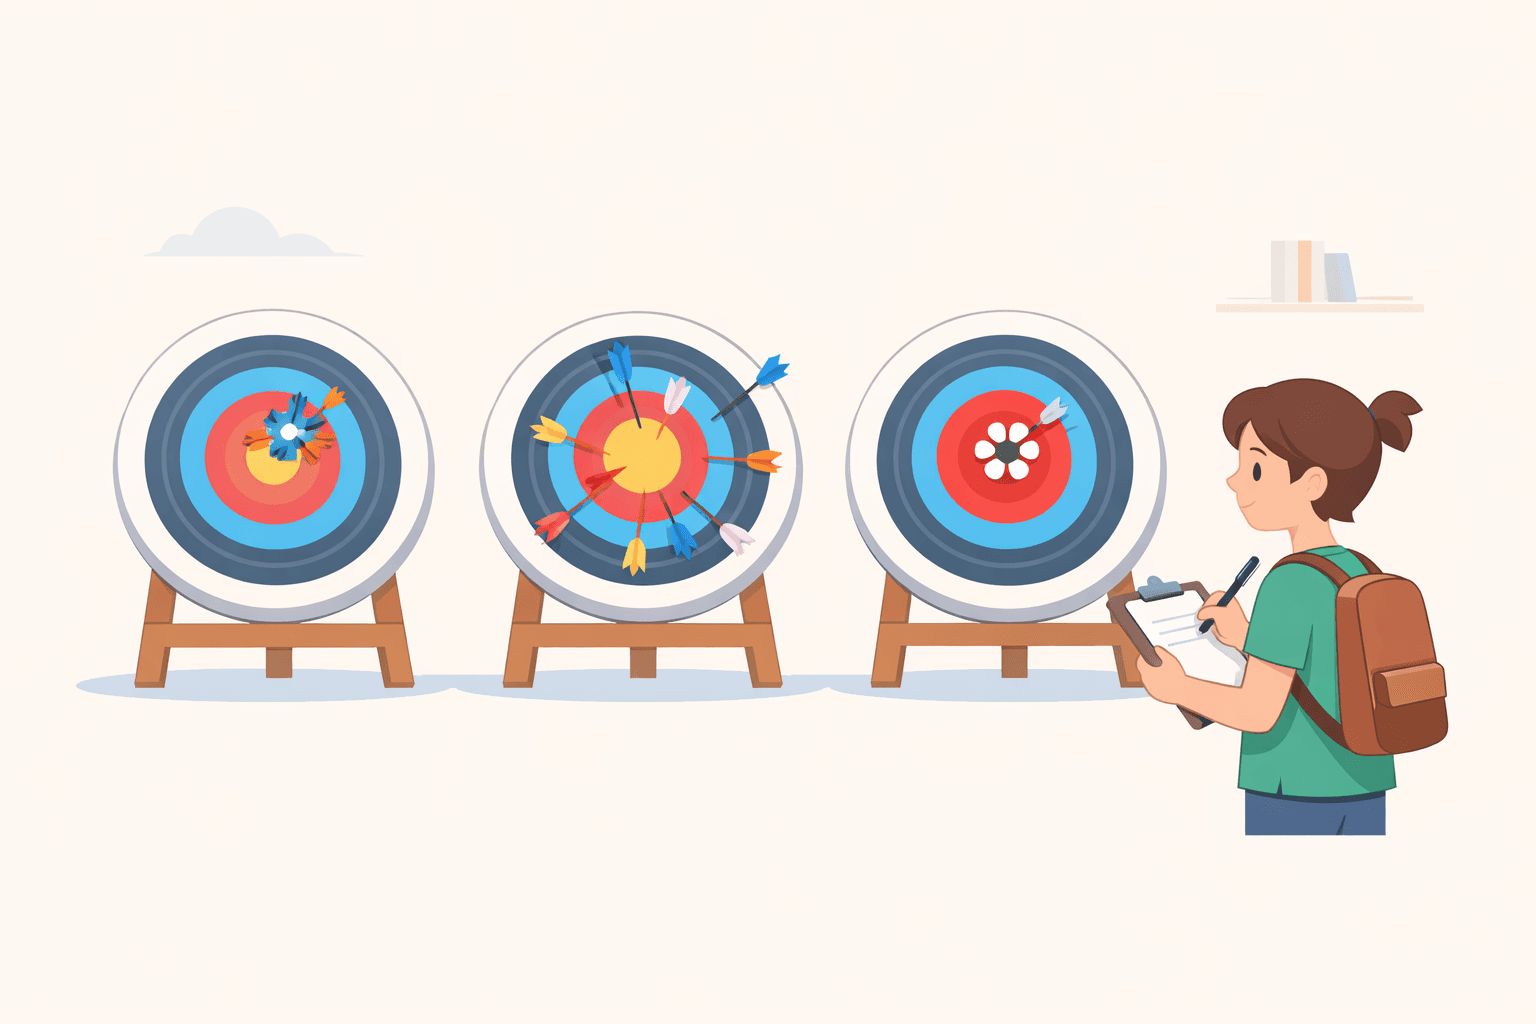
妥当性(Validity)とは、あなたの研究が実際に測定しようとしているものを測定できているかを問うものです。信頼性(Reliability)とは、同じ研究をもう一度行った場合に、同じ結果が得られるかどうかを確認するものです。ずさんな設計や曖昧な測定ツールは、プロジェクトにどれほど多額の資金が投入されていようとも、この両方を台無しにしてしまいます。
このガイドでは、それを修正するための具体的な手順を説明します。測定をよりシャープにし、研究設計を厳密にし、典型的なデータ問題を解決する方法を、分かりやすい例を用いて紹介します。実用的な解決策を見つけるために、読み進めてください。
<CTA title="研究設計を強化する" description="混乱することなく、構造化され、明確で、裏付けのある研究フレームワークを数分で作成できます。" buttonLabel="Jenniを無料で試す" link="https://app.jenni.ai/register" />
ステップ1:概念を正確に定義し、測定する
何かを研究する前に、見ている対象を定義する必要があります。曖昧なアイデアは、不安定な結果につながります。
「ストレス」や「学習」のような広範な概念を例に挙げてみましょう。これらを直接測定することはできません。実際にカウントしたりスコアリングしたりできるものに変換する必要があります。これを変数の操作化(operationalizing)と呼びます。
ストレスは、血液サンプルで測定されたコルチゾール値や、リッカート尺度を用いたアンケートのスコアに置き換えることができます。
学習は、テストのスコアや、特定のタスクのパフォーマンスの高さによって定義されるかもしれません。
この理論から測定への変換が、構成概念妥当性(construct validity)における最初にして最も重要なステップです。これにより、数値が実際にあなたのアイデアを反映しているかどうかが確認されます。
すでに優れた測定スケールが存在する場合、独自の測定尺度は作成しないでください。検証済みのツールを使用することで、エラーを減らし、研究の信頼性を高めることができます。
このようなツールには通常、一般的な基準である0.7以上のクロンバックのアルファ値など、内的一貫性の信頼性に関する独自のスコアが付属しています。
アメリカ国立衛生研究所(NIH)は、確立され検証されたツールを使用することで、研究における測定精度が大幅に向上すると指摘しています。
優れた測定ツールには、通常、以下に関するドキュメントが含まれています。
その内容妥当性がどのように確立されたか(概念のすべての部分をカバーしているか)。
基準関連妥当性の証拠(既知のゴールドスタンダードと一致しているか)。
過去の使用における信頼性スコア。
また、さまざまな種類の妥当性を確認する必要もあります。これらは互いに置き換えることはできず、それぞれがパズルの異なるピースをテストします。
内容妥当性(Content validity): 測定方法に、概念の重要な側面がすべて含まれているか。
構成概念妥当性(Construct validity): 測定方法が、理論が示す通りの挙動を示しているか。
基準関連妥当性(Criterion validity): 測定方法が、同じものを測定する別の信頼できる測定方法と強く相関しているか。
これら3つのすべてを検討することで、調査結果が一貫して間違っているだけでなく、意味のあるものであることを確認できます。
<ProTip title="💡 プロのヒント:" description="検証済みの尺度を使用して測定誤差を減らし、信頼性を迅速に向上させます。" />
ステップ2:研究設計の強化とバイアスの制御
研究の設計は、その骨組みです。脆弱な設計はすべてを崩壊させます。
まず、設計が問いかけている疑問に本当に合致しているか確認してください。AがBの原因であるかを知りたい場合は、実験が必要です。アンケート調査ではその答えは得られません。
適切な手法を用いることで、研究の内性的妥当性が強化され、統計的な調査結果の解釈が容易になります。
また、交絡変数を制御する必要もあります。臨床試験では、バイアスを減らすために、ランダム割り付けや二重盲検法などの標準的な技術が特に使用されます。
世界保健機関(WHO)は、より優れた準実験的アプローチと対照設計が信頼性を大幅に高めると指摘しています。
次に、すべてを標準化します。すべての参加者に全く同じ指示を与えてください。同じ環境でテストを実行します。タイミングを一貫させます。
これにより、データ内のランダムでノイズの多いエラーが減少し、測定の信頼性をサポートする簡単な方法となります。質問の表現がわずかに異なるといった小さな不一致は、データセット全体の信頼性を静かに低下させる可能性があります。
最後に、パイロットテストを省略しないでください。本調査に進む前に、10〜20人程度の少人数のグループで全手順を実行します。このリハーサルは、不明瞭な質問の特定、気まずいタイミングの修正、および低い信頼性の早期の兆候を捉えるのに役立ちます。
これは、本格的なプロジェクトに時間とリソースを投資する前に、妥当性と信頼性の両方を向上させる、最も迅速で実用的な方法の一つです。
<ProTip title="⚠️ 注意事項:" description="手順における小さな不一致は、データセット全体の信頼性を静かに低下させる可能性があります。" />
ステップ3:サンプリングと一般化可能性の向上
誰を研究するかは、どのように研究するかと同じくらい重要です。サンプリング方法によって、調査結果が特定のグループ以外の誰かに適用できるかどうかが決まります。
一般化可能性を高めるために、可能な限り確率比例サンプリングを使用してください。これは、ターゲット人口の全員が選ばれる確率が分かっていることを意味し、サンプルをより代表的なものにし、バイアスを減らします。ここでの一般的な方法は以下の通りです。
単純無作為抽出(ランダムサンプリング)
層化抽出(層化サンプリング)
多段抽出(クラスターサンプリング)
サンプルサイズが大きいことは役立ちますが、万能薬ではありません。測定ツールに欠陥がある場合、サンプルサイズを大きくすると、その欠陥がより安定し、際立つだけです。サンプリングの限界については常に率直に述べてください。
信頼性と妥当性の本質的な違いを理解することは、土台が脆弱な場合、サンプルサイズが大きくなるにつれてバイアスも拡大することを認識するのに役立ちます。
これが、単に大きなN(サンプル数)を追い求めることよりも、測定精度を修正することが重要である理由です。サンプリングの限界については常に率直に述べてください。
誰が含まれ(誰が除外されたか)、どのように人々を募ったか、どのようなバイアスが存在する可能性があるかを誠実に報告することは、実際に研究の信頼性を高めます。設計に実質的な制約がある場合でも、信頼関係を築くことができます。
ステップ4:一貫性による信頼性の向上
信頼性とは一貫性に関するものです。もう一度測定した場合、あるいは別の人が測定した場合に、同じ結果を得ることができますか?
データを収集またはコーディングする人がいる場合、適切なトレーニングが必要です。一貫性のない観察者は、不要なノイズを追加します。
トレーニングセッションやキャリブレーション(調整)の演習は、評価者間信頼性(異なる人々の一致度)と評価者内信頼性(1人の人の時間経過に伴う一貫性)の両方を向上させるために使用されます。
これは、コヘンのカッパやクラス内相関などの統計値で正式に測定できます。アンケートの設計は極めて重要です。質の悪い質問は、妥当性と信頼性の両方を台無しにします。
特定の回答を誘導するような誘導質問は避けてください。
一度に2つのことを尋ねるダブルバーレル質問(例:「このソフトウェアは便利で使いやすいですか?」)は避けてください。
異なる解釈ができるような曖昧な表現は避けてください。
代わりに、明確で中立的な表現に焦点を当ててください。
最後に、単一の測定に依存しないでください。複数のチェックを使用します。量的研究では、テスト・再テスト法を利用します。質的研究では、インタビュー、観察、文書分析を組み合わせた三角測量(トライアンギュレーション)を使用し、結論が維持されるか確認します。
研究におけるさまざまな信頼性のタイプを確認することは、データに適したチェック方法を選択するのに役立ちます。
量的研究では、複数項目の尺度およびテスト・再テスト信頼性(同じ人を2回測定する)を使用します。
質的研究では、三角測量(トライアンギュレーション)を使用します。インタビュー、観察、文書分析を組み合わせて、結論が異なる情報源全体で維持されるか確認します。
<ProTip title="💡 プロのヒント:" description="三角測量は、手法や情報源を超えて結果を確認することにより、調査結果を強化します。" />
ステップ5:質的妥当性と信頼性の強化
質的研究の目標は、単なる数値的な一貫性ではなく、信頼性と深みです。そのため、戦術が異なります。
強力な手法の一つがメンバーチェッキング(メンバーによる確認)です。データを分析した後、参加者のところに戻り、解釈を確認してもらいます。
あなたの要約は彼らの体験と一致していますか?このステップは現実世界のチェックとして機能し、調査結果の信憑性を高めます。
また、研究プロセス中に行われたすべての決定のログである、詳細な監査証跡(オーディットトレイル)を残す必要があります。
これは信頼性をサポートします。さらに、質的研究と量的研究のニュアンスの違いを理解することで、アプローチを明確に区別します。例えば、質的研究は、自分自身のバイアスを能動的に認識する省察性(リフレクシビティ)に大きく依存します。
それには、データのコーディング方法に関するメモ、収集中の観察、研究者としての自身の内省を含める必要があります。
このドキュメントは研究の信頼性を支え、結論に至ったプロセスを示します。
重要なプラクティスは、三角測量と省察性を組み合わせることです。省察性とは、研究者としての自身のバイアスや視点を能動的に認識することを意味します。
次に、この自己認識と三角測量を組み合わせ、複数の方法(インタビューや観察など)を使用するか、異なる情報源からデータを収集します。
これらのプラクティスを合わせることで、研究の確証性が強化され、結論がより強固になります。
<ProTip title="🧠 インサイト:" description="省察性は、質的分析において解釈とバイアスを区別するのに役立ちます。" />
ステップ6:統計的および分析的セーフガードの使用
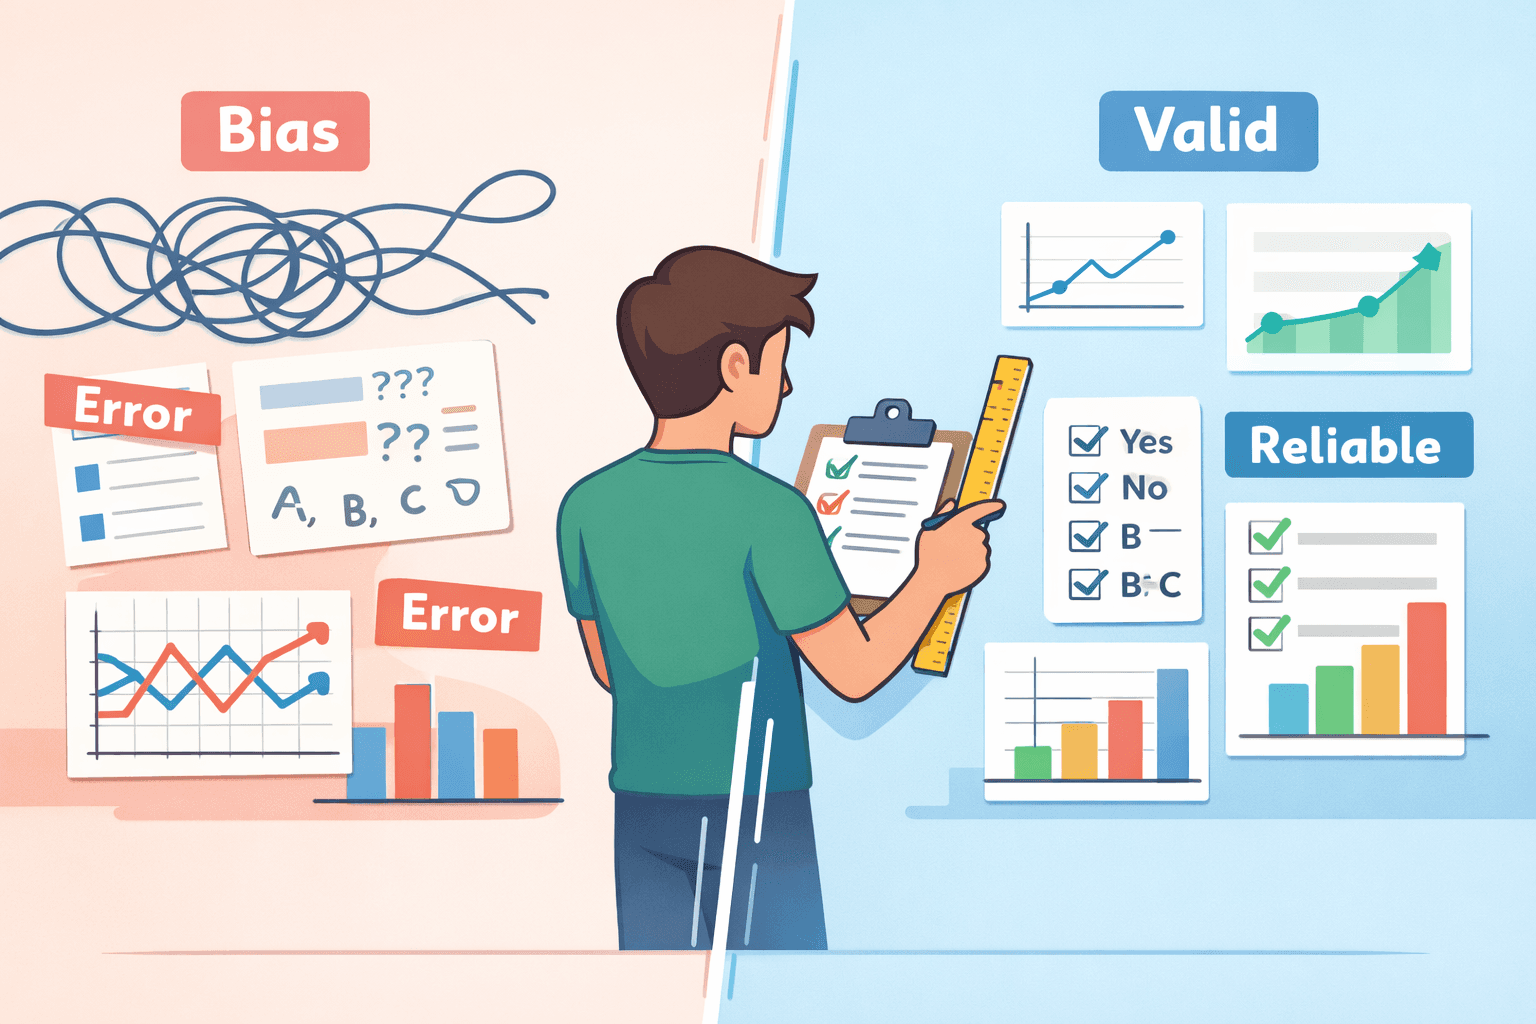
統計分析は、単に結果を見つけるためのものではありません。データの完全性をチェックするためのものです。
まず、特定のテストで信頼性を評価します。一般的な方法は以下の通りです。
クロンバックのアルファ(尺度の内的一貫性用)
折半法信頼性(スプリットハーフ信頼性)
等価形式信頼性(平行形式信頼性)
0.7を超えるクロンバックのアルファスコアは、絶対的なものではありませんが、許容可能な信頼性の一般的な基準です。
次に、頑健性(ロバストネス)と感度のチェックを実行します。条件を変更しても、核心となる調査結果が維持されるか確認してください。
外れ値を除外したり、モデルの仮定を調整したり、まったく異なる分析手法を使用したりしてみてください。結果が安定している場合、それは高い信頼性を示す良い兆候です。
最後に、分析的セーフガードが理論的枠組みと一致するように、分析を確立された研究パラダイムに合わせてください。
統計的チェックで信頼性が低いことが示された場合、それらの調査結果は予備的なものとして扱ってください。弱いデータから強力で決定的な結論を導き出すことは避けてください。
弱いデータから強力で決定的な結論を導き出すことは避けてください。これにより、信頼性が保護され、研究全体の再現性がサポートされます。
クイック比較:妥当性 vs 信頼性
違いを理解することは、戦略的に両方を向上させるのに役立ちます。
側面 | 妥当性 | 信頼性 |
定義 | 正確性を測定します。正しいものを測定していますか? | 一貫性を測定します。もう一度同じ結果を得ることができますか? |
焦点 | 結果の正確さ。 | 結果の安定性。 |
例 | テストは実際に知能を測定していますか、それとも単にテストのテクニックを測定していますか? | 同じ人を2回測定した場合、ほぼ同じスコアが得られますか? |
主な方法 | 構成概念妥当性の検証、三角測量。 | テスト・再テスト、クロンバックのアルファ。 |
リスク | 誤った概念を測定すること。 | 一貫性のない結果が得られること。 |
両方が必要です。信頼できるが無効なデータは、一貫して間違っています。妥当であるが信頼性の低いデータは、信用できません。
妥当性と信頼性を損なうよくある間違い
研究者はしばしば同じ落とし穴に陥り、研究を弱め、査読コメントで定期的に指摘されます。
以下によくある間違いを挙げます。
測定の質ではなく、サンプルサイズに過度に依存すること。 欠陥のある測定方法では、欠陥が統計的に安定するだけであるにもかかわらず、サンプルサイズ(N)が大きいほどすべてが解決すると考えること。
クロンバックのアルファを上げるためだけに項目を削除すること。 尺度の内容妥当性を実際に損なっていないか確認せずに、0.7という魔法の数字に達するようにアンケートを微調整すること。
バイアスを認識せずに便宜的サンプルを使用すること。 連絡しやすい人々だけを研究対象とし、それが調査結果の適用範囲をどのように制限するかを明確に述べないこと。
パイロットテストを省略すること。 試行運転を省略すると、事前にテストを行わなかったために、不良データや混乱を招くデータを収集するリスクが生じます。
交絡変数を無視すること。 結果を説明し得る他の要因を制御するように研究を設計しないため、議論に大きな穴を残すこと。
<ProTip title="⚠️ 警告:" description="盲目的に項目を削除して信頼性を修正すると、構成概念妥当性が低下する可能性があります。" />
精査に耐えうる研究にする
結果がうまく一致しなかったり、査読で不安定に感じられたりするときの不満はよく分かります。それはすべてを遅らせ、自分の仕事を疑う原因になります。定義やプロセスの小さなギャップが、成果全体を狂わせることがあります。それが問題です。
<CTA title="査読に耐えうる研究を設計する" description="研究のアイデアを、構造化され、信頼性が高く、妥当なフレームワークに迅速に変換します。" buttonLabel="Jenniを無料で試す" link="https://app.jenni.ai/register" />
Jenniを使用すると、最初から最後まで、すべてを緊密かつ追跡しやすい状態に保つことができます。これにより、仕事の定義、構造化、文書化の方法がサポートされ、結果の一貫性と明確さが維持されます。これは、面倒な修正を避け、提示するものに自信を持つためのシンプルな方法です。