によって
ジャスティン・ウォン
—
ANOVA(一元配置分散分析)と多重比較(ポストホック)検定:分かりやすいステップバイステップガイド

3つ以上のグループの平均値を比較するには、分散分析(ANOVA)と事後検定(ポストホック検定)が不可欠です。代わりにt検定を繰り返すと、偽陽性率が上昇し、研究結果の信頼性が損なわれてしまいます。
このガイドでは、分散の基本から適切な事後検定の選択まで、一連のワークフローを網羅しています。自信を持ってANOVAの結果を実行、解釈、報告できるようになります。
<CTA title="データを明確に分析する" description="ガイド付きプロンプトにより、統計ワークフローを構造化し、結果をより迅速に解釈できます。" buttonLabel="Jenniを無料で試す" link="https://app.jenni.ai/register" />
ANOVAが実際にテストしていること
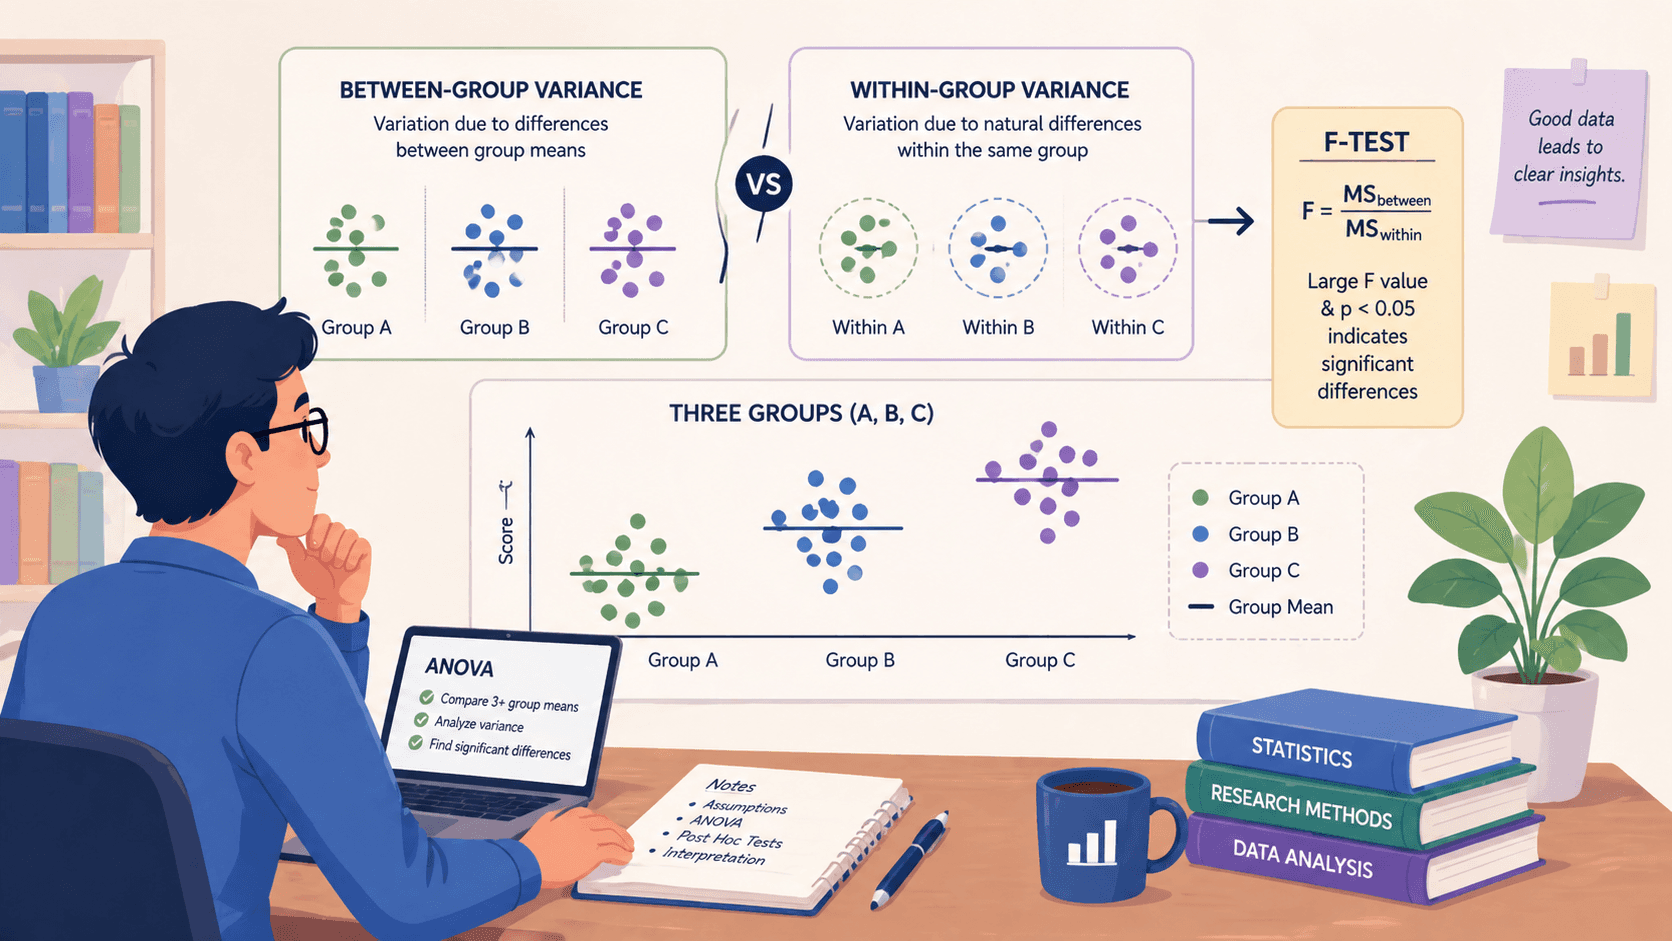
分散分析(ANOVA)は、3つ以上のグループの平均値が本当に異なるかどうかを検証します。これは、2種類のばらつき(分散)を比較することによって行われます。
これらの統計的構造の基礎的な理解を得るために、データグループがどのように相互作用するかを視覚化する上で、ANOVAの究極ガイドが役立つでしょう。
データ全体のばらつきは、次の2つに分解されます。
群間分散(グループ間のばらつき): 与えた処理や条件によって生じたと考えられる違い。
群内分散(グループ内のばらつき): 同一グループ内の個人間における自然でランダムな違い(本質的にはバックグラウンドノイズ)。
主要な計算結果はF値です。これは単純に「群間分散」を「群内分散」で割ったものです。F値が大きく、p値が一般的に0.05未満であれば、グループ間の差が偶然だけで片付けられないほど大きいことを意味します。
ロジックを分解する
簡単な例えとして、異なる教室のテストの点数を比較してみましょう。すべてのクラスの平均点が似ていれば、クラス間のばらつきは小さくなります。しかし、1つのクラスだけが一貫して非常に高い点数を取っている場合、クラス間のばらつきは急上昇します。
ANOVAはその効果を定量化します。この客観的なアプローチは、数値データを用いて仮説を証明または反証する質的研究と量的研究の大きな特徴です。
ANOVA表の主要構成要素
標準的なANOVAの出力結果には、以下の要素が含まれています。
平方和(SS): 二乗されたばらつきの総和。
自由度(df): 独立した情報の数。
平均平方(MS): 平均的なばらつき(SS/df)。
F値: 有意性検定に用いられる最終的な比率(群間MS / 群内MS)。
それぞれの項目は、確認された違いが意味のあるものなのか、それとも単なるランダムなノイズなのかを判断するのに役立ちます。
<ProTip title="💡 プロのヒント:" description="解釈をより強固なものにするために、p値と併せてエータ二乗(η²)などの効果量を常に報告しましょう。" />
ステップ 1:まずANOVAの前提条件を確認する
前提条件を確認せずに分散分析を実行してはいけません。このステップをスキップすると、簡単に誤った結果を導き出すことになります。
3つの主要な前提条件
ANOVAは、以下の3つの条件が合理的に満たされていることに依存しています。
正規性: データがおおむね正規分布に従っていること。
等分散性: 各グループのデータのばらつき(分散)が同様であること。
独立性: 各観測値が他の観測値と無関係であること。
これらは単なる形式的な手続きではなく、偏った結論や誤った結論を導き出すのを防ぐためのものです。
実際のテスト方法
正規性については、残差のQ-Qプロットを確認するか、シャピロ・ウィルク検定(Shapiro-Wilk test)を実行します。
等分散性については、ルベーヌ検定(Levene's test)が最も一般的な確認方法です。
独立性は統計的に検定するものではなく、調査設計の特徴です。ある観測値が別の観測値と関連するような方法でデータが収集されていないか確認してください。
これが、効果的なリサーチクエスチョンの書き方を学ぶことが不可欠である理由です。これにより、実験の構成が最初から論理的に健全であることが保証されます。
前提条件を満たさなかった場合は?
データがこれらのルールを満たさない場合は、別の検定を行う必要があります。
等分散でない場合は、ウェルチ(Welch)およびブラウン・フォーサイス(Brown-Forsythe)の一元配置分散分析を検討する必要があります。
データが正規分布に従わない場合は、非パラメトリック検定である クラスカル・ウォリス検定(Kruskal-Wallis test) が適した代替案となります。
独立性が満たされない反復測定の場合は、 フリードマン検定(Friedman test) を検討してください。
これらのチェックを無視することはよくある間違いです。例えば、アメリカ国立衛生研究所(NIH)のレビューによると、生物医学研究において分散分析の前提条件に違反すると、報告される有意水準が深刻に歪む可能性があることが指摘されています。
<ProTip title="📊 リマインダー:" description="サンプルサイズが小さいと、ANOVAで有意差が出た後でも事後検定で検出力が低下することがよくあります。" />
ステップ 2:分散分析(ANOVA)を実行する
分散分析を実行するとは、データの全分散を各要素に分解し、それらをF値と比較することを意味します。
このプロセスは、経験的証拠と客観的な測定を優先する特定の研究パラダイムに深く根ざしています。
一元配置分散分析(One-Way ANOVA)の例
3つの異なる教授法による学生のテストの点数を比較していると仮定します。分析を実行すると、ソフトウェアから以下のような結果が出力されます: F(3, 56) = 17.66, p < .001
これは、教授法のグループ間のばらつきが、グループ内のランダムなばらつきよりもはるかに大きいことを示しています。p値が0.001未満であることは、統計的に有意な差があることを意味し、少なくとも1つのグループの平均点が他と異なることを示しています。
二元配置分散分析(Two-Way ANOVA)と相互作用
二元配置分散分析では、2つの要因を同時に検証できます。例えば、教授法と学生の性別の両方を見ることができます。ここでは、以下の2点を確認します。
主効果: 教授法そのものが点数に影響を与えているか? 性別そのものが点数に影響を与えているか?
相互作用効果: 教授法の効果は性別によって異なるか?(例えば、ある方法が特定の性別に対してより効果的であるなど)
対応のある(バランス)デザイン vs. 対応のない(アンバランス)デザイン
これはサンプルサイズに関する話です。
バランスデザインは、すべてのグループで観測値の数が同じです(例:各教授法にそれぞれ20人の学生)。
アンバランスデザインは、グループのサイズが不均等です。
バランスデザインはよりシンプルで堅牢であり、より明確な結果をもたらします。アンバランスデザインは数学的計算を複雑にし、検定の感度(統計的検出力)を低下させ、場合によっては相互作用の特定を困難にすることがあります。
ビジネスや研究において信頼できる結論を得るには、バランスの取れたセットアップが望ましいです。実験計画に関するハーバード・ビジネス・レビューの記事では、バランスの取れたグループ構成は解釈しやすい比較につながり、バイアスを最小限に抑えるのに役立つと指摘されています。
ステップ 3:なぜ事後検定(Post Hoc)が必要なのかを理解する
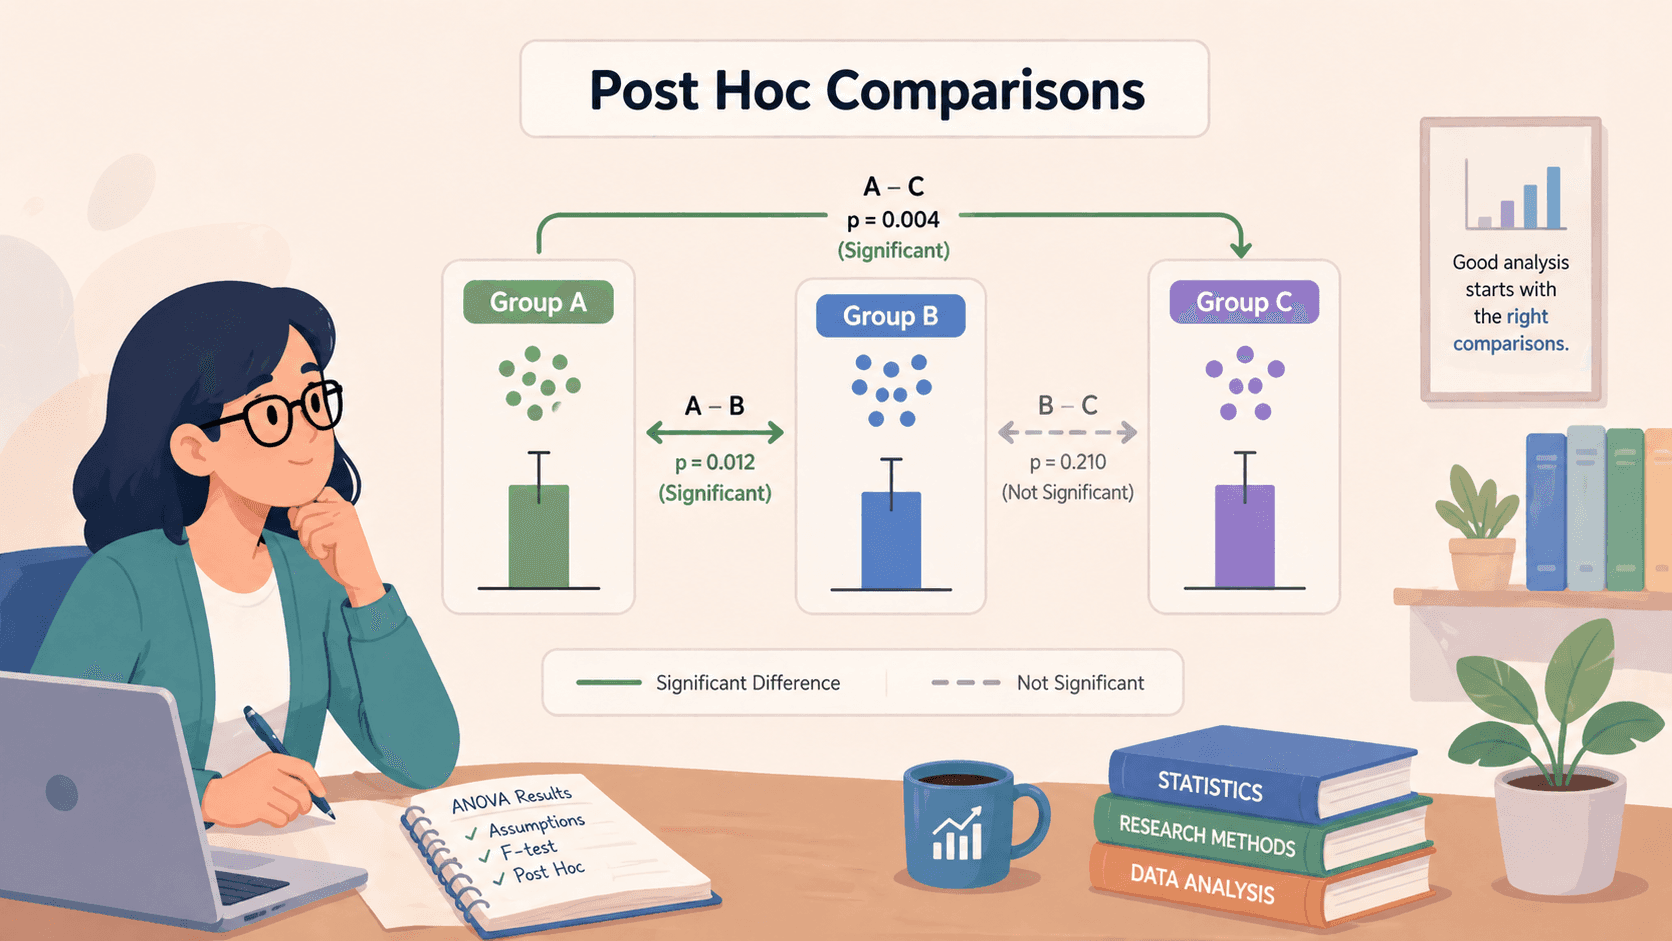
ANOVAで有意な結果が得られても、すべてのグループの平均値が同一ではないということしか分かりません。具体的にどのグループ間に差があるのかまでは分かりません。それを突き止めるには、考えられるすべてのグループのペア間で比較を行う必要があります。
これによって統計的な問題が生じます。各ペアに対して通常のt検定を繰り返すだけでは、実際には差がないのに差があると判断してしまう「偽陽性」の確率が劇的に高まります。これは「第一種の過誤の膨張」と呼ばれます。
事後検定はこれを解決するために存在します。すべてのペアごとの比較を行いつつ、実験全体の総合的なエラー率を選択した有意水準(通常は0.05)に維持するために、個々の検定の有意水準を調整してくれます。
事後検定が実際に行っていること
すべてのグループと他のすべてのグループを比較する
全体のエラー率を一定に保つために補正を適用する
信頼できる調整済みp値を提供する
どの差が統計的に意味のあるものかを解釈しやすくする
実質的に、事後検定はリスクを高めることなく、ANOVAの結果をより深く探ることを可能にします。安全対策を組み込んだ上で、詳細な比較を行うことができます。
研究におけるよくある悩み
分散分析全体では有意な結果が得られたのに、その後の事後検定で有意なペア間の差が見つからないということは、非常によくあることであり、完全に正常な現象です。これは間違いや矛盾ではありません。通常、研究の統計的検出力が限られていたことを意味します。
多くの場合、以下の原因が考えられます。
限られた統計的検出力: サンプルサイズが小さすぎて、ペアごとの差を検出できない
小さな効果量: グループ間の差は存在するものの、非常にわずかである
グループ内の高い変動性(ばらつき): データ内のノイズにより、明確な違いを分離するのが難しい
したがって、グループ全体の変動は検出できるほど強力である一方、個別の比較においては補正を適用すると閾値を超えなくなってしまいます。
これは、ANOVAと事後検定が、わずかに異なる問いに答えていることを思い出させてくれます。一方は「何かが起きているか」を教えてくれ、もう一方は「正確にどこで起きているか」を教えてくれますが、時にはデータをきれいに特定できるほど強力ではないこともあります。
<ProTip title="⚠️ 警告:" description="分散分析(ANOVA)の後に、補正方法を適用せずに複数のt検定を実行しないでください。" />
ステップ 4:適切な事後検定を選択する
正しい事後検定を選択することは重要です。これらの調整の背後にある具体的な数学的詳細を深く掘り下げるには、分散分析の事後検定に関するこの詳細なリソースを探索してください。
一般的な事後検定の比較
検定方法 | 最適なユースケース | 保守性 | 主な特徴 |
Tukey HSD | 考えられるすべてのグループ平均のペアを比較する場合。 | 中程度 | すべてのペア比較において、ファミリーワイズエラー率を制御します。 |
Bonferroni | 事前計画された数少ない比較のみを行う場合。 | 非常に高い | シンプルな方法:有意水準(例:0.05)を検定の数で割ります。 |
Dunnett | 複数の処理グループを単一の対照群(コントロール)と比較する場合。 | 中程度 | この特定の目的に対しては、Tukeyよりも強力です。 |
Scheffé | 複雑で計画されていない対比(例:2つのグループの平均と3つ目のグループの比較)を検証する場合。 | 極めて高い | 非常に柔軟ですが、非常に保守的でもあるため、検出力が低下します。 |
実務におけるTukey HSD
テューキーのHonestly Significant Difference(HSD)は、ほとんどの状況、特にバランスデザイン(均等なサンプルサイズ)の場合にデフォルトで選択される手法です。
実際の差を検出するための合理的な統計的検出力を維持しながら、全体的なエラー率を効果的に制御します。
シンプルなBonferroni
ボンフェローニ補正は理解しやすく、適用するのも簡単です。希望する有意水準を、行う比較の数で割るだけです。
大きな欠点としては、グループ数が多くなると厳格になりすぎてしまい、有意な結果を見つけるのが非常に困難になる点です。
Games-Howellはいつ使うべきか?
ルベーヌ検定でグループ間の等分散性が否定された場合は、TukeyやBonferroniを使用してはいけません。代わりに Games-Howell 検定を使用してください。
これは等分散を仮定せず、このような状況においても堅牢で信頼できるペア比較を提供し、誤った結論を防ぎます。
<ProTip title="🧠 メモ:" description="分散分析の設計とデータの条件に合わせて、事後検定を一致させましょう。" />
ステップ 5:結果を正しく解釈する
結果を読み解く際は、p値だけでなく、その先を見る必要があります。有意なp値は、統計的に差が検出可能であることを示しますが、それが実務において十分に大きな意味を持つ差であるかどうかまでは教えてくれません。
ペアごとの差に注目する
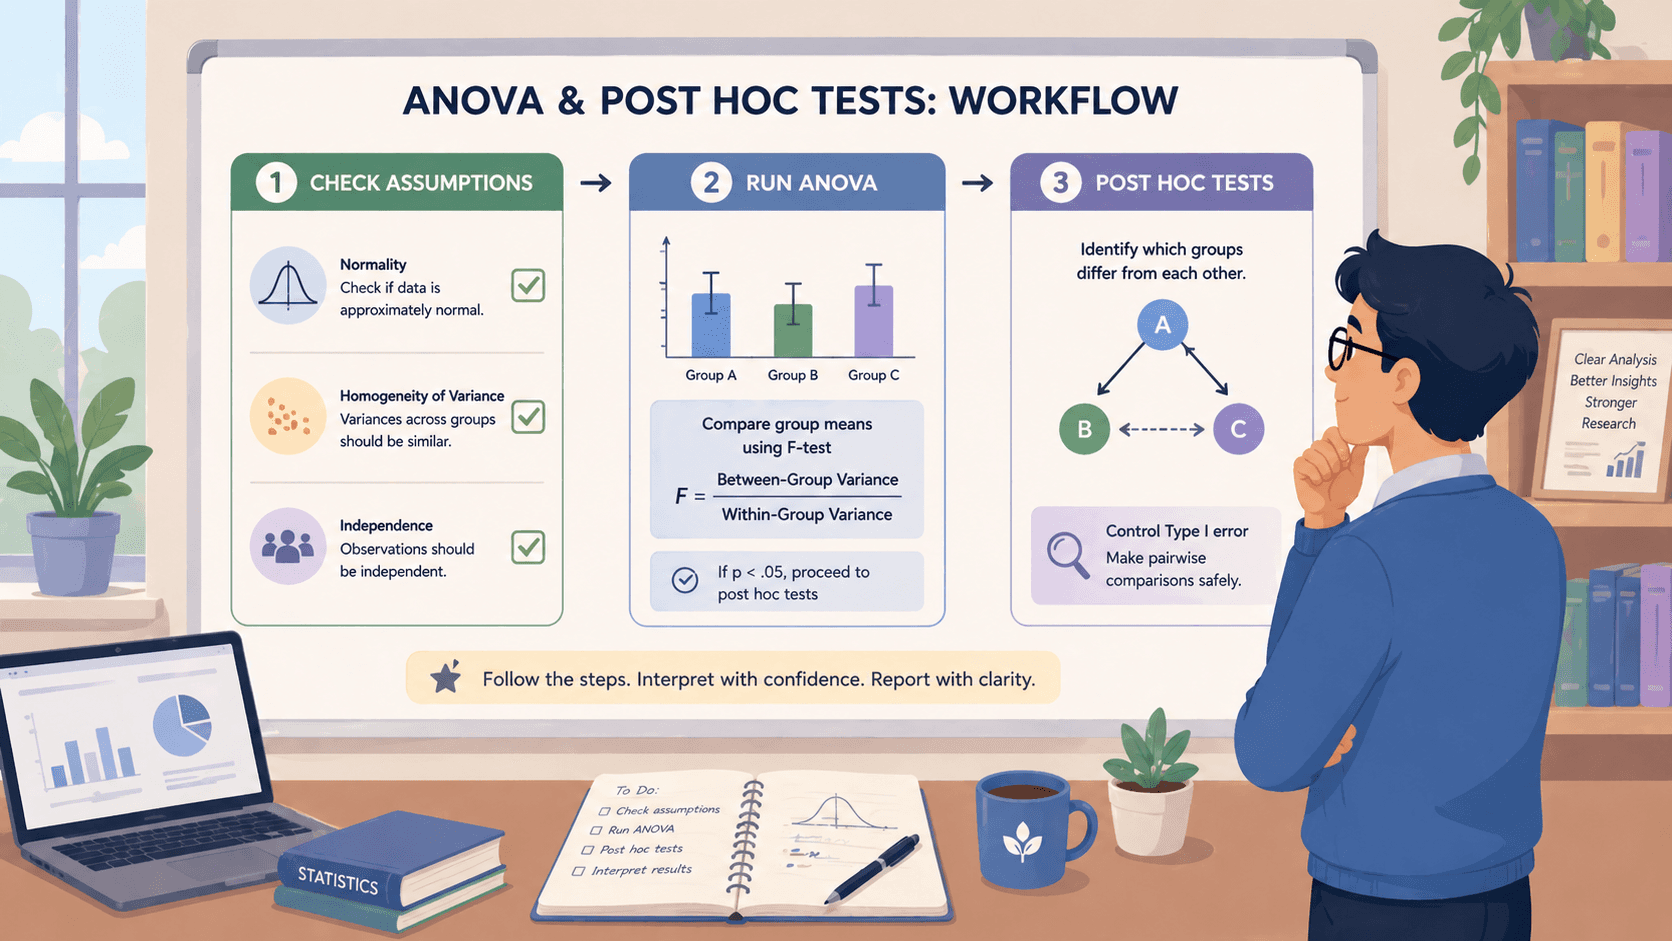
これが事後検定の核心的な出力です。どのグループ同士に違いがあるのかを正確に示します。結果は以下のようになることがあります:
グループA vs. グループB: p = .003 (有意)
グループA vs. グループC: p = .015 (有意)
グループB vs. グループC: p = .210 (有意ではない)
これは、グループAにおける処理の効果はBやCとは異なっていたものの、グループBとCの結果は同様であったことを示しています。
効果量を含める
たとえグループ間の実際の差が極めて小さくても、p値が有意になることがあります。効果量はその差の大きさを測定します。分散分析の一般的な指標は、 エータ二乗(η²) または 部分エータ二乗 です。
これらは、全分散のうちどの程度の割合が独立変数によって説明されているかを示します。非常に小さなη²を伴う有意なp値は、多くの場合、実質的な価値が低い発見であることを意味します。
信頼区間の重要性
常に平均値の差の信頼区間を確認してください。95%信頼区間(CI)は、2つのグループ平均の真の差が取り得る妥当な範囲を示します。区間が広い場合は、p値が有意であっても不確実性があることを示唆しています。
ゼロを含まない区間であれば有意であることが確認されますが、その境界線(上限・下限)は効果の潜在的な大きさを示し、p値単体よりもはるかに有用な情報を提供します。
ステップ 6:高度なANOVA設計に対応する
標準的な一元配置分散分析だけでは、すべての研究シナリオをカバーできません。より複雑な設計が一般的であり、特定のインプットやアプローチが必要となります。
反復測定分散分析(Repeated Measures ANOVA)
これは、治療の前、最中、後における患者の痛みレベルを測定するなど、同一の被験者グループを異なる条件下で複数回測定する場合に使用します。
ここでの重要な前提条件は 球形度(sphericity) であり、モークリー検定(Mauchly's test)で確認します。この検定で前提条件が満たされない場合は、自由度に補正を適用します。
主な2つの補正方法は、 グリーンハウス・ガイザー(Greenhouse-Geisser) (より保守的)と ハイン・フェルト(Huynh-Feldt) (やや保守性が低い)補正です。
混合分散分析モデル(Mixed ANOVA Models)
この設計は、同一の分析において「被験者間因子」と「被験者内因子」を混合させます。例えば、異なる2つのトレーニングプログラム(被験者間)を、4週間にわたる毎週の評価(被験者内)で比較する場合などです。
これは縦断的研究や、異なるグループ間での事前テスト・事後テスト設計を伴う実験において強力なツールとなります。
要因分散分析デザイン(Factorial ANOVA Designs)
要因分散分析は、2つ以上の独立変数(要因)がある場合に使用されます。例えば、2x2のデザインでは、要因Aの効果、要因Bの効果、そして極めて重要なAとBの間の 相互作用効果 を分析できます。
これにより、一方の変数の効果が他方の変数のレベルに依存しているかどうかを確認でき、データから最も興味深い知見が得られることがよくあります。
研究者がやりがちな典型的な間違い
問題は通常、理論を実践に移そうとするときに発生します。
物事を複雑にしすぎる
複雑すぎる研究デザインは、結果を曖昧にし、間違いを引き起こしやすくします。自分自身も含め、誰も本当には理解できないモデルに陥ってしまいがちです。
p値だけを見る
いくつかの論文では、結果セクションにp値を載せただけで終わらせてしまっています。これでは、その発見が実際に実務的な意味を持つかどうかについては、ほとんど何も伝わりません。
誤った事後検定の実行
最初の分散分析(ANOVA)で有意差がなかったにもかかわらず、適当に事後比較を繰り返してはいけません。また、都合の良い「有意な」結果を見つけるために、後からデータをあさる行為は悪習です。
前提条件を確認しない
これが最もよくある失敗かもしれません。正規性や等分散性などを検証しないと、分析全体が不安定な土台の上に成り立ってしまいます。
<ProTip title="🚀 戦略:" description="都合の良いデータを後から探す(データフィッシング)のを避けるため、ANOVAを実行する前に対比(コントラスト)を計画しておきましょう。" />
結果を迅速に理解する必要があるとき
出力結果を見つめながら何が重要なのかを理解しようとしても、数値が乱雑で説明しにくく感じられることがあります。混乱してしまうこともあるでしょう。明確なアプローチがなければ、自分の結果を疑ってしまったり、データが本当に語っていることを見落としたりしがちです。
<CTA title="統計ワークフローを強化する" description="ガイド付き執筆と構造化されたプロンプトを使用して、複雑な分析を明確な手順に変換します。" buttonLabel="Jenniを無料で試す" link="https://app.jenni.ai/register" />
そこでJenniが、物事を整理し、明確に伝わる形で提示するお手伝いをします。Jenniは、あなたの執筆活動や分析の説明をサポートし、研究結果に一貫性を持たせます。憶測に頼るのをやめ、より信頼でき、共有しやすい結果を持って自信を持って進められるようになります。